双旋网络
Hadoop学习笔记: 分布式数据库 HBase

HBase概述
HBase是一个构建在HDFS上的分布式列存储系统,是 生态系统中的重要一员,主要用于海量结构化数据存储。HBase是 的开源实现,从逻辑上讲,HBase将数据按照表、行和列进行存储,它是一个分布式的、稀疏的、持久化存储的多维度排序表。Hbase会把数据写到HDFS文件系统中。
HBase具有以下特点:1)良好的扩展性;2)读和写的强一致性;3)高可靠性,任何一个节点挂掉,都不会影响读写;4)与良好的集成。
HBase VS HDFS:1)HDFS适合批处理场景;2)HDFS不支持数据随机查找;3)HDFS不支持数据更新。
HBase VS Hive:1)Hive适合批处理数据分析场景;2)Hive不适合实时的数据访问。
HBase应用在360搜索的网页库、淘宝的商品库和淘宝数据魔方的交易信息。
HBase数据模型
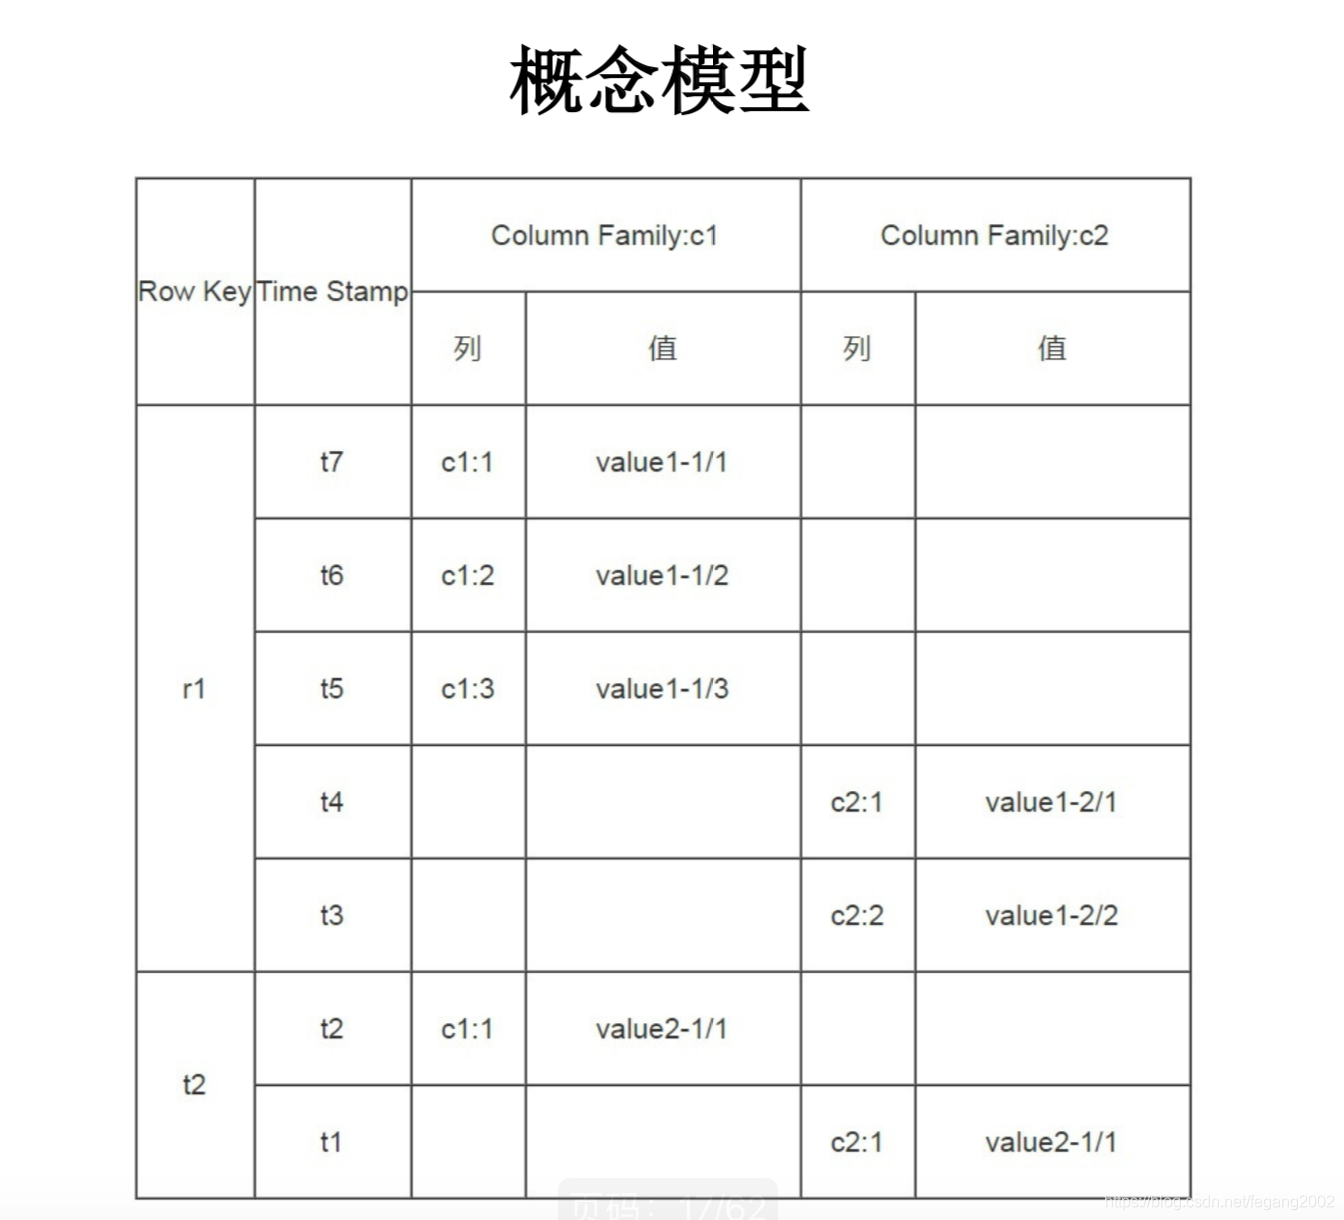
HBase由 (Table, , , , )确定Value。在HBase中,一行数据由行健()作为键,包含多个列族 (),列族是由具有同时访问特性的多个列()组成的。数据是可以具有多版本的,由时间戳()索引。时间戳和列的值绑定,如果一行所有的列都没有值,就不会有时间戳。
行键是主键Hadoop学习笔记: 分布式数据库 HBase,它是数据行在表中的唯一标识,表中的数据按照行键排序,所有操作都是基于主键的。表是稀疏的,空值不被存储,一行有可能会有几百万列,但是只有几十列有数据。每行都有一个可排序的主键和任意多的列,列可以根据需要动态的增加,同一张表中不同的行可以有截然不同的列。在HBase中只需要定义到列组,列组提前创建好后,列可以在写数据的时候动态的增加,理论上可以有无穷多列。
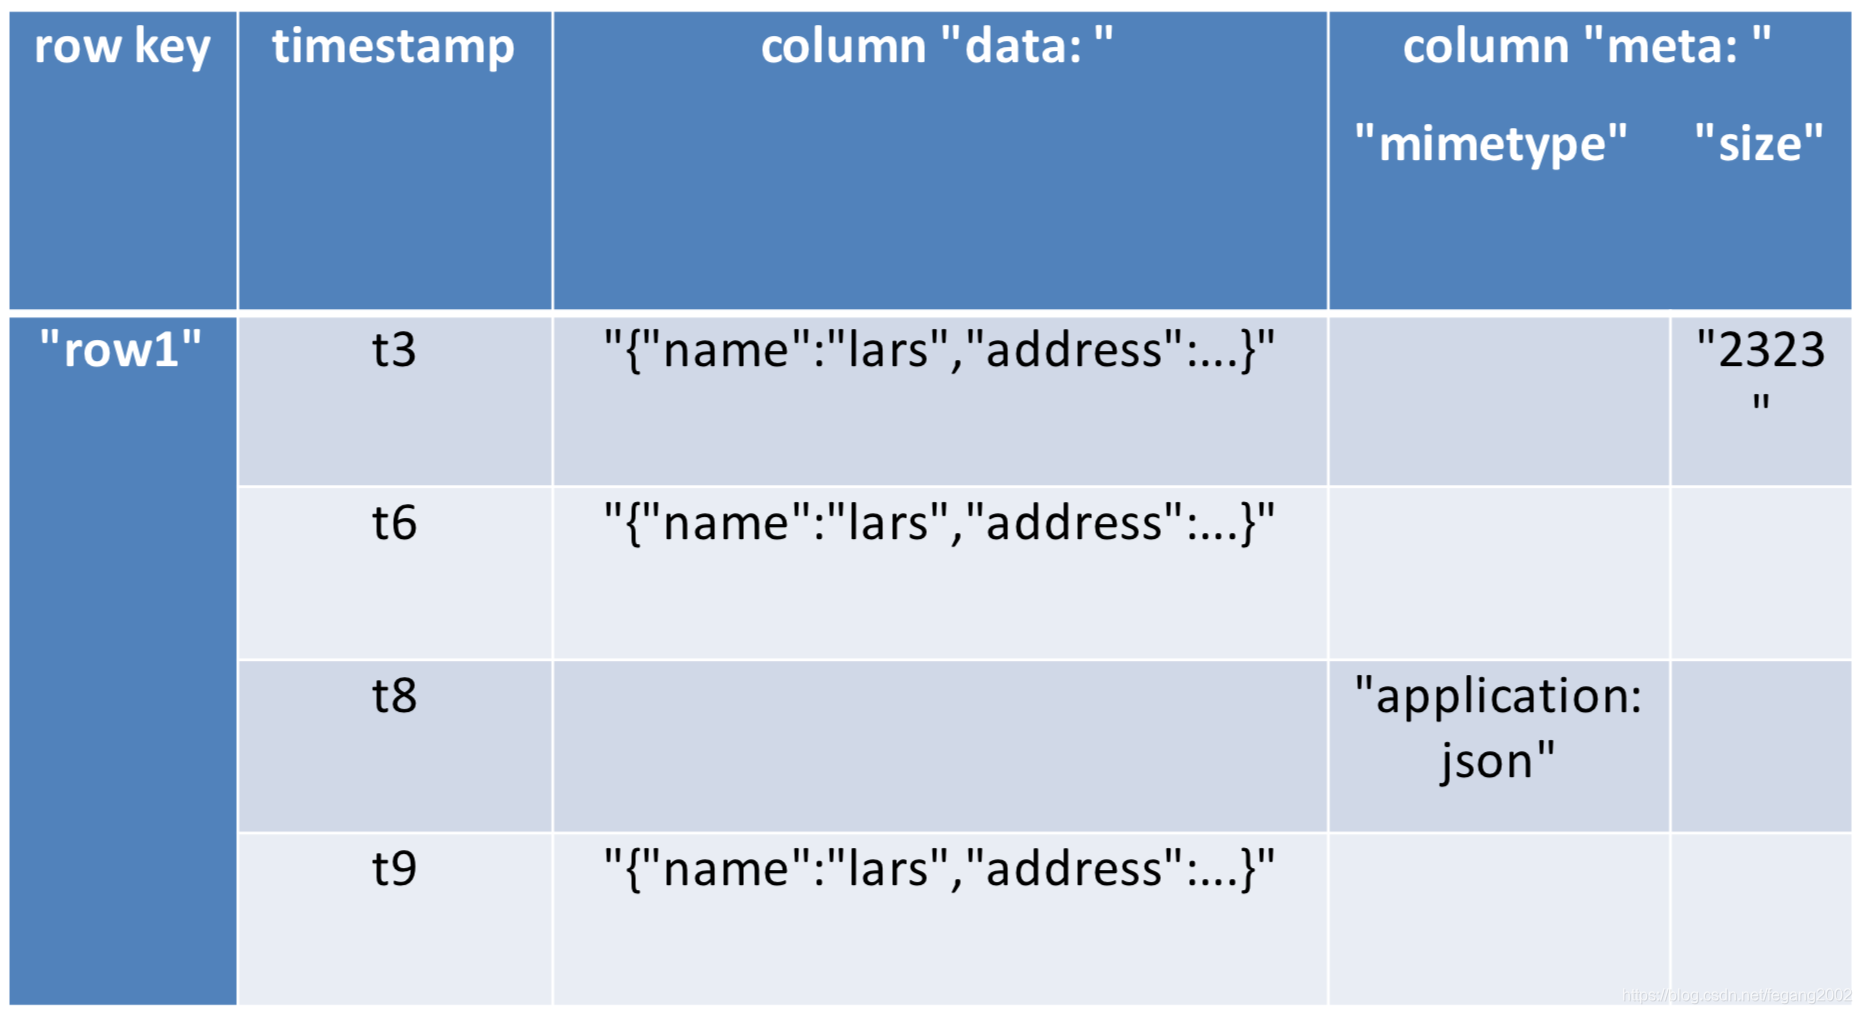
:row1
:data
:name
:t3
Value:lars
HBase数据模型具有以下特点:
1)大:一个表可以有数十亿行,上百万列,可以达到PB级;
2)面向列:面向列(族)的存储,列(族)独立检索;
3)稀疏:对于空(null)的列,并不占用存储空间,表可以设计的非常稀疏;
4)数据多版本:每个单元中的数据可以有多个版本,由时间戳实现;
5)数据类型单一:HBase中的数据都是字节型,没有其他类型,数据读出时由用户做类型转换成他们想要的类型。的排序也是按照字节排序。
行存储与列存储区别:
1)行存储数据是按行存储,没有索引的查询使用大量I/O,建立索引和物化视图需要花费大量时间和资源,行存更容易定位到一行数据,所以比较适合对事物的处理,面向查询的需求,数据库必须被大量膨胀才能满足性能要求;
2)列存储数据是按列存储,每一列单独存放,数据即是索引,当访问要查询的列时,可以大量降低系统I/O。数据类型一致,数据特征相似,可以高效压缩。每一列由一个线索来处理,支持查询的并发处理。列存更容易将所有相同的数据统计到一起,所以比较适合数据分析,一般分析的维度没有那么多,而又需要统计所有行的信息的时候,比较适合用列存,列存不容易定位一行数据。
HBase物理模型
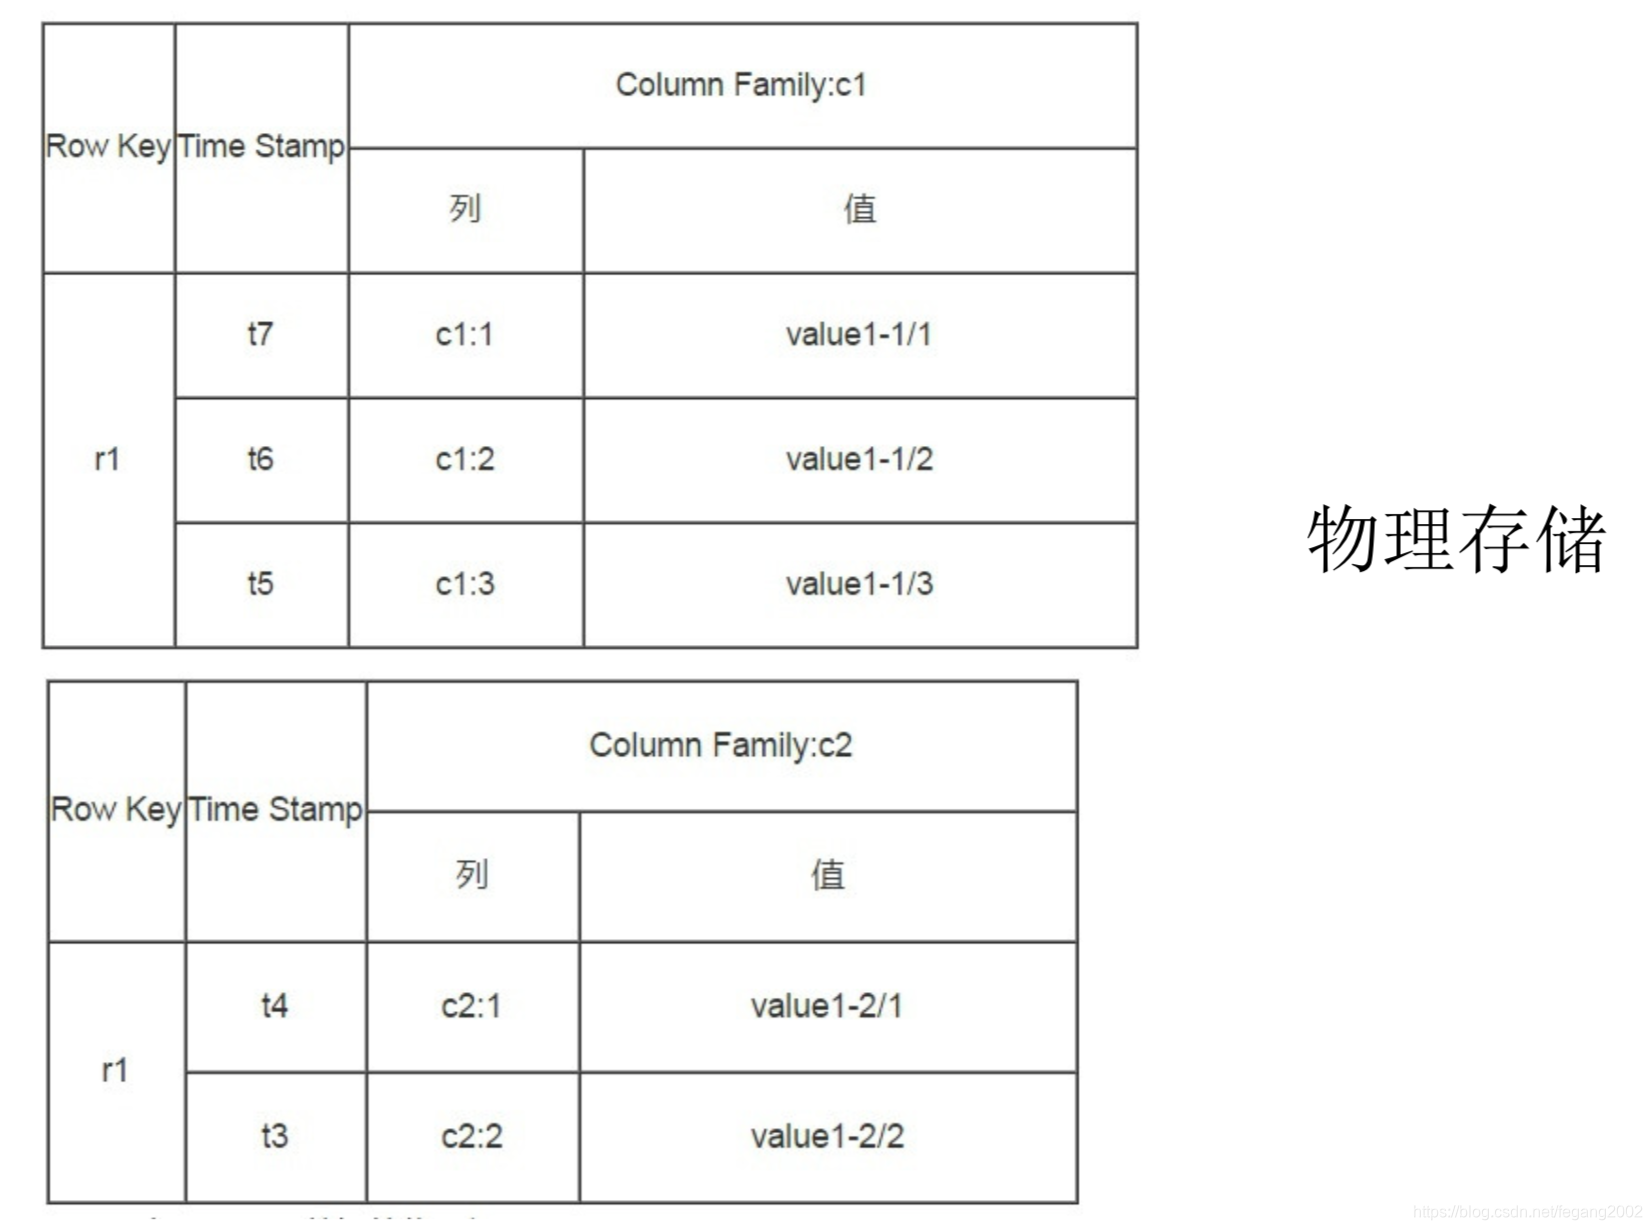
HBase面向列组存储。
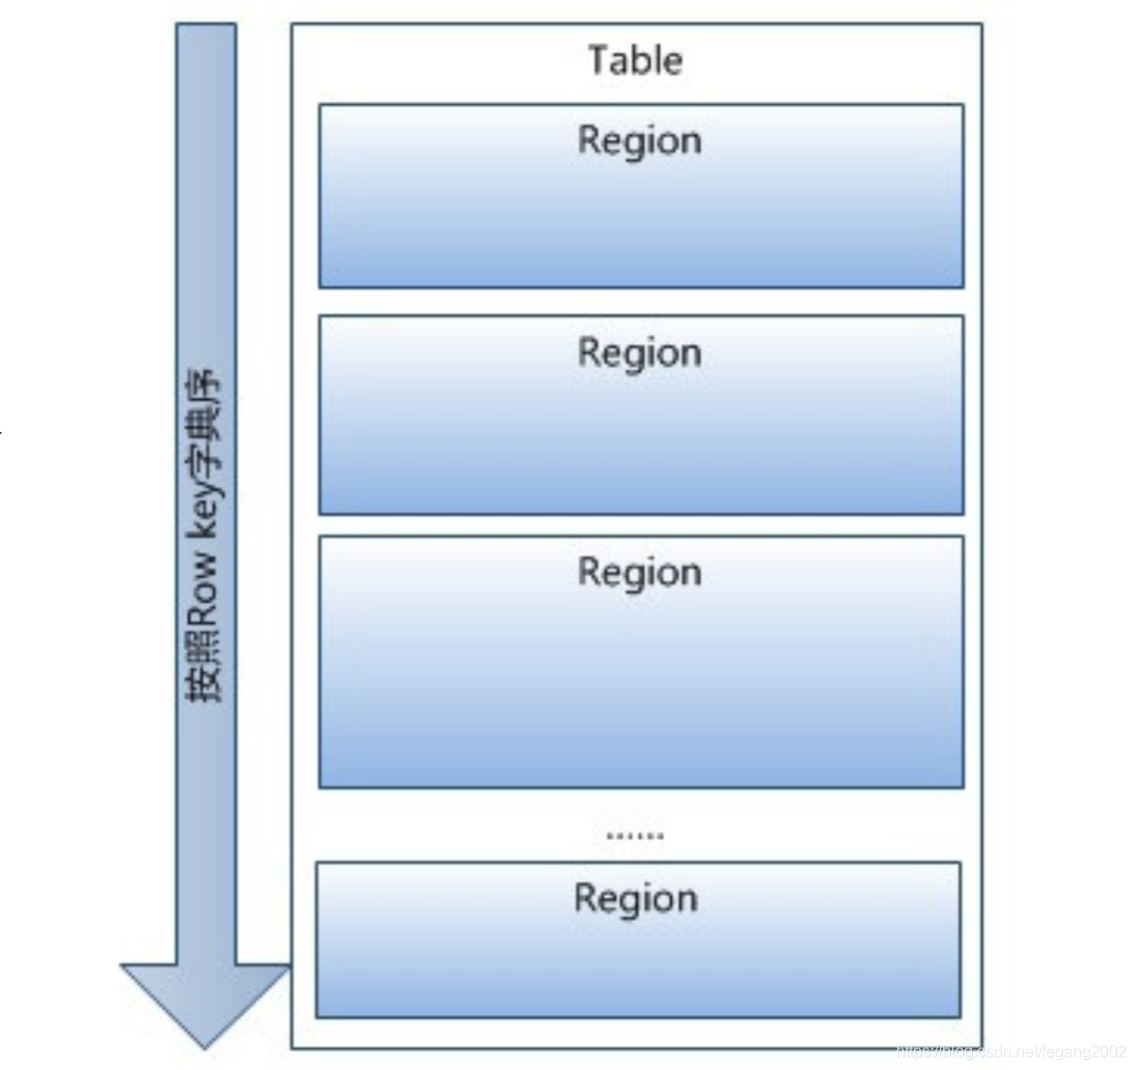
Table中的所有行都按照的字典序排列,Table 在行的方向上分割为多个。某个会包含某一个或几个,一个类似于一个行分组。行本身不可以按照列再划分,一个一般是1G-100G,如果一行的数据大于100G,那说明组织有问题。一行不能分为不同的。一个放到HDFS上会被再切分成128M的Block来存储。HBase对Table的切分,以及HDFS对Block的切分由内部处理机制完成,对外暴露的都是数据库表和文件。
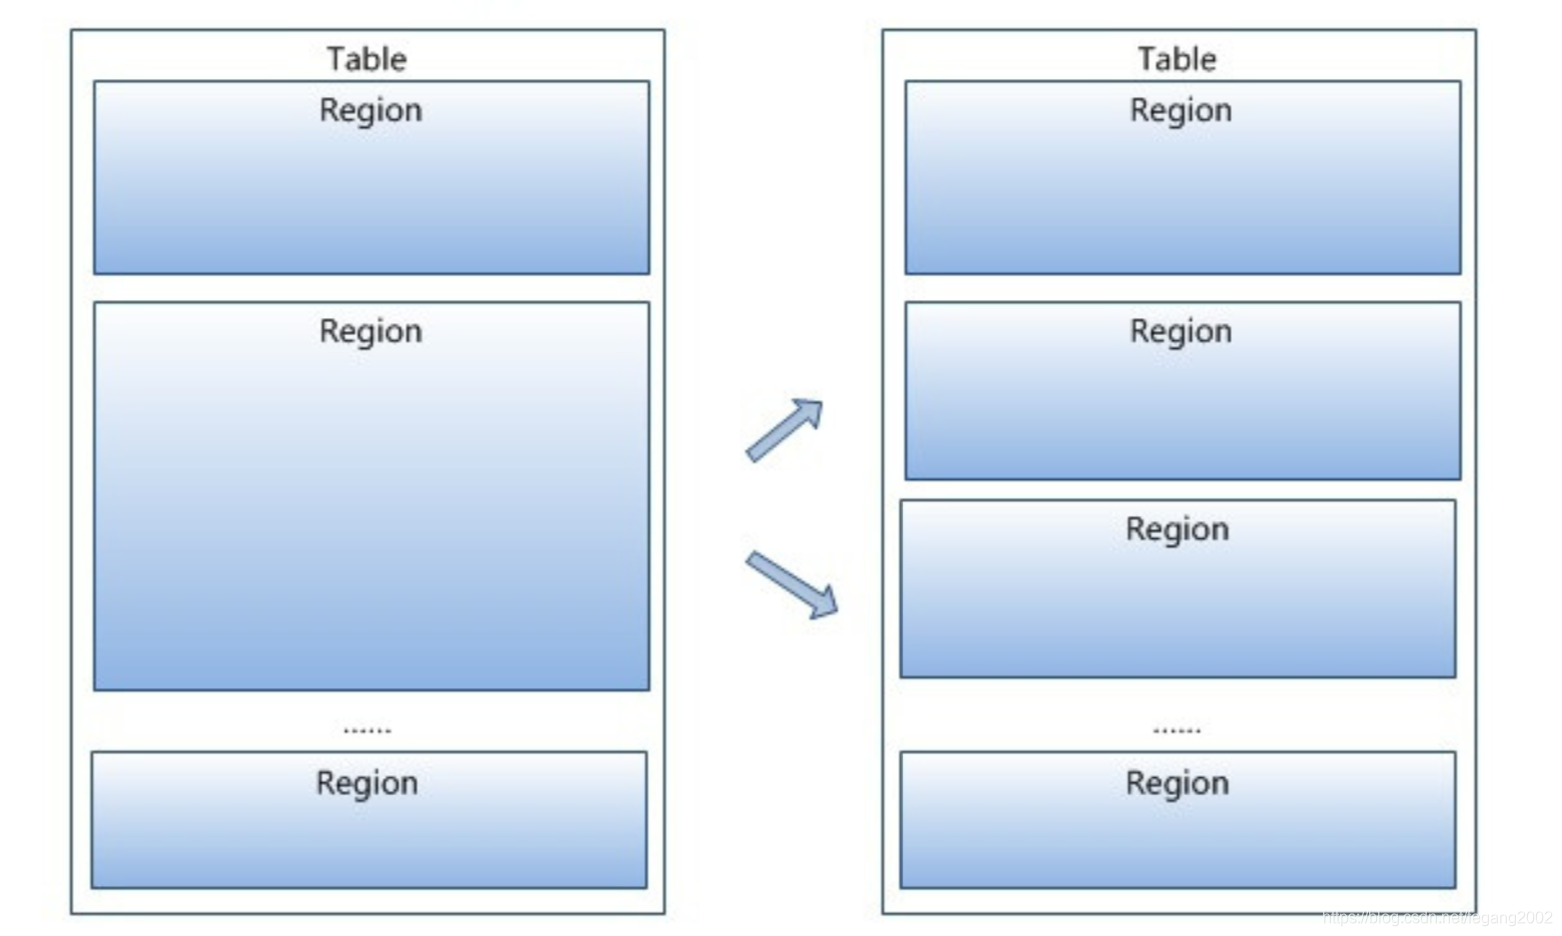
按大小分割的java create,每个表开始只有一个,随着数据增多不断增大,当增大到一个阀值的时候,就会等分为两个新的,之后会有越来越多的。也可以在建立Table的时候就建立多个。
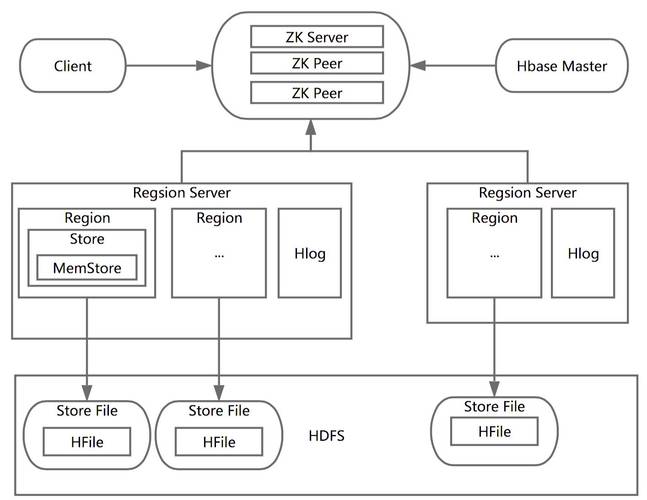
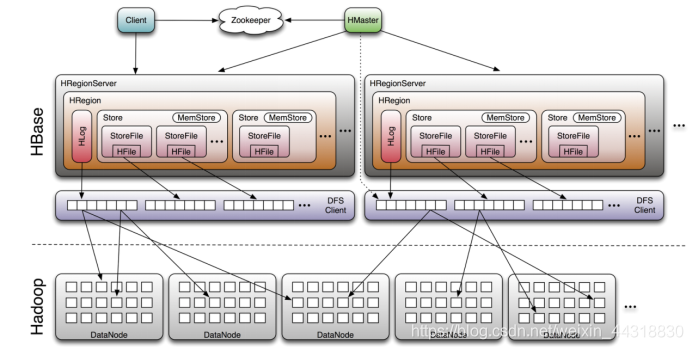
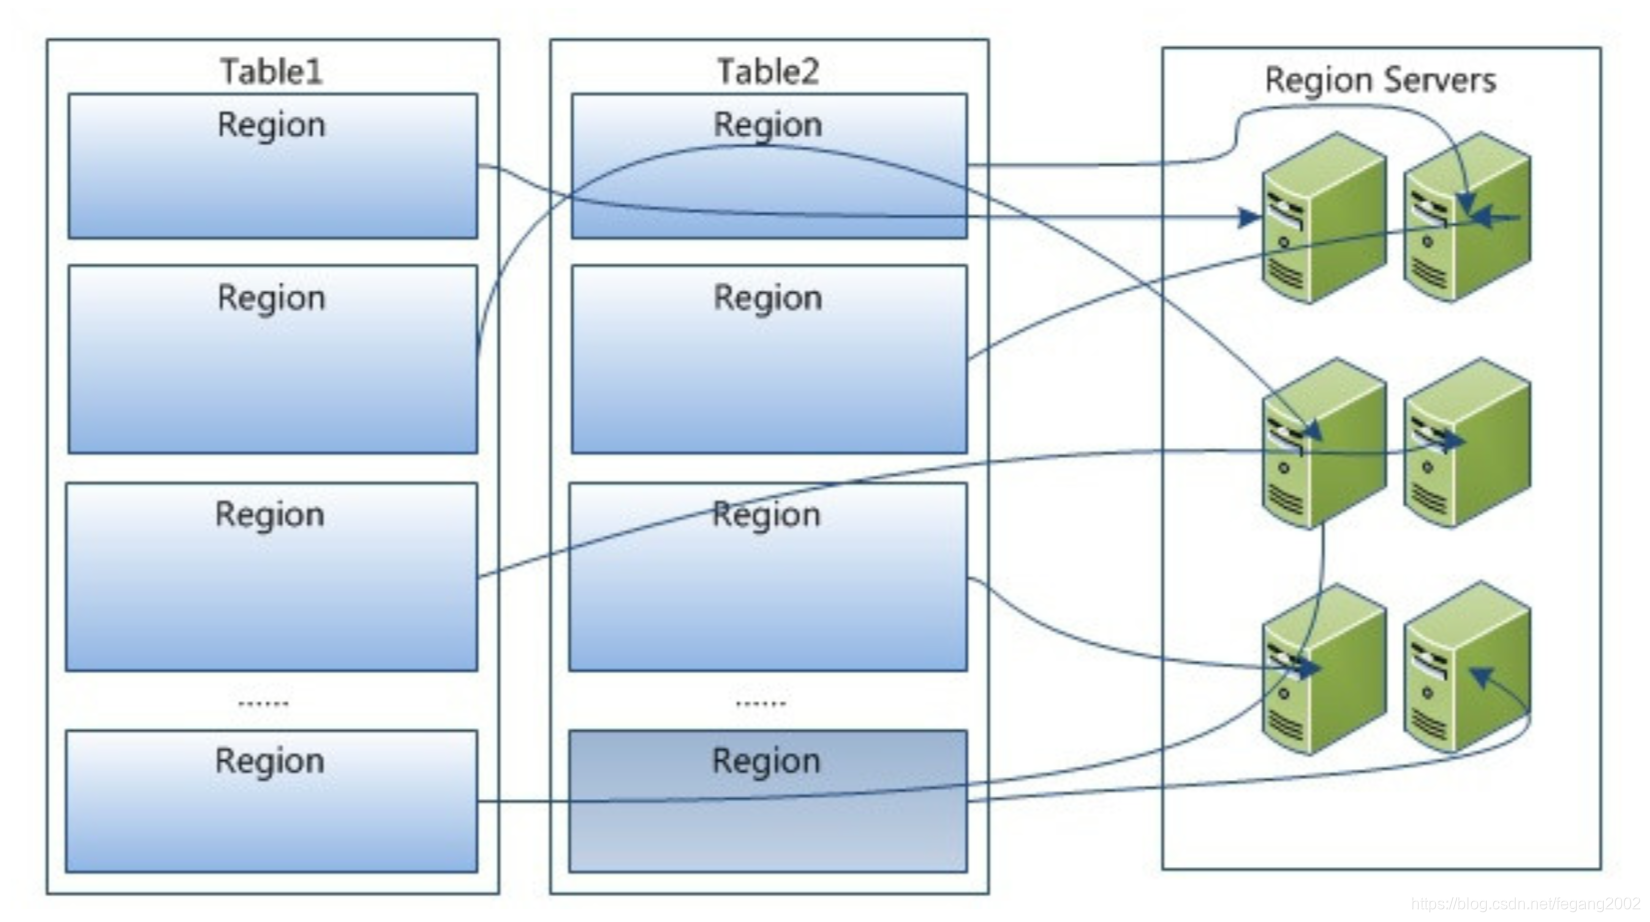
HBase把Table分割成不同的,再把随机分配到不同的机器( )上来实现分布式。是HBase中分布式存储和负载均衡的最小单元,不同分布到不同 上。
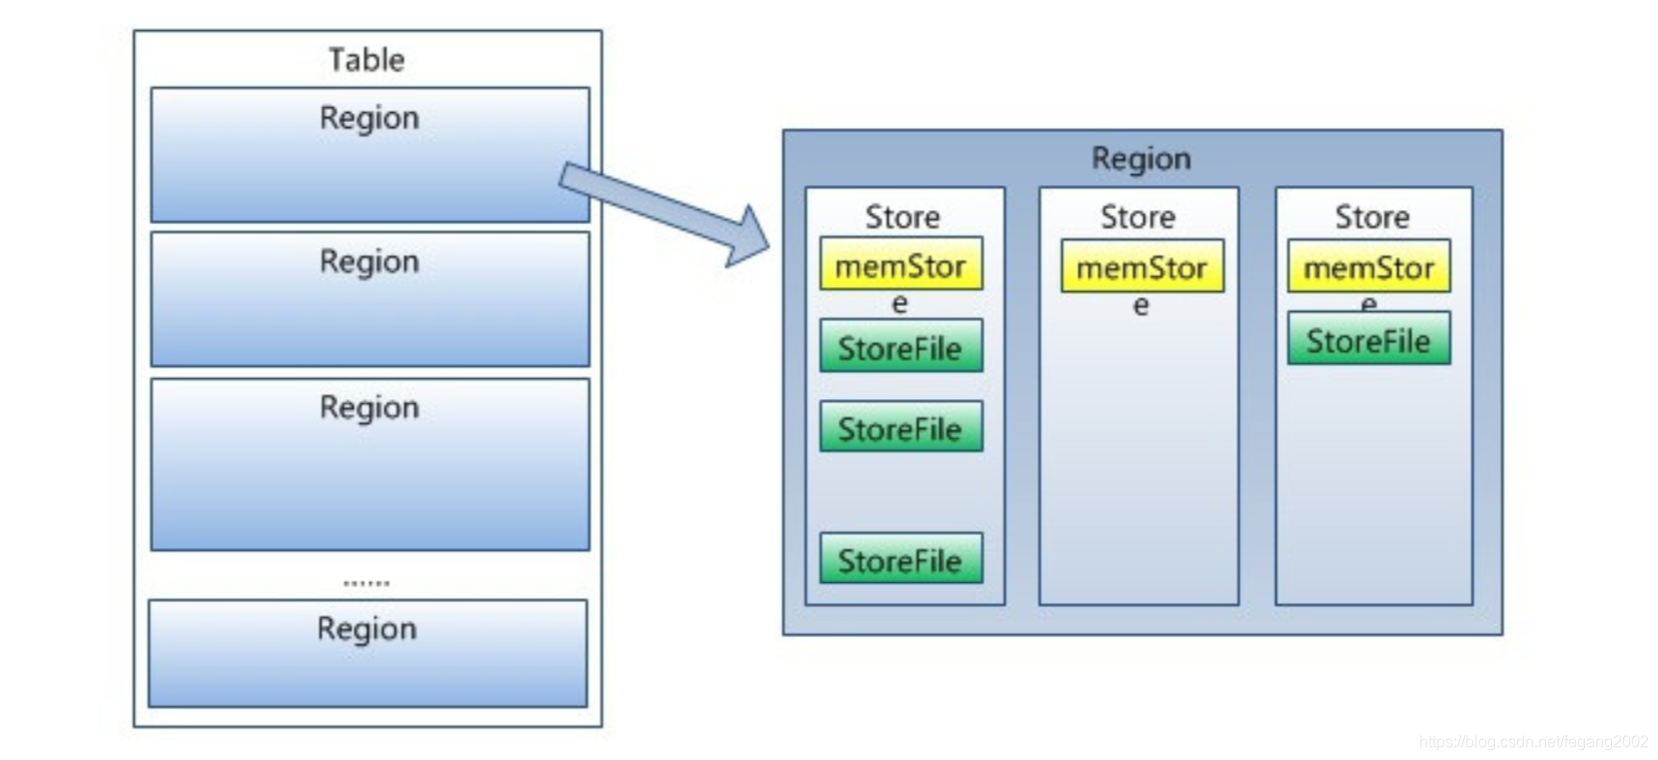
虽然是分布式存储的最小单元,但并不是存储的最小单元。由一个或者多个Store组成,每个Store保存一个 ;每个Store又由一个和0至多个组成,存储在内存中,存储在HDFS上。HBase写操作是先写到内存的中,在内存写到一定程度比如到128M或256M后再作为一个文件写入到磁盘中形成,每个文件一次写入。
HBase架构
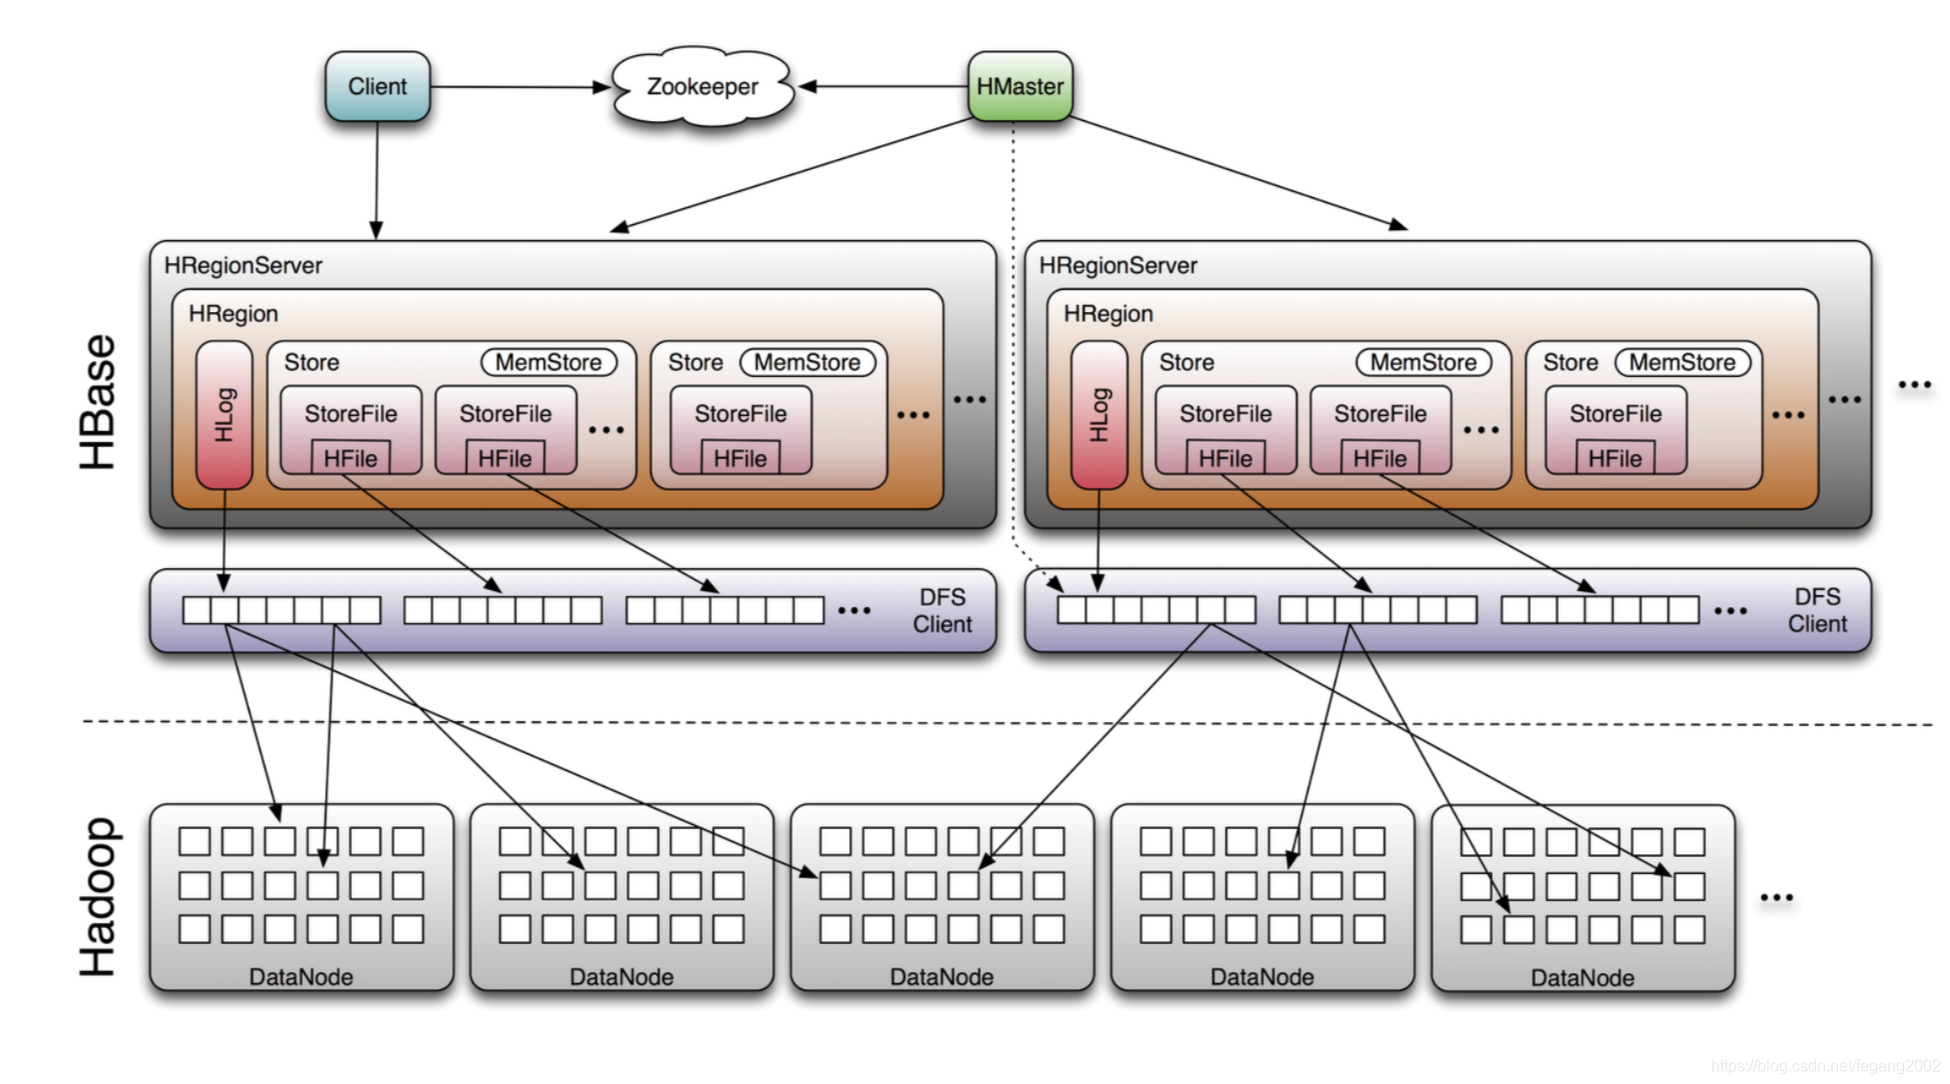
HBase数据寻址的原理是:
首先,HBase有一个Meta表,表里存储一个包括的Table的Start Key和End Key,存储在哪个上,这样Table名+名就可以确定数据以及从哪个取数据。Meta表本身也是HBase的一个表,也可能会被横向切分后放到一个中,但因为Meta表中存储的数据一般不多,所以大小一般不会超过1G,所以Meta表一般就存在一个上,Meta表的地址写到中。这样就会从中读取Meta表地址,然后再从Meta表中读取为某个值的数据的存放位置。客户端第一次读完Meta表的元数据后会缓存下来,这样以后再读就可以直接从缓存读了。一旦所在的变了,缓存失效,取数据出错,可以更新缓存,继续使用。
HBase数据修改的原理是:
HDFS上的文件是不支持修改的,但HBase是如何实现修改的?事实上HBase没有数据修改,都是新增,通过时间戳来标识哪些是最新的数据,数据读取的时候,HDFS返回最新时间戳的数据,这就实现了数据的修改。默认返回最新时间戳的数据,也可以指定返回哪个或哪几个时间戳的数据。HBase默认保留三个版本(时间戳),多余的会删除,保留的版本数可以配置。HBase会在HDFS上生成很多文件java create,定期会合并成一个大文件。
数据文件目录结构:Table名+名+ 名字+文件,所以不同的Table的数据不可能存到一个文件的。
HBase访问方式
2)建表:表名,有两个列族:‘grade’和‘’
> create 'scores', 'grade', 'course'
3)查看HBase中的表
> list
4) 查看表结构
> describe 'scores'
5) put: 写入数据
> put 't1', 'r1', 'c1', 'value', ts1
t1指表名,r1指行键(key)java create,c1指列名,value指值,ts1指数据戳( 一般都省略不设置)。
6)向表中插入数据
> put 'scores', 'Tom', 'grade', 5
> put 'scores', 'Tom', 'course:math', 97
> put 'scores', 'Tom', 'course:art', 87
> put 'scores', 'Jim', 'grade', 4
> put 'scores', 'Jim', 'course:math', 68
> put 'scores', 'Jim', 'course:science', 89
7)get: 随机查找数据
 >get 't1', 'r1'
>get 't1', 'r1', 'c1'
>get 't1', 'r1', 'c1', 'c2'
>get 't1', 'r1', {COLUMN => 'c1', TIMESTAMP => ts1}
>get 't1', 'r1', {COLUMN => 'c1', TIMERANGE => [ts1, ts2], VERSIONS => 4}
>get 'scores', 'Tom'
> get 'scores', 'Tom', 'grade'
> get 'scores', 'Tom', 'grade', 'course'
8)scan: 范围查找数据
 >scan 't1'
>scan 't1', {COLUMNS => 'c1:q1'}
>scan 't1', {COLUMNS => ['c1', 'c2'], LIMIT => 10, STARTROW => 'xyz'}
>scan 't1', {REVERSED => true}
> scan 'scores'
> scan 'scores',{COLUMNS =>'course:math'}
> scan 'scores',{COLUMNS =>'course'}
> scan 'scores',{COLUMNS =>'course', LIMIT => 1, STARTROW => 'Jim'}
9): 删除数据
>delete 't1', 'r1', 'c1', ts1
>delete 'scores', 'Jim', 'course:math'
10)删除全表数据
> truncate 'scores'
11)alter: 修改表结构
为表增加一个列族Hadoop学习笔记: 分布式数据库 HBase,名为
> alter 'scores', NAME => 'profile'
删除列族
> alter 'scores', NAME => 'profile', METHOD => 'delete'
12)删除表的步骤
先 Table,然后drop Table
> disable 'scores'
> drop 'scores'
参考链接:
HBase参考文档
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » Hadoop学习笔记: 分布式数据库 HBase

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码