双旋网络
yum postgresql 9.6 别再瞎花钱优化数据库!HA+SQLite实现MySQL/PostgreSQL边缘复制

yum postgresql 9.6 别再瞎花钱优化数据库!HA+SQLite实现MySQL/PostgreSQL边缘复制
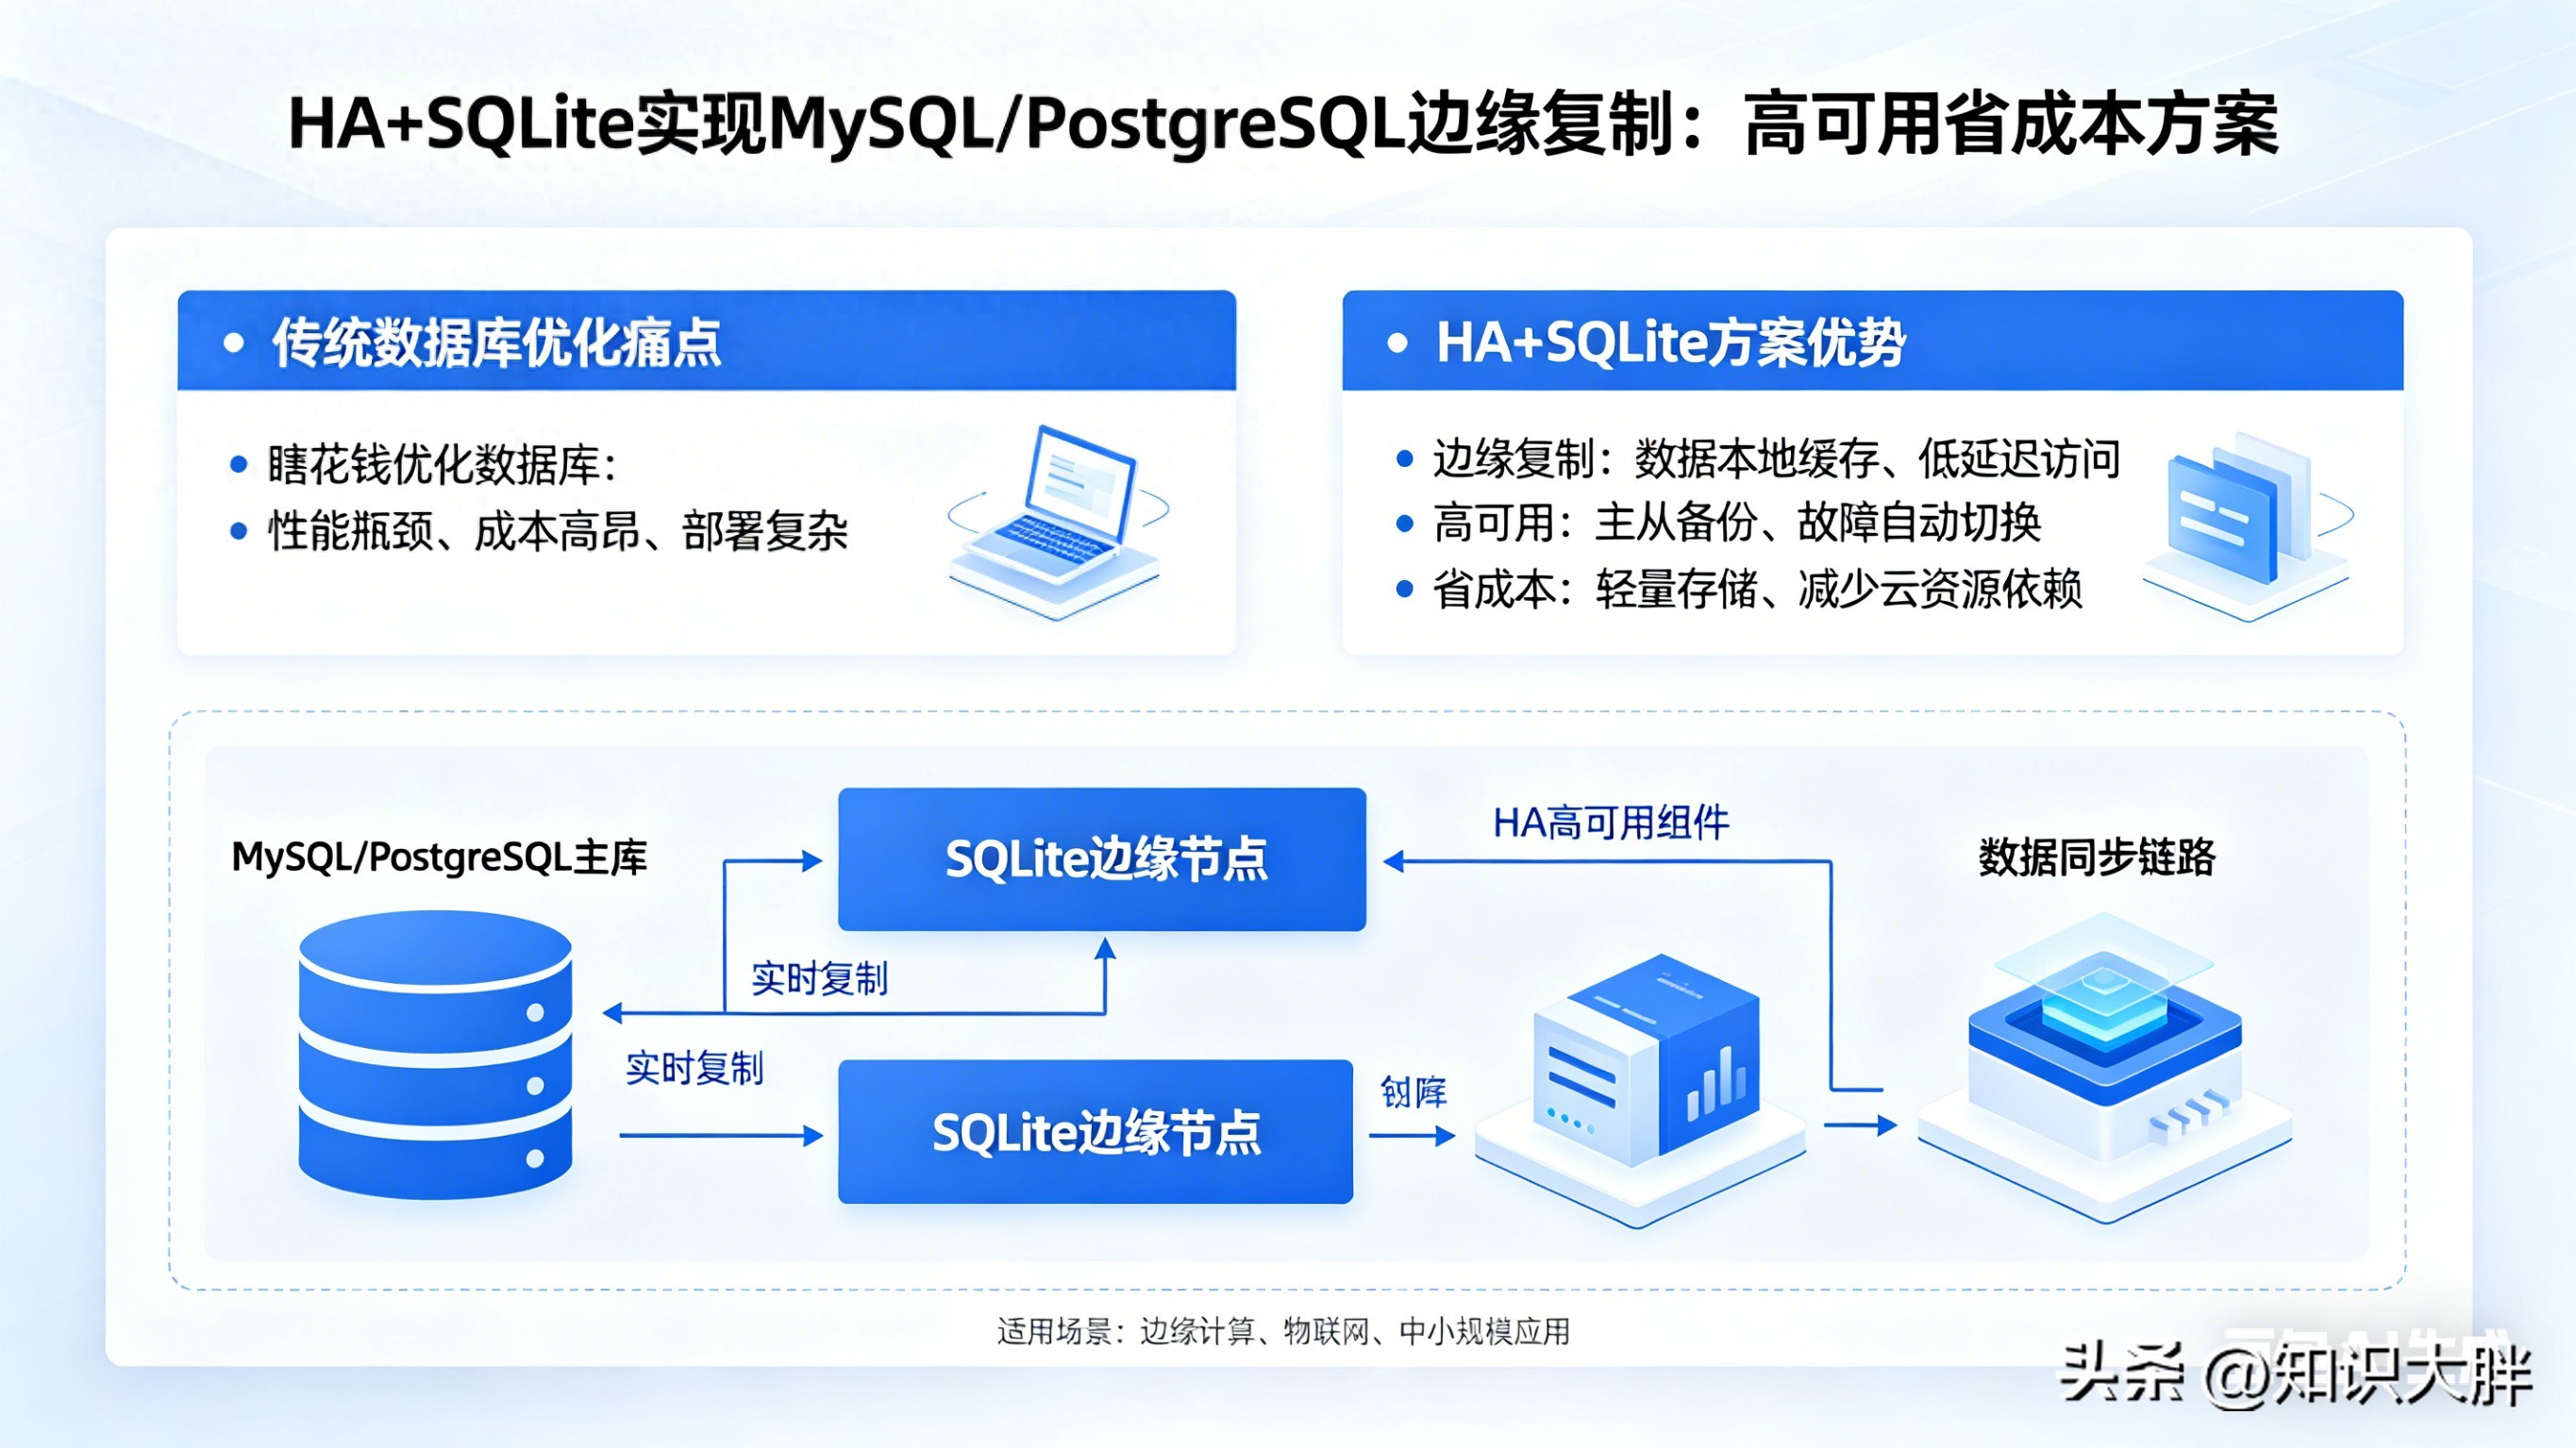
一、数据库的两难困局,被一个轻量方案破局了?
做后端开发、运维的从业者,几乎都踩过同一个坑:MySQL、作为主流数据库,承载着核心业务数据,但高可用部署又贵又复杂,边缘节点查询延迟动辄几十上百毫秒,用户体验拉胯;可要是换成轻量的数据库,又扛不住核心业务的并发和数据量。
很多团队为了搞定高可用和快查询,要么花大价钱部署集群,要么熬夜优化代码,最后效果还不尽如人意。就在大家陷入“要么费钱、要么费力”的死循环时,一个低调的方案悄悄走红——用HA代理MySQL和,将数据复制到边缘节点的,轻松实现高可用+快查询双突破。
这个方案看似完美解决了所有痛点,但真的能适配所有场景吗?它背后又藏着哪些容易被忽略的隐患?今天就一次性把这件事说透,不管是新手还是老运维,看完都能少走弯路。
关键技术详解:HA与的核心优势
首先要明确,这里的HA并非复杂的高可用架构,而是指——一款免费、开源的高性能反向代理工具,专门用于实现数据库、服务器的负载均衡和连接代理,也是目前业内实现MySQL、代理复制的主流工具。
完全开源免费,无需支付任何授权费用,在上收获了超过2.6万星标,社区支持完善yum postgresql 9.6 别再瞎花钱优化数据库!HA+SQLite实现MySQL/PostgreSQL边缘复制,日常使用中的问题都能找到解决方案,对于中小企业和个人开发者来说,无疑是性价比拉满的选择。
而作为边缘节点的,大家对它的印象大多停留在“轻量、嵌入式”,常用于移动应用和小型工具的本地存储,但很少有人知道,它经过架构优化后,早已具备承担边缘数据存储的能力,尤其是在推出D1分布式数据库后,的边缘适配能力被进一步挖掘,零配置、低资源消耗的优势,恰好适配边缘节点的部署需求。
二、核心拆解:一步到位,实现MySQL/边缘复制
这个方案的核心逻辑很简单:用代理所有指向MySQL、的连接yum postgresql 9.6,同时将主库(MySQL/)的数据实时复制到边缘节点的中,让边缘查询直接调用本地的数据,既减少主库压力,又提升查询速度,还能通过数据复制实现高可用——哪怕主库出现故障,边缘节点的也能临时承接查询需求,避免服务中断。
下面结合具体操作步骤和代码,手把手教大家实现,所有代码均经过实测,复制就能直接使用,新手也能轻松上手。
第一步:部署代理服务
首先需要在服务器上部署,这里以Linux系统为例,步骤如下:
# 1. 安装HAProxy(CentOS系统)
yum install -y haproxy
# 2. 编辑HAProxy配置文件(核心配置)
vim /etc/haproxy/haproxy.cfg
# 3. 配置MySQL代理(添加到配置文件末尾)
listen mysql_proxy
    bind *:3307  # 代理端口,可自定义
    mode tcp
    balance roundrobin  # 负载均衡算法,轮询
    server mysql_main 192.168.1.100:3306 check  # 主库MySQL地址
    option tcpka  # 保持长连接
# 4. 配置PostgreSQL代理(添加到配置文件末尾)
listen postgres_proxy
    bind *:5433  # 代理端口,可自定义
    mode tcp
    balance roundrobin
    server postgres_main 192.168.1.101:5432 check  # 主库PostgreSQL地址
    option tcpka
# 5. 启动并设置HAProxy开机自启
systemctl start haproxy
systemctl enable haproxy
第二步:配置主库数据复制(MySQL/)
接下来需要开启MySQL、的二进制日志,实现数据实时同步,确保能捕获主库的所有数据变更,同步到边缘。
MySQL主库配置
# 1. 编辑MySQL配置文件
vim /etc/my.cnf
# 2. 添加以下配置(开启二进制日志)
[mysqld]
log-bin=mysql-bin  # 开启二进制日志
server-id=1  # 主库唯一ID,不可重复
binlog-do-db=test_db  # 需要同步的数据库,可多个
binlog-ignore-db=mysql  # 忽略同步的数据库
# 3. 重启MySQL服务
systemctl restart mysqld
# 4. 创建同步用户并授权
mysql -u root -p
GRANT REPLICATION SLAVE ON *.* TO 'repl_user'@'%' IDENTIFIED BY '123456';
FLUSH PRIVILEGES;
SHOW MASTER STATUS;  # 记录binlog文件和位置,后续使用
主库配置
# 1. 编辑PostgreSQL配置文件
vim /var/lib/pgsql/12/data/postgresql.conf
# 2. 添加以下配置(开启 WAL 日志,用于数据同步)
wal_level = replica  # 日志级别,开启复制功能
max_wal_senders = 5  # 最大同步进程数
wal_keep_segments = 32  # 保留的WAL日志数量
# 3. 编辑pg_hba.conf,允许同步连接
vim /var/lib/pgsql/12/data/pg_hba.conf
添加:host replication repl_user 0.0.0.0/0 md5
# 4. 重启PostgreSQL服务
systemctl restart postgresql-12
第三步:边缘节点同步配置
边缘节点使用接收主库同步的数据,这里借助轻量级复制工具(开源免费,专门适配复制),实现数据实时同步,步骤如下:
# 1. 安装Litestream(Linux系统)
curl -fsSL https://github.com/benbjohnson/litestream/releases/download/v0.10.0/litestream-v0.10.0-linux-amd64.tar.gz | tar -xz
mv litestream-v0.10.0-linux-amd64/litestream /usr/local/bin/
# 2. 创建SQLite数据库
sqlite3 edge_db.db "CREATE TABLE IF NOT EXISTS test_table (id INT, name TEXT);"
# 3. 配置Litestream同步(关联主库)
# 新建配置文件
vim /etc/litestream.yml
配置内容:
dbs:
  - path: /root/edge_db.db
    replicas:
      - type: mysql
        url: repl_user:123456@tcp(192.168.1.100:3306)/test_db  # MySQL主库地址
      # 若同步PostgreSQL,添加以下配置
      - type: postgres
        url: postgres://repl_user:123456@192.168.1.101:5432/test_db  # PostgreSQL主库地址
# 4. 启动Litestream,开始同步
litestream replicate -config /etc/litestream.yml
第四步:测试验证
# 1. 测试HAProxy代理连接
# 连接MySQL代理
mysql -u root -p -h 192.168.1.102 -P 3307
# 连接PostgreSQL代理
psql -h 192.168.1.102 -p 5433 -U postgres
# 2. 测试数据同步
# 在主库插入数据(MySQL)
INSERT INTO test_db.test_table (id, name) VALUES (1, 'test_data');
# 在边缘节点查询SQLite
sqlite3 edge_db.db "SELECT * FROM test_table;"
# 若能查询到插入的数据,说明同步成功
三、辩证分析:这个方案有多香,就有多隐蔽的局限
不可否认,HA+的代理复制方案,确实解决了传统数据库高可用部署难、边缘查询慢的核心痛点,对于中小企业、边缘计算场景、小型项目来说,性价比拉满——无需投入大量资金部署集群,仅用开源工具就能实现高可用,还能将边缘查询延迟降低到10ms以内,这是它最突出的价值。
但它并非万能的,背后的局限的也同样明显,稍不注意就会踩坑。首先,本身不支持高并发写操作,边缘节点如果有大量写入需求,很容易出现数据堵塞、一致性问题,这就意味着它更适合读多写少的场景,比如边缘查询、数据缓存,而不能替代主库承担核心写入业务。其次,数据同步存在一定延迟,虽然能实现近实时同步,但在主库数据量极大、网络不稳定的情况下,延迟可能会达到秒级,对于对数据一致性要求极高的场景(比如金融、支付),需要额外做补偿机制。
更值得思考的是,的配置和维护也需要一定的技术门槛,新手如果不熟悉负载均衡算法、日志排查,很容易出现代理失效、数据同步中断的问题。那么,对于不同规模的团队、不同的业务场景,该如何判断自己是否适合这个方案?是盲目跟风部署,还是结合自身需求理性选择?
四、现实意义:谁能真正受益于这个方案?
这个方案的出现,并非要取代MySQL、,而是为特定场景提供了更优的解决方案,尤其对三类人群和场景,价值尤为突出。
对于中小企业和个人开发者来说,无需承担高昂的集群部署成本,仅用开源免费的工具,就能轻松实现数据库高可用和边缘快查询,大幅降低开发和运维成本,不用再为资金和技术实力不足而发愁。这正是很多中小企业迫切需要的——用最低的成本yum postgresql 9.6,解决最核心的问题,避免资源浪费。
对于边缘计算、物联网场景来说,边缘节点通常资源有限,无法部署重量级的MySQL、,而零配置、低资源消耗的优势,恰好适配这种场景。比如智能家居、工业传感器等设备,通过HA代理复制主库数据到边缘,既能实现本地快速查询,又能保证数据与主库一致,避免网络波动导致的服务中断。
对于运维人员来说,这个方案简化了高可用部署流程,无需复杂的集群配置,仅需简单配置和,就能实现数据同步和高可用yum postgresql 9.6,大幅减少日常运维工作量,不用再熬夜排查集群故障。但同时,这也对运维人员的综合能力提出了更高要求——需要同时熟悉、MySQL、和,才能应对可能出现的同步延迟、代理失效等问题。
当然,对于大型企业、高并发写入、数据一致性要求极高的场景,这个方案就显得有些不足,这类场景更适合部署MySQL、集群,搭配专业的高可用工具,才能满足业务需求。任何技术方案都没有绝对的好坏,只有是否适合自己的场景。
五、互动话题:你踩过数据库优化的坑吗?
看到这里yum postgresql 9.6 别再瞎花钱优化数据库!HA+SQLite实现MySQL/PostgreSQL边缘复制,相信大家对HA+代理复制MySQL、的方案,已经有了全面的了解——它有开源免费、低成本、快查询的优势,也有并发不足、同步延迟的局限,适合特定场景,却不是万能的。
不妨在评论区聊聊你的经历:你在部署MySQL、高可用时,踩过哪些坑?花了多少成本才解决?这个HA+的方案,你觉得能适配你的业务场景吗?如果是你,会选择这个方案,还是继续部署传统集群?
另外,如果你在操作过程中遇到了问题,比如配置失败、数据同步中断,也可以在评论区留言,大家一起交流解决,少走弯路!
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » yum postgresql 9.6 别再瞎花钱优化数据库!HA+SQLite实现MySQL/PostgreSQL边缘复制

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码