双旋网络
33款可用来抓数据的开源爬虫软件工具

33款可用来抓数据的开源爬虫软件工具
要玩大数据,没有数据怎么玩?这里推荐一些33款开源爬虫软件给大家。
爬虫,即网络爬虫,是一种自动获取网页内容的程序。是搜索引擎的重要组成部分,因此搜索引擎优化很大程度上就是针对爬虫而做出的优化。
网络爬虫是一个自动提取网页的程序,它为搜索引擎从万维网上下载网页,是搜索引擎的重要组成。传统爬虫从一个或若干初始网页的URL开始,获得初始网页上的URL,在抓取网页的过程中,不断从当前页面上抽取新的URL放入队列,直到满足系统的一定停止条件。聚焦爬虫的工作流程较为复杂,需要根据一定的网页分析算法过滤与主题无关的链接,保留有用的链接并将其放入等待抓取的URL队列。然后,它将根据一定的搜索策略从队列中选择下一步要抓取的网页URL,并重复上述过程,直到达到系统的某一条件时停止。另外,所有被爬虫抓取的网页将会被系统存贮,进行一定的分析、过滤,并建立索引,以便之后的查询和检索;对于聚焦爬虫来说,这一过程所得到的分析结果还可能对以后的抓取过程给出反馈和指导。
世界上已经成型的爬虫软件多达上百种33款可用来抓数据的开源爬虫软件工具,本文对较为知名及常见的开源爬虫软件进行梳理,按开发语言进行汇总。虽然搜索引擎也有爬虫,但本次我汇总的只是爬虫软件,而非大型、复杂的搜索引擎,因为很多兄弟只是想爬取数据,而非运营一个搜索引擎。
Java爬虫
1.
是一个基于Java的web 框架.它包含一个简单的HTML剖析器能够分析包含HTML内容的输入流.通过实现的子类就能够开发一个简单的Web 并能够在Web站上的每个页面被解析之后增加几行代码调用。 的下载包中包含两个应用程序例子用于演示如何使用该框架。
特点:微型爬虫框架,含有一个小型HTML解析器
许可证:GPL
2、
是一个帮你轻松建立搜索引擎的自由软件,有了它,你就不用依靠商业公司的搜索引擎,也不用再烦恼公司內部网站资料索引的问题。
由 nutch 专案为核心,并整合更多相关套件,并卡发设计安装与管理UI,让使用者更方便上手。
除了爬取基本的 html 外,还能分析网页上的文件,如( doc、pdf、ppt、ooo、rss )等多种文件格式,让你的搜索引擎不只是网页搜索引擎,而是网站的完整资料索引库。
拥有中文分词能力,让你的搜索更精准。
的特色与目标,最主要就是提供使用者一个方便好用易安裝的搜索平台。
授权协议: 2
开发语言: Java SHELL
操作系统: Linux
特点:安装简易,拥有中文分词功能
3、Ex-
Ex- 是一个网页爬虫,采用 Java 开发,该项目分成两部分,一个是守护进程,另外一个是灵活可配置的 Web 爬虫。使用数据库存储网页信息。
特点:由守护进程执行,使用数据库存储网页信息
4、
是一个由 java 开发的、开源的网络爬虫,用户可以使用它来从网上抓取想要的资源。其最出色之处在于它良好的可扩展性,方便用户实现自己的抓取逻辑。
采用的是模块化的设计,各个模块由一个控制器类(类)来协调,控制器是整体的核心。
代码托管:
特点:严格遵照文件的排除指示和META 标签
5、heyDr
heyDr是一款基于java的轻量级开源多线程垂直检索爬虫框架,遵循GNU GPL V3协议。
用户可以通过heyDr构建自己的垂直资源爬虫,用于搭建垂直搜索引擎前期的数据准备。
特点:轻量级开源多线程垂直检索爬虫框架
6、
是一个java web (web机器人,爬虫)开源项目。支持通过下载模板和正则表达式来定义下载规则。提供一个swing GUI操作界面。
特点:提供swing GUI操作界面
7、
是一款小巧性能优良的的web爬虫,它可以从网页抓取各种类型的文件,基于用户定义的符号,比如email,qq.
特点:轻量、性能优良,可以从网页抓取各种类型的文件
8、
是一个用Java实现的,的执行格式如下:
URL一定要加上协议名称,如:http://,否则会报错。如果省掉,则采用默认配置。
的行为是由配置文件具体配置的,比如采用什么插件,结果存储方式等等都在conf
目录下设置。默认的配置种类 很少,用途也不大。但是非常容易扩展,可以利用它开发强大的网页抓取与数据分析工具。要做到这些33款可用来抓数据的开源爬虫软件工具,需要对的原理有深入的了 解,然后根据自己的需求开发插件,撰写配置文件。
特点:功能强大,容易扩展
9、
用JAVA编写的web 搜索和爬虫,包括全文和分类垂直搜索,以及分词系统
特点:包括全文和分类垂直搜索,以及分词系统
10、
是一套完整的网页内容抓取、格式化、数据集成、存储管理和搜索解决方案。
网络爬虫有多种实现方法,如果按照部署在哪里分,可以分成:
服务器侧:
一般是一个多线程程序,同时下载多个目标HTML,可以用PHP, Java, (当前很流行)等做,可以速度做得很快,一般综合搜索引擎的爬虫这样做。但是,如果对方讨厌爬虫,很可能封掉你的IP,服务器IP又不容易 改,另外耗用的带宽也是挺贵的。建议看一下 soap。
客户端:
一般实现定题爬虫,或者是聚焦爬虫,做综合搜索引擎不容易成功,而垂直搜诉或者比价服务或者推荐引擎,相对容易很多,这类爬虫不是什么页面都 取的,而是只取你关系的页面,而且只取页面上关心的内容,例如提取黄页信息,商品价格信息,还有提取竞争对手广告信息的,搜一下Spyfu,很有趣。这类 爬虫可以部署很多,而且可以很有侵略性,对方很难封锁。
中的网络爬虫就属于后者。
工具包利用平台的能力,只要是看到的东西,它都能提取。
工具包是免费使用的,下载地址:
/cn/node//front
特点:网页抓取、信息提取、数据抽取工具包,操作简单
11、
是一个采用java技术,综合应用多个开源java组件实现的网页抓取工具,通过XML配置文件实现高度可定制性与可扩展性的网页抓取工具
应用开源jar包包括(内容读取),dom4j(配置文件解析),(html解析),已经在 war包的lib下。
这个项目目前还很不成熟,但是功能基本都完成了。要求使用者熟悉XML,熟悉正则表达式。目前通过这个工具可以抓取各类论坛,贴吧,以及各类CMS系统。像!,phpbb,论坛跟博客的文章,通过本工具都可以轻松抓取。抓取定义完全采用XML,适合Java开发人员使用。
使用方法:
下载右边的.war包导入到中,
使用/sql下的wcc.sql文件建立一个范例数据库,
修改src包下wcc.core的.txt,将用户名与密码设置成你自己的mysql用户名密码。
然后运行,运行时候会在控制台,无参数会执行默认的.xml的配置文件,带参数时候名称为配置文件名。
系统自带了3个例子,分别为baidu.xml抓取百度知道java spider爬虫,.xml抓取我的的博客,bbs.xml抓取一个采用 论坛的内容。
特点:通过XML配置文件实现高度可定制性与可扩展性
12、
是一个基于微内核+插件式架构的网络蜘蛛,它的目标是通过简单的方法就能将复杂的目标网页信息抓取并解析为自己所需要的业务数据。
怎么使用?
首先,确定好你的目标网站以及目标网页(即某一类你想要获取数据的网页,例如网易新闻的新闻页面)
然后java spider爬虫,打开目标页面,分析页面的HTML结构,得到你想要数据的XPath,具体XPath怎么获取请看下文。
最后,在一个xml配置文件里填写好参数,运行吧!
特点:灵活、扩展性强,微内核+插件式架构,通过简单的配置就可以完成数据抓取,无需编写一句代码
13、
的是一个无须配置、便于二次开发的爬虫框架,它提供简单灵活的API,只需少量代码即可实现一个爬虫。
采用完全模块化的设计,功能覆盖整个爬虫的生命周期(链接提取、页面下载、内容抽取、持久化),支持多线程抓取java spider爬虫,分布式抓取,并支持自动重试、自定义UA/等功能。
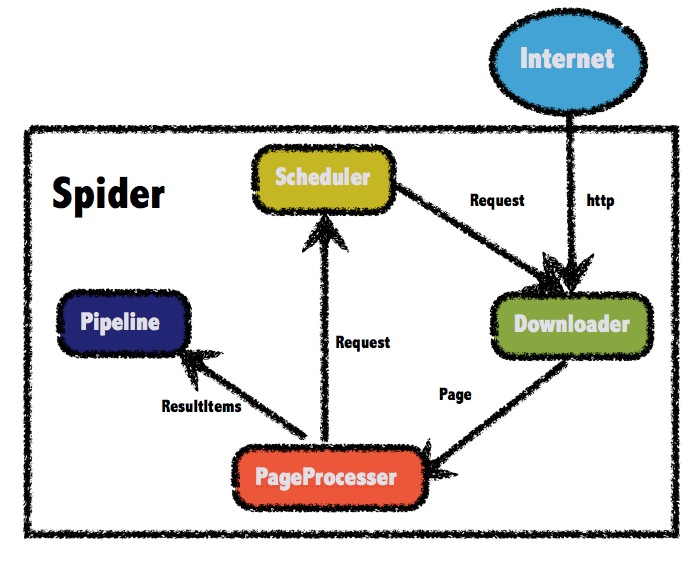
包含强大的页面抽取功能,开发者可以便捷的使用css 、xpath和正则表达式进行链接和内容的提取,支持多个选择器链式调用。
的使用文档:
查看源代码:
特点:功能覆盖整个爬虫生命周期,使用Xpath和正则表达式进行链接和内容的提取。
备注:这是一款国产开源软件,由 黄亿华贡献
14、Web-
Web-是一个Java开源Web数据抽取工具。它能够收集指定的Web页面并从这些页面中提取有用的数据。Web-主要是运用了像XSLT,,正则表达式等这些技术来实现对text/xml的操作。
其实现原理是,根据预先定义的配置文件用获取页面的全部内容(关于的内容,本博有些文章已介绍),然后运用XPath、、正则表达式等这些技术来实现对text/xml的内容筛选操作,选取精确的数据。前两年比较火的垂直搜索(比如:酷讯等)也是采用类似的原理实现的。Web-应用,关键就是理解和定义配置文件,其他的就是考虑怎么处理数据的Java代码。当然在爬虫开始前,也可以把Java变量填充到配置文件中,实现动态的配置。
特点:运用XSLT、、正则表达式等技术来实现对Text或XML的操作,具有可视化的界面
15、
是一个Java类包和Web爬虫的交互式开发环境。Web爬虫(也叫作机器人或蜘蛛)是可以自动浏览与处理Web页面的程序。由两部分组成:爬虫工作平台和类包。
授权协议:
开发语言:Java
特点:由两部分组成:爬虫工作平台和类包
16、YaCy
YaCy基于p2p的分布式Web搜索引擎.同时也是一个Http缓存代理服务器.这个项目是构建基于p2p Web索引网络的一个新方法.它可以搜索你自己的或全局的索引,也可以Crawl自己的网页或启动分布式等.
特点:基于P2P的分布式Web搜索引擎
爬虫
17、
是一个简单的信息收集工具,它可以帮助你查找子域名名称、 zone 、收集电子邮件地址和使用寻找人际关系等。使用编写,支持linux和 操作系统。
特点:具有查找子域名名称、收集电子邮件地址并寻找人际关系等功能
18、
这是一个非常简单易用的抓取工具。支持抓取渲染的页面的简单实用高效的网页爬虫抓取模块
特点:简洁、轻量、高效的网页抓取框架
备注:此软件也是由国人开放
下载:
19、
是一套基于基于的异步处理框架,纯实现的爬虫框架,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网页内容以及各种图片,非常之方便~
源代码:
特点:基于的异步处理框架,文档齐全
C++爬虫
20、
is a fast and high with high speed
严格说只能是一个系统的框架, 没有细化需求, 目前只是能提取URL, URL排重, 异步DNS解析, 队列化任务, 支持N机分布式下载, 支持网站定向下载(需要配置.ini ).
特征和用法:
工作流程:
授权协议: BSD
开发语言: C/C++
操作系统: Linux
特点:支持多机分布式下载, 支持网站定向下载
21、
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » 33款可用来抓数据的开源爬虫软件工具

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码