双旋网络
深入解析PHP中使用正则表达式提取URL的完整指南

在PHP中,正则表达式是一个非常强大的工具,用于处理字符串中的模式匹配。今天咱们就来好好唠唠如何用正则表达式在PHP里提取URL。
一、正则表达式基础
首先,咱们得了解点正则表达式的基础知识。正则表达式是由一些字符和特殊字符组成的字符串,用于定义匹配模式。在PHP中,我们可以使用、等函数来使用正则表达式。
1. 普通字符
普通字符就是字面意义上的字符。比如说,如果你想匹配字符串中的”abc”,正则表达式就是”abc”。
2. 元字符
元字符可就有点意思了。像”.”,它可以匹配除了换行符之外的任何字符。比如正则表达式”a.c”就可以匹配”abc”、”afc”等等。还有像””php正则函数抓取网页连接,它表示前面的字符可以出现0次或者多次。比如说”abc”可以匹配”ac”(此时b出现0次),也可以匹配”abbbc”(此时b出现3次)。
二、用于提取URL的正则表达式
好,那咱们现在来说说用于提取URL的正则表达式。
1. 一个简单的URL提取正则表达式示例
一个比较简单的URL提取正则表达式可能是这样:
$ = “/http?://
a-zA – Z0 – 9.
+/?/”;
$ = “这是一个包含网址的字符串”;
if (($, $, $)) {
echo $;
这个正则表达式的含义是:
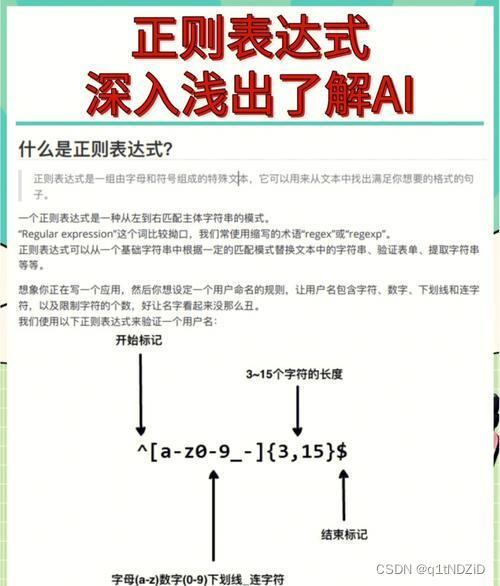
“http?://”:这部分匹配的是以”http”或者”https”开头的协议部分。”s?”表示”s”是可选的,因为有些网址是用”https”,有些是”http”。
a-zA-Z0 – 9.
+”: 这部分匹配的是域名部分,是由字母、数字和点号组成,并且出现至少一次。
“/?”: 这表示最后的斜杠是可选的,因为有些网址后面带有斜杠,有些没有。
2. 更精确的URL提取
上面的那个正则表达式可能还不是特别精确,有时候可能会匹配到一些错误的内容或者不能完全匹配所有合法的URL。下面这个可能更精确一点:
$ = “/(http|https)://(+).(+)/”;
$ = “这是一个包含网址的字符串”;
这里:
“(http|https)://”:明确表示是以”http”或者”https”开始,并且之后跟着”://”。
“(+).(+)”:
“(+)” 表示捕获除了在括号里内容之外的一个或者多个字符,这里主要是捕获域名部分,不包括协议后面重复的”://”。
“.(+)” 捕获点号后面的内容,即域名中的顶级域名部分。
三、可能遇到的问题和错误
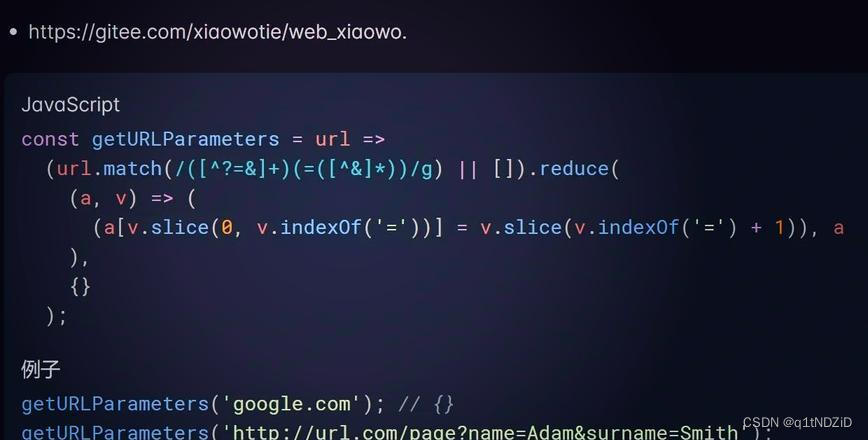
1. 的返回值
当使用函数时,要注意它的返回值。如果模式匹配成功,函数返回1,如果没有匹配到任何内容则返回0,如果出错则返回false。例如:
$ = “这个字符串不包含网址”;
$ = ($, $);
if ($ === true) {
echo “匹配成功”;
} ($ === false) {
echo “发生错误”;
} else {
echo “没有匹配到任何网址”;
如果是返回false的话,可能是因为正则表达式语法错误。这时候要仔细检查正则表达式是否有遗漏或者多余的字符,比如括号是否配对等。
2. 匹配不完全
在某些情况下,上面的正则表达式可能会匹配不完全。比如说,有些URL可能包含端口号,像”:8080″。我们之前的正则表达式就不能很好地处理这样的情况。
要解决这个问题,我们可以修改正则表达式为:
$ = “/(http|https)://(+).(+)(:d+)?/”;
$ = “这是一个包含网址:8080的字符串”;
这个正则表达式中的 “(:d+)?” 表示端口号部分,”? “表示是可选的内容,这样就可以更好地处理带有端口号的URL了。
在正则表达式中,一些特殊字符需要转义才能正常使用。比如说,如果要在正则表达式中匹配实际的”.”、”*”等字符,就需要进行转义。比如如果要匹配字符串””中的”a.b”部分,正则表达式不能直接写成 “a.b”,因为 “.” 是元字符,应该写成 “a\.b”。
四、关于正则表达式的性能
当在PHP程序中使用正则表达式来提取URL时,性能也是一个需要考虑的因素。
1. 复杂的正则表达式
越是复杂的正则表达式,匹配的时间可能就越长。如果一个程序中需要频繁地进行URL提取,而且使用了比较复杂的正则表达式php正则函数抓取网页连接,可能会影响程序的整体性能。例如在一个循环中多次调用以上有复杂匹配的正则表达式函数。
在这种情况下深入解析PHP中使用正则表达式提取URL的完整指南,一方面可以考虑简化正则表达式,使其既能满足需求又不至于过于复杂。另一方面,可以考虑对已经处理过的字符串进行缓存,如果同一个字符串不需要再次进行URL提取的话。
2. 字符串的长度
如果要处理的字符串非常长,正则表达式的匹配时间也会相应增加。如果只需要提取字符串中前面部分的URLphp正则函数抓取网页连接,并且可以确定URL不会出现在后面部分,比如在前100个字符内查找URL,可以使用函数先截取字符串的一部分进行处理。
五、在实际项目中的应用场景
1. 网络爬虫项目
我曾经做过一个网络爬虫项目,这个项目,需要从大量网页内容里面提取URL,以便于进一步对这些URL对应的网页进行爬取。
最初就面临URL提取的准确性问题。因为网页内容非常复杂,存在各种文本和格式,简单的正则表达式总是会出现误判或者漏判的情况。
我们尝试了前面提到的各种正则表达式改进方法,比如改进域名的捕获规则,加入端口号的处理等等。最后确定了一个比较完善的正则表达式,同时在代码中还加入了对提取出来的URL的进一步验证逻辑。因为有时候即使正则表达式匹配出看起来像URL的内容深入解析PHP中使用正则表达式提取URL的完整指南,但实际上可能是一些被错误标识的内容,比如HTML代码中的一些乱码看起来像一部分URL。
只靠正则表达式还不够,我们还利用了PHP中的字符串处理函数,在使用正则表达式提取之前先对网页内容进行一些预处理,比如去除一些HTML标签等,这样可以提高正则表达式的效率和准确性。为了优化性能,我们把已经处理过的网页根据一定规则进行分组缓存,避免对相同网页内容的重复处理,在需要再次提取URL时直接使用缓存结果。
2. 内容分析项目
在另一个内容分析项目中,我们需要分析文本内容中的URL相关信息,比如说统计特定域名下的URL出现的次数等。
这就要求我们精确地提取出URL。在这个项目中,因为主要是处理普通文本内容,而不是像网络爬虫那样复杂的网页内容,所以正则表达式相对更容易设置一些。但是仍然面临一些挑战,例如如何更好地处理输入文本中的一些特殊字符和编码问题。有些特殊字符可能在正则表达式中与我们预期的含义不同,需要通过转换编码或者转义来正确处理。
在这个项目中我们还需要考虑效率问题。由于要分析大量的文本内容,如果正则表达式性能不佳,整个分析过程会变得非常缓慢。为了解决这个问题,我们采用了多线程技术。把大的文本内容分割成多个小部分,每个小部分在单独的线程中进行URL提取和分析,最后再把结果汇总起来。我们发现,通过这种多线程的方式,在处理大量文本时效率得到了很大的提升。而且在多线程的过程中,我们需要注意线程之间的同步数据访问问题。特别是在统计URL出现次数的时候,如果不对共享数据的访问进行同步操作,就可能会出现数据不一致的问题。
为了保证数据的准确性,在提取完URL之后,我们也有一个验证步骤。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » 深入解析PHP中使用正则表达式提取URL的完整指南

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码