双旋网络
yum postgresql 9.6 PostgreSQL 全文检索深度指南:内置 FTS、zhparser 与 pg_search 全解

yum postgresql 9.6 PostgreSQL 全文检索深度指南:内置 FTS、zhparser 与 pg_search 全解
一. 什么是全文检索
全文检索(Full-Text ,FTS)是一种从海量文本中快速找出相关内容的搜索技术。与常见的 LIKE '%%' 不同,全文检索的核心价值在于三点:倒排索引加速,相关度排序,词根匹配
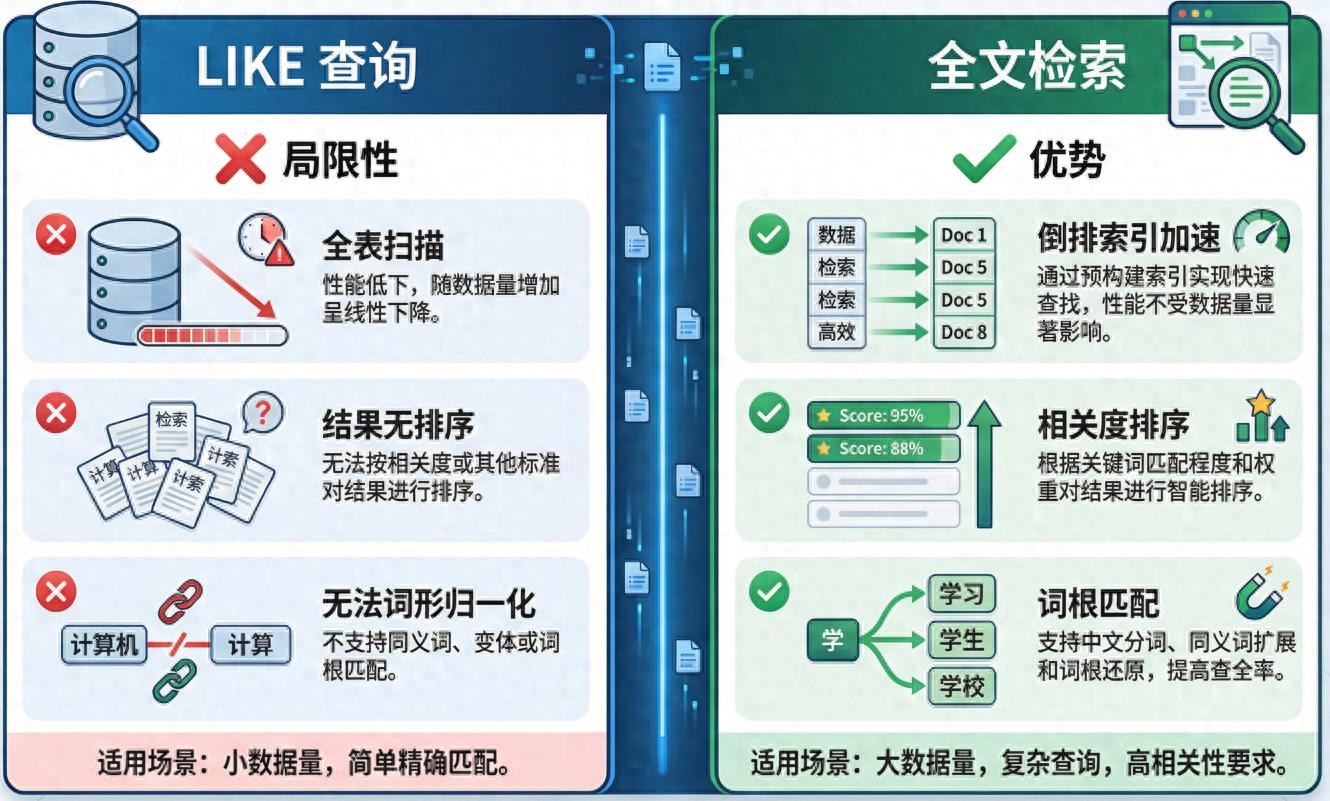
对于一个文章系统、搜索框、日志分析平台来说,全文检索几乎是标配能力。 从很早就内置了完整的全文检索功能yum postgresql 9.6,近年来还涌现出 (中文分词)和 (BM25 相关度排序)两个强力补充yum postgresql 9.6 PostgreSQL 全文检索深度指南:内置 FTS、zhparser 与 pg_search 全解,使得 PG 的检索能力足以与 一较高下。
二. 内置全文检索2.1 核心概念: 与
PG 全文检索围绕两个数据类型工作:
— 文档的存储格式
文档文本经过分词、去停用词、词形归一化后,生成一个”词位序列”(),每个词位带上它在原文中的位置信息。
-- 原始字符串直接转 tsvector(空格分词)
SELECT 'a fat cat sat on a mat and ate a fat rat'::tsvector;
-- 输出:
-- 'a' 'and' 'ate' 'cat' 'fat' 'mat' 'on' 'rat' 'sat'
() — 带语言处理的转换函数
SELECT to_tsvector('english', 'The Fat Rats');
-- 输出:'fat':2 'rat':3
() 做了三件事:
-- 对比:有 to_tsvector 和没有的差别
SELECT 'a fat cat sat on a mat - it ate a fat rats'::tsvector;
-- 输出:'-' 'a' 'ate' 'cat' 'fat' 'it' 'mat' 'on' 'rats' 'sat'
SELECT to_tsvector('english', 'a fat cat sat on a mat - it ate a fat rats');
-- 输出:'ate':9 'cat':3 'fat':2,11 'mat':7 'rat':12 'sat':4
注意标点符号 – 和停用词 a、on、it 在 () 中都被过滤掉了。
— 查询条件格式
是经过规范化的查询条件,支持布尔逻辑:
-- AND:同时包含
SELECT to_tsquery('english', 'cat & rat');
-- OR:包含其一
SELECT to_tsquery('english', 'cat | rat');
-- NOT:排除
SELECT to_tsquery('english', 'cat & ! rat');
-- 短语查询:词1紧跟词2
SELECT to_tsquery('english', '''fat  rat''');
-- 前缀匹配
SELECT to_tsquery('english', 'rat:*');
2.2 匹配操作符 @@
和 之间用 @@ 连接,表示”文档是否匹配查询”:
-- 两种写法等价
to_tsvector('fat cats ate rats') @@ to_tsquery('cat & rat')   -- → t
'fat cats ate rats'           @@ to_tsquery('cat & rat')       -- → t
text 类型会在比较时隐式调用 () 转换。
2.3 内置全文检索的局限
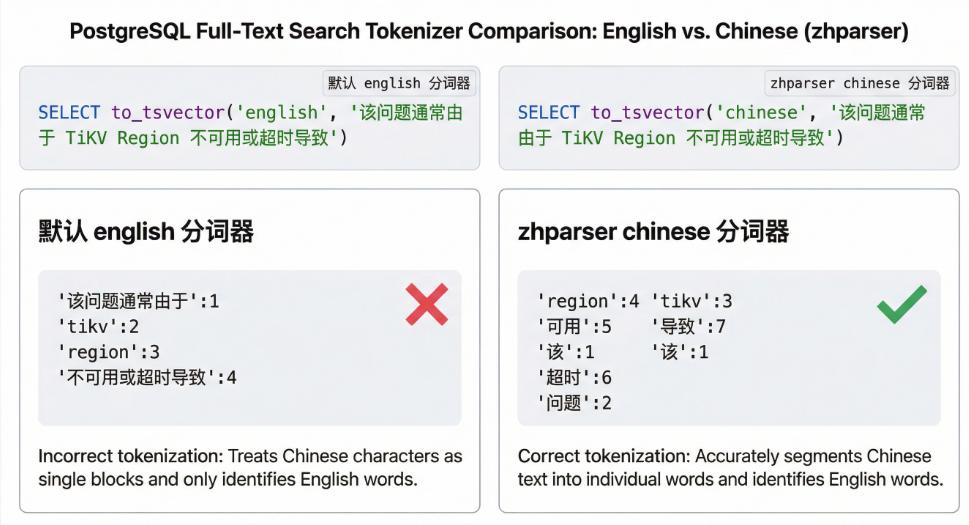
PG 内置分词器默认按空格分割,这对英文友好,对中文却束手无策:
-- 中文整句被当成一个词,无法部分匹配
SELECT to_tsvector('english', '不可用或超时导致');
-- '不可用或超时导致':1
-- 精确匹配整个词组才有效
SELECT * FROM wenzhang WHERE content_tsvector @@ '不可用或超时'::tsquery;
-- → 0 rows
SELECT * FROM wenzhang WHERE content_tsvector @@ '不可用或超时导致'::tsquery;
-- → 有结果
要支持中文,需要引入中文分词插件。
三. 中文分词支持:.1 为什么需要
中文文本的词与词之间没有空格分隔,直接用空格分词器会把一整句话当成一个词。 基于 SCWS 中文分词库实现,能将中文句子正确切分为独立的词语。
3.2 创建扩展和文本搜索配置
以下操作假设 扩展已安装(编译安装步骤请参考 amutu/)。
-- 1. 创建 zhparser 扩展
CREATE EXTENSION zhparser;
-- 2. 验证扩展
dx zhparser
--  List of installed extensions
--  Name    | Version | Schema | Description
--  --------+---------+--------+------------------------------------------
--   zhparser | 2.3     | public | a parser for full-text search of Chinese
-- 3. 查看当前默认文本搜索配置
SHOW default_text_search_config;
-- → pg_catalog.english
-- 4. 创建中文文本搜索配置(关键步骤)
CREATE TEXT SEARCH CONFIGURATION chinese (PARSER = zhparser);
-- 5. 核心步骤:将各词性映射到 simple 词典
-- 如果跳过这步,to_tsvector('chinese', ...) 返回空!
ALTER TEXT SEARCH CONFIGURATION chinese
    ADD MAPPING FOR n, v, a, i, e, l WITH simple;
中各词性的含义:
词典不做任何词形处理yum postgresql 9.6,原样存储和匹配,非常适合不需要词形变化的汉语。如果不指定 ,或者 到其他语言的词典(如 ),分词结果将是空。
3.3 对比分词效果
— 默认 分词器:中文被当成一个词 ;– 分词:正确切分为多个词语
3.4 注意事项
1. 必须精确匹配分词结果
--  "排查" 是完整词,可以搜到
SELECT * FROM search_wenzhang WHERE content_zh_tsvector @@ '排查'::tsquery;
--  "排" 不是独立词,搜不到任何结果
SELECT * FROM search_wenzhang WHERE content_zh_tsvector @@ '排'::tsquery;
-- → 0 rows
2. 不配置 导致分词为空
-- mapping 缺失时,to_tsvector('chinese', ...) 返回空!
-- 表现:更新后 content_zh_tsvector 字段为空
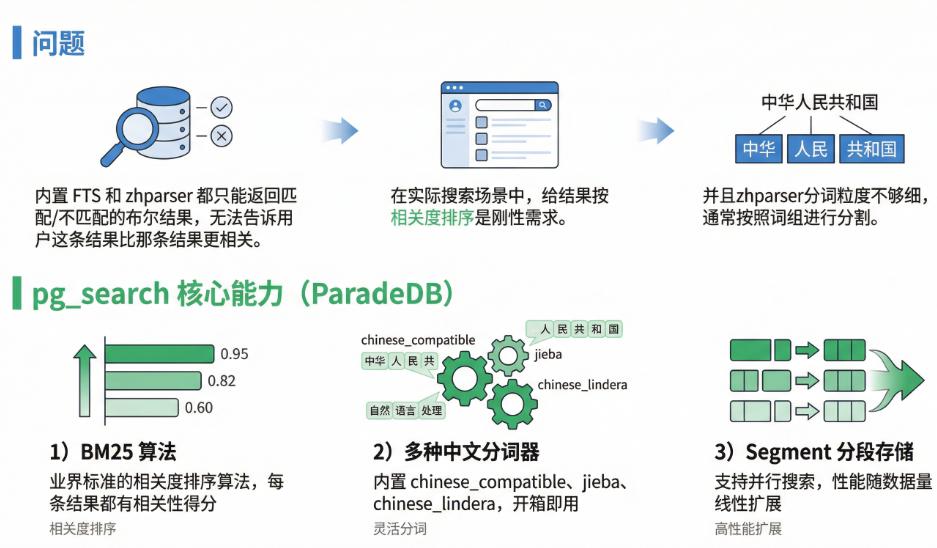
四. 智能检索:()4.1 为什么要用
4.2 创建扩展
以下操作假设 扩展已安装(安装步骤请参考 官方文档)。
需要预先在 .conf 中添加:
shared_preload_libraries = 'pg_search'
重启 PG 后执行:
CREATE EXTENSION pg_search;
目前HULK的实例默认已经安装了扩展,方便大家使用。
4.3 可用的中文分词器
SELECT * FROM paradedb.tokenizers();
 default
 keyword
 keyword_deprecated
 raw
 literal_normalized
 white_space
 regex_tokenizer
 chinese_compatible
 source_code
 ngram
 chinese_lindera
 japanese_lindera
 korean_lindera
 jieba
 lindera
 unicode_words_deprecated
 unicode_words
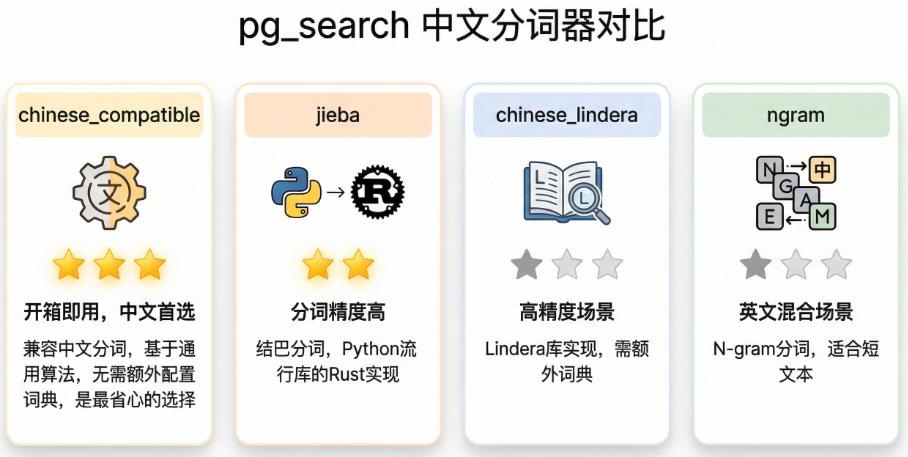
其中与中文相关的分词器主要是以下四个:
4.4 创建 BM25 索引
BM25 索引是 的核心,语法与普通 B-Tree 索引不同:
CREATE INDEX ch_idx ON public.search_wenzhang
USING bm25 (id, content)
WITH (
    key_field = 'id',
    text_fields = '{
        "content": {"tokenizer": {"type": "chinese_compatible"}}
    }'
);
参数说明:
4.5 查询语法
-- 基础查询:content 字段包含"问题"
SELECT * FROM search_wenzhang
WHERE id @@@ paradedb.parse('content:问题')
LIMIT 10;
更多查询示例:
-- 搜索英文 "TiKV"
SELECT * FROM search_wenzhang
WHERE id @@@ paradedb.parse('content:TiKV')
LIMIT 10;
-- 搜索"定位"
SELECT * FROM search_wenzhang
WHERE id @@@ paradedb.parse('content:定位')
LIMIT 10;
-- 前缀匹配:Ti 可以匹配 TiKV、TiDB 等
SELECT * FROM search_wenzhang
WHERE id @@@ paradedb.parse('content:Ti*')
LIMIT 10;
-- 前缀匹配查不到的情况(英文分词器按空格分词)
SELECT * FROM search_wenzhang
WHERE id @@@ paradedb.parse('content:Ti')
LIMIT 10;
-- → 0 rows(需要完整词 "TiKV" 或前缀 "Ti*")
注意:id @@@ … 是 的查询语法,BM25 索引不依赖额外的 存储列。
4.6中文分词和智能搜索查询对比
–查询关键词”问题”
--pg_search
dbrte=# SELECT id, content  FROM search_wenzhang  WHERE id @@@ paradedb.parse('content:问题')  LIMIT 2;
 id |                                    content
----+-------------------------------------------------------------------------------
  1 | 通过 HTTP API 来排查 goroutine 泄露的问题。
  2 | 该问题通常由于 TiKV Region 不可用或超时导致,需要看 TiKV 的监控指标定位问题。
--zhparser
dbrte=# SELECT id, content  FROM search_wenzhang  WHERE content_zh_tsvector @@ '问题'::tsquery  LIMIT 2 ;
 id |                                    content
----+-------------------------------------------------------------------------------
  1 | 通过 HTTP API 来排查 goroutine 泄露的问题。
  2 | 该问题通常由于 TiKV Region 不可用或超时导致,需要看 TiKV 的监控指标定位问题。
–查询关键字”问”
--pg_serach
dbrte=# SELECT id, content  FROM search_wenzhang  WHERE id @@@ paradedb.parse('content:问')  LIMIT 2;
 id |                                    content
----+-------------------------------------------------------------------------------
  1 | 通过 HTTP API 来排查 goroutine 泄露的问题。
  2 | 该问题通常由于 TiKV Region 不可用或超时导致,需要看 TiKV 的监控指标定位问题。
--zhparser
dbrte=# SELECT id, content  FROM search_wenzhang  WHERE content_zh_tsvector @@ '问'::tsquery  LIMIT 2;
 id | content
----+---------
(0 rows)
结论:可以看出在非常规词组的匹配上更准确。
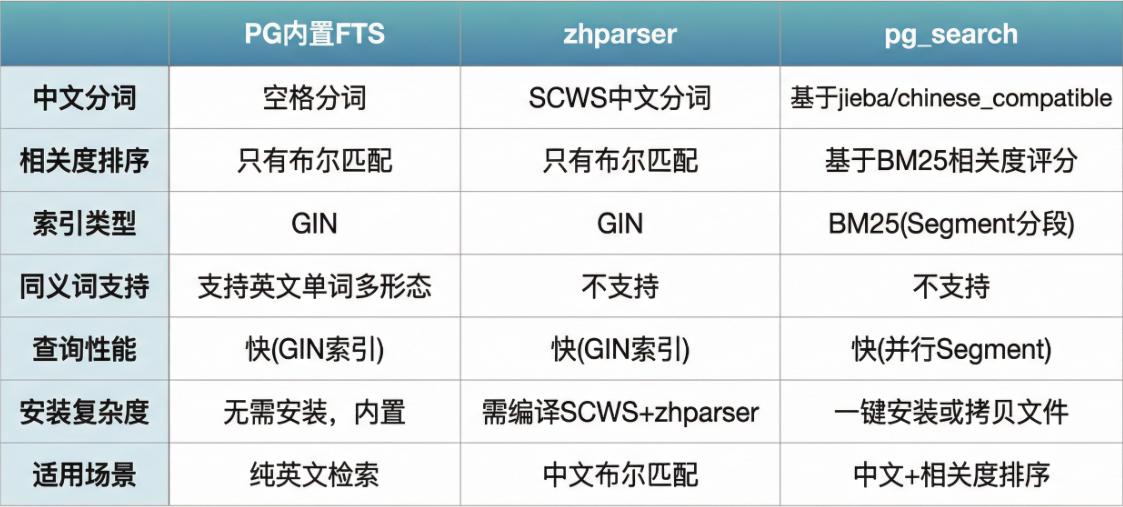
五. 选型建议与最佳实践5.1三种方案横向对比
5.2 选型决策
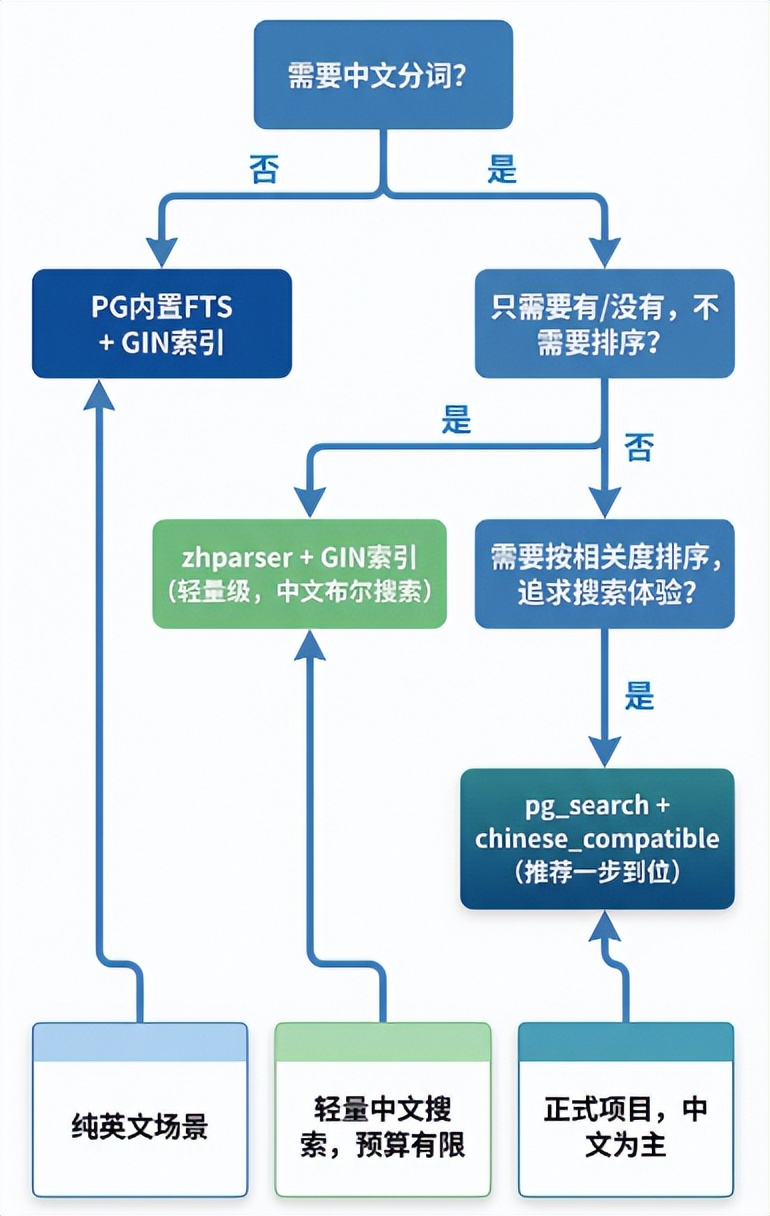
我们可以根据以下策略进行分词器选择:
5.3 表设计建议:触发器自动维护
每次 / 都手动调用 () 容易遗漏。用触发器自动完成:
CREATE OR REPLACE FUNCTION update_wenzhang_tsvector()
RETURNS TRIGGER AS $
BEGIN
    NEW.content_tsvector := to_tsvector(
        'english',
        COALESCE(NEW.title, '') || ' ' || COALESCE(NEW.content, '')
    );
    NEW.content_zh_tsvector := to_tsvector(
        'chinese',
        COALESCE(NEW.title, '') || ' ' || COALESCE(NEW.content, '')
    );
    RETURN NEW;
END;
$ LANGUAGE plpgsql;
CREATE TRIGGER wenzhang_tsvector_update
BEFORE INSERT OR UPDATE ON search_wenzhang
FOR EACH ROW EXECUTE FUNCTION update_wenzhang_tsvector();
有了这个触发器,应用程序只需要写入 字段yum postgresql 9.6, 列会自动保持最新。
5.4 性能优化清单
以下是基于200 万行数据进行的查询性能基准测试:
查询性能对比:
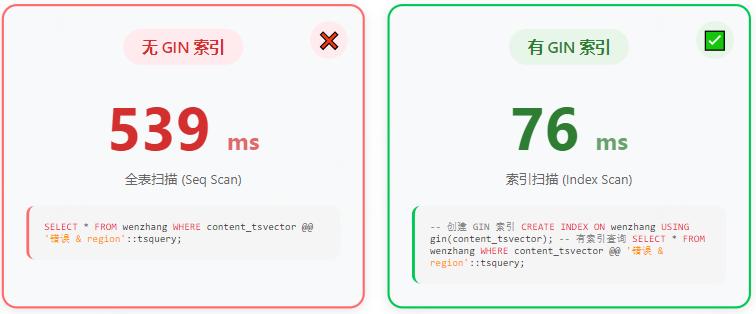
GIN 索引让查询从全表扫描变为索引查找,性能提升约 7 倍。
5.5 常见问题速查
现象
最可能的原因
解决方案
('', …) 返回空
没有配置
执行 ALTER TEXT ADD FOR … WITH
中文查询只能搜完整词,部分匹配不到
精确匹配分词结果
使用 或 jieba 分词器,支持更细粒度切分
查询报错
ries 未配置
修改 .conf,重启 PG
查询变慢
索引失效或数据量增长
执行 ,检查分区策略
分词结果不符合预期
词典配置问题
检查 SCWS 词典版本,或换用 的 jieba 分词器
六. 总结
的全文检索生态已经从”能用”进化到了”好用”:
PG 内置 FTS:英文场景完全够用,内置无需安装,性能稳定:解决中文布尔搜索问题,代价是需要编译安装插件,且只有”有/没有”的判断:中文 + BM25 排序的最佳方案,安装简单yum postgresql 9.6 PostgreSQL 全文检索深度指南:内置 FTS、zhparser 与 pg_search 全解,功能强大,是当前最推荐的生产级选择
在实际项目中,可以将多种方案组合使用:用 或 做中文全文检索,同时保留内置 FTS 处理英文场景,各取所长。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » yum postgresql 9.6 PostgreSQL 全文检索深度指南:内置 FTS、zhparser 与 pg_search 全解

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码