双旋网络
用PHP抓取网页数据,轻松展示!

用PHP抓取网页数据,轻松展示!
随着互联网的快速发展,信息获取也变得越来越便捷。但是,当我们需要从海量的信息中筛选出有用的数据时,就需要借助一些工具来帮助我们完成这项任务。本文将介绍如何使用PHP抓取网页并显示其中的数据。
一、什么是网页抓取?
网页抓取,又称网络爬虫、网络蜘蛛、网络机器人等,是指通过计算机程序自动采集互联网上的信息,包括文本、图片、音频、视频等各种形式的数据。在实际应用中,网页抓取可以帮助我们快速地获取所需信息php 正则 抓取网页用PHP抓取网页数据,轻松展示!,比如搜索引擎就是通过爬虫技术来收录网站内容的。
二、PHP如何实现网页抓取?
PHP是一种广泛应用于Web开发的脚本语言,其强大的字符串处理和正则表达式功能使其成为一种非常适合用来进行网页抓取的语言。下面将从八个方面介绍如何使用PHP实现网页抓取。
1.获取HTML源码
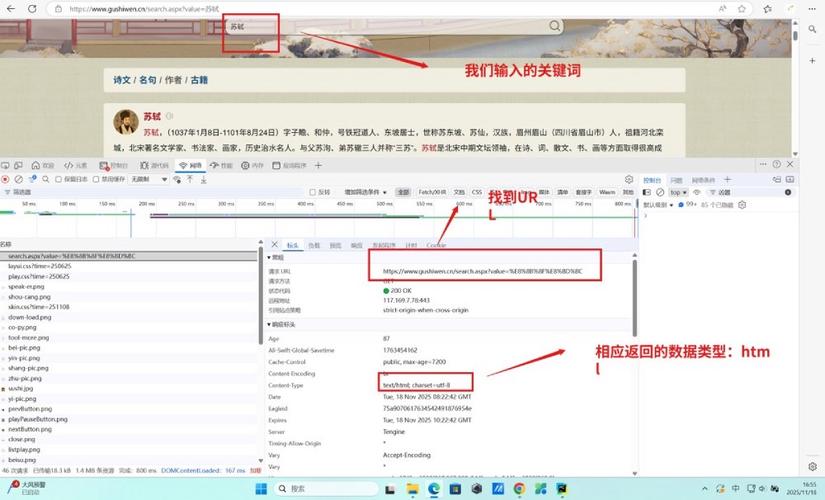
要想进行网页抓取,首先需要获取目标页面的HTML源码。可以使用PHP内置函数()来获取一个URL地址所对应的HTML文档,并将其作为一个字符串返回。
代码示例:
php$url =”;$html = ($url);echo $html;
2.使用cURL库获取HTML源码
()函数虽然简单易用php 正则 抓取网页,但是在一些情况下可能会失效用PHP抓取网页数据,轻松展示!,比如目标页面需要登录才能访问、需要传递POST数据等。这时可以使用cURL库来获取HTML源码。
代码示例:
php$url =”;$ch = ();($ch, ,$url);($ch, ER, true);$html = ($ch);($ch);echo $html;
3.解析HTML源码
获取到HTML源码之后,就需要对其进行解析。可以使用PHP内置的类来解析HTML文档php 正则 抓取网页,并使用XPath表达式来定位所需的元素。
代码示例:
php$url =”;$html = ($url);$dom = new ();@$dom->($html);$xpath = new ($dom);$ =$xpath->query(“//div
@class=”
“); ($ as $){ echo $->;}
4.使用正则表达式匹配数据
除了使用和XPath来解析HTML文档外,还可以使用PHP内置的正则表达式函数来匹配所需的数据。
代码示例:
php$url =”;$html = ($url);$ =’/
(.*?)/s’;($,$html,$);echo $;
5.处理页面分页
有些网站将数据分成了多个页面,每个页面只显示一部分数据。这时需要对页面进行分页处理,逐个获取每一页的数据。
代码示例:
php$url ='{page}.html’;for ($i=1;$($,’data.js’);eval(‘$data=’. ($ctx->data).’;’); ($data as $item){ //处理每个数据项}
7.处理反爬虫机制
为了防止爬虫程序对网站造成影响,一些网站会设置反爬虫机制,比如验证码、IP限制、请求频率限制等。这时需要对反爬虫机制进行处理,以确保程序能够正常运行。
代码示例:
php$url =”;$html =”;$i=0;while (empty($html)&&$i
8.显示抓取结果
最后,将抓取到的数据显示出来。可以使用PHP内置的echo函数将数据输出到浏览器中。
代码示例:
php$url =”;$html = ($url);$ =’/
(.*?)/s’;($,$html,$);echo $;
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » 用PHP抓取网页数据,轻松展示!

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码