双旋网络
mysql fetch into 致命!10个微小操作,直接搞崩MySQL生产库(附避坑实操)

mysql fetch into 致命!10个微小操作,直接搞崩MySQL生产库(附避坑实操)
一、比黑客攻击更可怕的,是程序员的“随手操作”
做后端开发、运维的人都懂一个道理:生产环境的MySQL,从来不是被“大灾难”搞垮的。
没有惊天动地的黑客攻击,没有硬件的突然报废,更没有代码的重大Bug,多数时候,压垮MySQL的,都是那些看似无害的“小操作”——一句随手写的查询语句、一个图方便的触发器、一次想当然的表结构修改。
很多程序员都有过这样的经历:“就加一个简单的搜索框,几分钟的事”“这个更新语句很简单,不会出问题”,可就是这些随口一说的“小决定”,最后却导致整个系统瘫痪、服务宕机,损失几十万甚至上百万。
今天,我们就拆解10个真实发生的生产事故,每一个都来自一线实操,每一个都能给正在做后端、运维的你敲醒警钟——那些你不以为然的微小操作,正在悄悄杀死你的MySQL生产库。
先明确核心:MySQL本身足够稳定,真正的“杀手”,是我们在赶进度、图方便时,做出的那些看似无害的妥协。
二、核心拆解:10个致命操作,附实操代码与修复方案
这10个操作,每一个都看似简单,却在真实生产环境中引发过大规模 (宕机),全程拆解操作过程、问题根源,以及可直接复用的修复方案,新手也能看懂、会用。
操作1:一个搜索查询,直接拉满CPU
需求很简单:给后台管理面板加一个搜索框,根据文章标题搜索相关内容。开发者随手写了一句查询,看似毫无问题,却让生产库直接宕机。
错误操作(生产环境真实代码):
SELECT *
FROM articles
WHERE title LIKE '%docker%'
ORDER BY created_at DESC
LIMIT 50;
问题爆发:几天后,生产环境开始频繁卡顿,高峰时段直接无响应。监控显示,MySQL CPU使用率100%,磁盘读写疯狂飙升,等待线程数量暴增。
根源:LIKE查询前的“%”,让MySQL无法使用索引,只能全表扫描,还要对几百万行数据进行排序,在磁盘上创建临时表mysql fetch into,直接耗尽服务器资源。
修复方案(可直接复制使用):
-- 第一步:给标题添加全文索引
ALTER TABLE articles ADD FULLTEXT(title);
-- 第二步:使用全文检索查询
SELECT id, title
FROM articles
WHERE MATCH(title) AGAINST('docker' IN BOOLEAN MODE)
ORDER BY created_at DESC
LIMIT 50;
修复后,生产库瞬间恢复正常,CPU和磁盘使用率直接回落。
操作2:一次JOIN查询,让1行数据变成1万行
需求:后台订单页面有点慢,优化一下。开发者想通过多表JOIN获取订单相关的所有数据,测试环境一切正常,生产环境却直接挂掉。
错误操作(生产环境真实代码):
SELECT *
FROM orders o
JOIN customers c ON c.id = o.customer_id
LEFT JOIN order_tags t ON t.order_id = o.id
LEFT JOIN order_status_history s ON s.order_id = o.id
LEFT JOIN delivery_logs l ON l.order_id = o.id;
问题爆发:只要打开后台订单列表,MySQL服务器就会卡死,磁盘IO直接拉满,无法处理任何新请求。
根源:一张订单表,关联了客户表、标签表、状态表、物流日志表——一个订单可能有几十个标签、几百条状态记录、几千条物流日志,JOIN之后,1行订单数据会被放大成1000-10000行,MySQL需要处理上千万行临时数据,磁盘根本扛不住。
修复方案(可直接复制使用):
SELECT
  o.id,
  o.total,
  c.name,
  GROUP_CONCAT(DISTINCT t.tag) AS tags,
  MAX(s.status) AS last_status,
  COUNT(l.id) AS delivery_events
FROM orders o
JOIN customers c ON c.id = o.customer_id
LEFT JOIN order_tags t ON t.order_id = o.id
LEFT JOIN order_status_history s ON s.order_id = o.id
LEFT JOIN delivery_logs l ON l.order_id = o.id
GROUP BY o.id;
修复后,处理的行数减少几百倍,订单页面秒加载,服务器压力直接清零。
操作3:一个触发器,引发锁雪崩
需求:想实时统计每条记录的数量,避免执行耗时的COUNT查询,开发者添加了一个触发器,初衷是优化性能,结果却引发了连锁反应。
错误操作(生产环境真实代码):
-- 插入数据后,直接更新统计数
AFTER INSERT ON entries
UPDATE entry_stats
SET total = total + 1
WHERE forms_id = NEW.forms_id;
问题爆发:前几天一切正常,随着流量增长,每次插入数据都越来越慢,复制延迟飙升,日志疯狂增大,用户频繁看到加载失败。
根源:大量并发事务同时更新表中的同一行数据,导致锁排队mysql fetch into 致命!10个微小操作,直接搞崩MySQL生产库(附避坑实操),互相阻塞,形成“锁雪崩”,整个数据库的事务都陷入等待。
修复方案(可直接复制使用):
-- 第一步:触发器只标记需要重新计算,不直接更新
INSERT INTO entry_stats (forms_id, need_update)
VALUES (NEW.forms_id, 1)
ON DUPLICATE KEY UPDATE need_update = 1;
-- 第二步:后台批量重新计算(每几分钟执行一次)
SELECT id FROM entry_stats WHERE need_update = 1 LIMIT 1000;
UPDATE entry_stats s
JOIN (
  SELECT record_id, COUNT(*) cnt
  FROM entries
  WHERE record_id IN ( .. )  -- 替换为上面查询到的id
  GROUP BY record_id
) x ON x.record_id = s.record_id
SET s.total = x.cnt,
    s.need_update = 0;
修复后,事务不再阻塞,锁雪崩彻底解决,复制延迟恢复正常。
操作4:语句少写WHERE,直接搞崩数据库
需求:清理旧的通话记录,将 (未活跃)的记录标记为归档,开发者图方便,少写了一个WHERE条件,酿成大错。
错误操作(生产环境真实代码):
-- 没有WHERE条件,更新全表
UPDATE calls SET status = 0;
问题爆发:执行后,MySQL没有任何响应,后续所有查询都陷入等待,连接队列爆满,整个服务逐渐瘫痪。
根源:会逐行更新数据,创建undo记录,并且持有排他锁,直到整个事务提交。几千万行数据的更新,会产生大量锁和undo日志,缓冲池被占满,磁盘IO疯狂抖动,最终导致数据库崩溃。
修复方案(可直接复制使用):
-- 分批更新,每次处理5000行,单独提交事务
UPDATE calls
SET status = 0
WHERE id > :last_id  -- 记录上一次更新的最后一个id
ORDER BY id
LIMIT 5000;
分批更新后,锁不会积累,undo日志可以及时清理,数据库不会被压垮。
操作5:ALTER TABLE加字段,导致全局锁死
需求:给通话记录表加一个“是否归档”的小字段mysql fetch into,开发者认为字段很小,不会有问题,直接在生产环境执行ALTER语句,结果导致服务全面宕机。
错误操作(生产环境真实代码):
ALTER TABLE calls ADD COLUMN is_archived TINYINT(1) DEFAULT 0;问题爆发:执行后几秒,网站开始卡顿,1分钟后彻底无响应mysql fetch into 致命!10个微小操作,直接搞崩MySQL生产库(附避坑实操),所有查询都显示“ for table lock”(等待表元数据锁)。
根源:MySQL执行DDL操作(ALTER TABLE)时,会对表加排他元数据锁,在操作完成前,所有对该表的、、都会被阻塞。而几千万行的大表,加字段需要很长时间,等待的查询会越积越多,最终导致服务崩溃。
修复方案(可直接复制使用):
-- 使用pt-online-schema-change工具,无锁修改表结构
pt-online-schema-change
  --alter "ADD COLUMN is_archived TINYINT(1) DEFAULT 0"
  D=mydb,t=calls --execute
该工具会创建影子表,逐步复制数据,最后替换原表,全程不会加全局锁,用户无感知,服务正常运行。
操作6:1000个空闲连接,吃光服务器内存
需求:图代码简单,每个HTTP请求都新建一个数据库连接,不做连接池、不限制数量,测试环境正常,生产环境却被内存撑爆。
错误操作(生产环境真实代码):
// 每个HTTP请求都新建连接,不关闭、不复用
$db = new PDO(..);
$stmt = $db->query("SELECT 1");
// 请求结束后,连接未关闭
问题爆发:流量上涨后,MySQL连接数突破1200,其中1000多个都是空闲(Sleep)状态,(运行线程数)常年超过100,内存使用率飙升,最终进程被系统OOM 杀死。
根源:每个MySQL连接都是一个独立线程,会占用线程栈、网络缓冲区、排序缓冲区等资源,即使是空闲连接,也会消耗内存。上千个连接同时存在,MySQL会把资源都用在管理线程上,而非处理查询。
修复方案:使用连接池(如、Druid)或,限制MySQL的实际连接数(建议100-200),客户端可以保持上千个连接,但MySQL只处理有限连接,避免内存被耗尽。
操作7:一个长事务,阻塞整个系统
需求:支付确认时,先锁行再调用外部支付API,防止并发问题,开发者认为这样更安全,却导致整个系统陷入等待。
错误操作(生产环境真实代码):
BEGIN;
-- 先锁行,再调用API
SELECT * FROM calls WHERE id = 912384 FOR UPDATE;
-- 调用外部支付API(耗时几秒)
UPDATE calls SET status = 'paid' WHERE id = 912384;
COMMIT;
问题爆发:如果外部API响应缓慢,被锁的行会持有排他锁几秒,其他事务想修改这行数据,都会排队等待,不断增长,CPU空闲但服务却无法响应。
根源:长事务会持有锁很长时间,导致锁排队,积累大量等待线程和undo日志,形成“锁队列放大”,最终阻塞整个系统。
修复方案(可直接复制使用):
-- 第一步:先调用外部API,再开启短事务
call_external_api();
-- 第二步:短事务更新,快速释放锁
BEGIN;
UPDATE calls SET status='paid' WHERE id=912384;
COMMIT;
注意:事务只用于需要原子性的操作(如同时更新两张关联表),且尽量缩短事务时间,避免持有锁过久。
操作8:COUNT(*)查询,拖垮磁盘IO
需求:首页显示系统已处理的通话记录总数,开发者随手写了一句COUNT(*),看似简单,却让磁盘IO常年满负荷。
错误操作(生产环境真实代码):
-- 每次页面加载都执行,全表扫描
SELECT COUNT(*) FROM calls;
问题爆发:随着calls表增长到几千万行,每次COUNT(*)都会全表扫描,耗尽磁盘IO,高峰时段磁盘使用率100%mysql fetch into,其他查询无法执行,网站卡顿严重。
根源:COUNT(*)会扫描整个表,驱逐缓冲池中有用的数据页,导致IO抖动,频繁的全表扫描会彻底拖垮磁盘。
修复方案(可直接复制使用):
-- 第一步:创建聚合统计表(分片避免锁竞争)
CREATE TABLE calls_counter (
  shard TINYINT PRIMARY KEY,
  total BIGINT NOT NULL
);
-- 第二步:插入数据时,更新分片计数器
INSERT INTO calls_counter(shard, total)
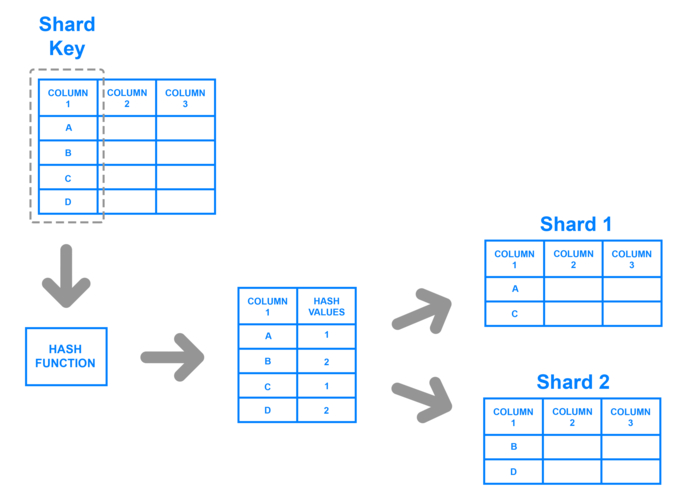
VALUES (MOD(:call_id,25),1)  -- 分25个片,均匀分布压力
ON DUPLICATE KEY UPDATE total = total + 1;
-- 第三步:首页查询时,求和即可
SELECT SUM(total) FROM calls_counter;
分片计数器可以避免所有线程更新同一行,分散写压力,查询时只需求和,速度极快,彻底解决磁盘IO问题。
操作9:无用索引,拖慢写入速度
需求:后台通话列表偶尔卡顿,开发者看到已有索引,又加了一个“看似有用”的索引,结果卡顿更严重,还拖慢了写入速度。
错误操作(生产环境真实代码):
-- 盲目添加复合索引,未考虑查询场景
CREATE INDEX idx_calls_a_b ON calls (status, type);
问题爆发:添加索引后,通话列表依然卡顿,且数据写入速度明显变慢,甚至出现死锁。
根源:复合索引遵循“左前缀规则”,索引(, type)只能在查询条件以开头时生效,而实际查询是按type过滤,这个索引完全无用。且每个索引都是独立的B树,会增加写入压力、占用缓冲池,拖慢整个数据库。
修复方案(可直接复制使用):
-- 创建贴合查询场景的复合索引,包含排序字段
CREATE INDEX idx_calls_filter ON calls (type, created_at DESC);
注意:索引不是越多越好,一张表建议不超过5个索引,多余的无用索引要及时删除,避免拖慢写入速度。
操作10:主从复制滥用,拖垮主库
需求:从库复制延迟, heavy(重量级)报表查询在从库跑不完,开发者临时把报表查询路由到主库,想“临时解决”问题,结果主库彻底崩溃。
错误操作:将原本应该在从库执行的重量级查询(多表JOIN、数据分析),全部路由到主库,导致主库同时承担写入和重量级读取压力。
问题爆发:主库缓冲池被分析类查询的页面占满,写入热点数据被驱逐,提交延迟增加,复制延迟越来越严重,最终主库承担双重压力,系统全面降级。
根源:主从复制的核心是“主库写、从库读”,缓解主库压力。将重量级查询路由到主库,会让主库资源耗尽,形成“复制延迟→查询路由主库→主库压力增大→复制更延迟”的恶性循环。
修复方案:
-- 1. 严格区分读写分离,读请求走从库
-- 2. 从库开启super_read_only = 1,防止误写
-- 3. 重量级报表、数据分析,迁移到独立的分析存储(如ClickHouse)
-- 4. 实时监控复制延迟(Seconds_Behind_Master)
三、辩证分析:不是MySQL不够强,是我们踩了“认知陷阱”
看完这10个案例,很多人会说“这些操作太低级了,我不会犯”,但事实是,这些事故都发生在一线大厂、资深开发者身上——不是他们技术不行,而是陷入了“微小操作无害”的认知陷阱。
我们必须承认,MySQL的稳定性毋庸置疑,它能承受高并发、大流量,但它的“软肋”,恰恰是我们的“侥幸心理”。
一方面,这些操作单独来看,确实无害:一句没有WHERE的,在测试环境(几百行数据)中执行,一秒就完成;一个无用的索引,在小表中也不会有明显影响。但到了生产环境,千万级数据、高并发请求下,这些“微小瑕疵”会被无限放大,最终酿成灾难。
另一方面,很多开发者陷入了“赶进度优先”的误区:为了快速上线功能,忽略了生产环境的复杂性;为了图代码简单,省略了必要的优化步骤;为了临时解决问题,做出“先凑合用”的妥协。这些妥协,看似节省了几分钟、几小时的时间,最终却要花几天、几周来恢复系统,付出更大的代价。
更值得深思的是:后端开发的核心,从来不是“写出能运行的代码”,而是“写出能在生产环境稳定运行的代码”。一个看似聪明的“快捷操作”,可能是压垮系统的最后一根稻草;一个看似繁琐的“优化步骤”,可能是守护系统稳定的最后一道防线。
四、现实意义:避开这些坑,少走几年弯路
对于后端开发者、运维人员来说,这10个案例的价值,远不止“知道错误操作”,更在于帮我们建立“生产环境敬畏心”,避开那些前人踩过的坑,节省大量时间和成本。
首先,对于新手开发者:这些案例能帮你快速避开“入门误区”,明白生产环境和测试环境的本质区别——测试环境验证功能,生产环境验证稳定性,任何操作都要多问一句“在千万级数据、高并发下,会出问题吗?”。
其次,对于资深开发者、技术负责人:这些案例能帮你完善团队的开发规范——比如禁止无WHERE的、禁止直接在生产环境执行ALTER TABLE、强制使用连接池等,从源头减少生产事故。
最后,对于运维人员:这些案例能帮你快速定位生产问题——如果遇到MySQL CPU飙升、磁盘IO满负荷、锁等待过多,不妨对照这10个操作,大概率能找到根源,快速修复,减少宕机损失。
要知道,生产环境的每一次宕机,都可能意味着用户流失、收入损失、口碑崩塌。而避免这些宕机,不需要多么高深的技术,只需要我们放弃侥幸心理,重视每一个微小操作,做好每一个基础优化。
五、互动话题:你在生产环境踩过哪些MySQL坑?
做后端、运维的,几乎没有人没在MySQL上栽过跟头——可能是一句写错的查询语句,可能是一次粗心的表结构修改,也可能是一次想当然的优化操作。
评论区说说你的经历:你在生产环境中,踩过哪些MySQL相关的坑?当时是怎么解决的?有没有因为一个微小操作,导致系统宕机的经历?
一起交流避坑经验,让更多同行少走弯路,守住生产环境的稳定性底线~
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » mysql fetch into 致命!10个微小操作,直接搞崩MySQL生产库(附避坑实操)

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码