双旋网络
MySQL 数据库设计规范

规范背景与目的
MySQL 数据库与 、 SQL 等数据库相比,有其内核上的优势与劣势。我们在使用 MySQL 数据库的时候需要遵循一定规范,扬长避短。本规范旨在帮助或指导 RD、QA、OP 等技术人员做出适合线上业务的数据库设计。在数据库变更和处理流程、数据库表设计、SQL 编写等方面予以规范,从而为公司业务系统稳定、健康地运行提供保障。
数据库设计
以下所有规范会按照【高危】、【强制】、【建议】三个级别进行标注,遵守优先级从高到低。
对于不满足【高危】和【强制】两个级别的设计,DBA 会强制打回要求修改。
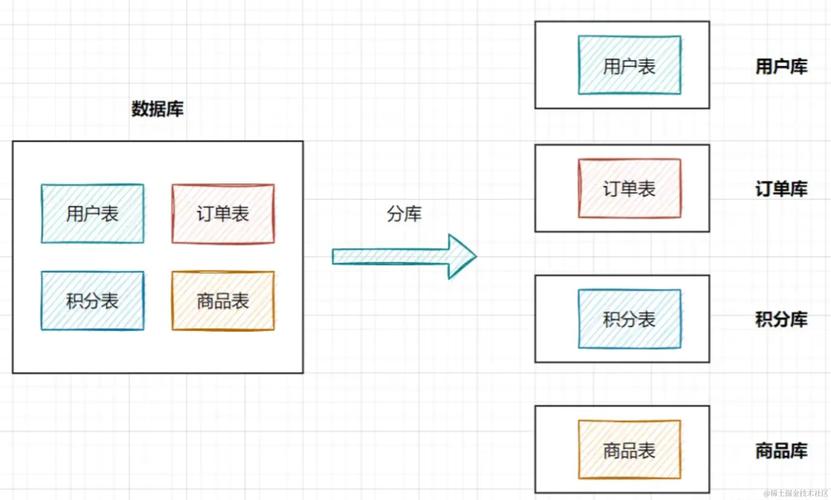
一般命名规则【强制】使用小写,有助于提高打字速度,避免因大小写敏感而导致的错误。【强制】没有空格,使用下划线代替。【强制】名称中没有数字,只有英文字母。【强制】有效的可理解的名称。【强制】名称应该是自我解释的。【强制】名称不应超过 32 个字符。【强制】避免使用前缀。库【强制】遵守以上全部一般命名规则。【强制】使用单数。【强制】库的名称格式:业务系统名称_子系统名。【强制】一般分库名称命名格式是库通配名_编号,编号从 0 开始递增,比如 ,以时间进行分库的名称格式是库通配名_时间。【强制】创建数据库时必须显式指定字符集,并且字符集只能是 utf8 或者 。创建数据库 SQL 举例:
create database db_name default character set utf8;表【强制】遵守以上全部一般命名规则。【强制】使用单数。【强制】相关模块的表名与表名之间尽量体现 join 的关系,如 user 表和 表。【强制】创建表时必须显式指定字符集为 utf8 或 。【强制】创建表时必须显式指定表存储引擎类型,如无特殊需求,一律为 。当需要使用除 // 以外的存储引擎时,必须通过 DBA 审核才能在生产环境中使用。因为 表支持事务、行锁、宕机恢复、MVCC 等关系型数据库重要特性,为业界使用最多的 MySQL 存储引擎。而这是其它大多数存储引擎不具备的,因此首推 。【强制】建表必须有 。【强制】关于主键:(1) 命名为 id,类型为 int 或 ,且为 ;(2) 标识表里每一行主体的字段不要设为主键,建议设为其它字段如 ,等,并建立 key 索引。因为如果设为主键且主键值为随机插入mysql创建表默认值,则会导致 内部 page 分裂和大量随机 I/O,性能下降。【建议】核心表(如用户表,金钱相关的表)必须有行数据的创建时间字段 和最后更新时间字段 ,便于排查问题。【建议】表中所有字段必须都是 NOT NULL 属性,业务可以根据需要定义 值。因为使用 NULL 值会存在每一行都会占用额外存储空间、数据迁移容易出错、聚合函数计算结果偏差等问题。【建议】建议对表里的 blob、text 等大字段,垂直拆分到其它表里,仅在需要读这些对象的时候才去 。【建议】反范式设计:把经常需要 join 查询的字段,在其它表里冗余一份。如 属性在 , 等表里冗余一份,减少 join 查询。【强制】中间表用于保留中间结果集,名称必须以 tmp_ 开头。备份表用于备份或抓取源表快照,名称必须以 bak_ 开头。中间表和备份表定期清理。【强制】对于超过 100W 行的大表进行 alter tableMySQL 数据库设计规范,必须经过 DBA 审核,并在业务低峰期执行。因为 alter table 会产生表锁,期间阻塞对于该表的所有写入,对于业务可能会产生极大影响。字段【强制】遵守以上全部一般命名规则。【建议】尽可能选择短的或一两个单词。【强制】避免使用保留字作为字段名称:orderMySQL 数据库设计规范,date,name 是数据库的保留字,避免使用它。可以为这些名称添加前缀使其易于理解,如 , 等。【强制】避免使用与表名相同的字段名,这会在编写查询时造成混淆。【强制】在数据库模式上定义外键。【强制】避免使用缩写或基于首字母缩写词的名称。【强制】外键列必须具有表名及其主键,例如: 表示来自表博客的外键 id。字段数据类型优化【建议】表中的自增列( 属性),推荐使用 类型。因为无符号 int 存储范围为 0~4,294,967,295(不到 43 亿),溢出后会导致报错。【建议】业务中选择性很少的状态 、类型 type 等字段推荐使用 或者 类型节省存储空间。【建议】业务中 IP 地址字段推荐使用 int 类型,不推荐用 char(15)。因为 int 只占 4 字节,可以用如下函数相互转换,而 char(15) 占用至少 15 字节。
select inet_aton('192.168.2.12');
select inet_ntoa(3232236044);
Java 保存字符串ip 转 int 类型
public static long ipToLong(String addr)
{
String[] addrArray = addr.split("\.");
long num = 0;
for (int i = 0; i < addrArray.length; i++)
{
int power = 3 - i;
num += ((Integer.parseInt(addrArray[i]) % 256 * Math.pow(256, power)));
}
return num;
}
public static String longToIp(long i){
return ((i >> 24) & 0xFF) + "." +
((i >> 16) & 0xFF) + "." +
((i >> 8) & 0xFF) + "." +
(i & 0xFF);
}4.【建议】不推荐使用 enum,set。 因为它们浪费空间,且枚举值写死了,变更不方便。推荐使用 或 。
5.【建议】不推荐使用 blob,text 等类型。它们都比较浪费硬盘和内存空间。在加载表数据时,会读取大字段到内存里从而浪费内存空间,影响系统性能。建议和 PM、RD 沟通,是否真的需要这么大字段。 中当一行记录超过 8098 字节时,会将该记录中选取最长的一个字段将其 768 字节放在原始 page 里,该字段余下内容放在 -page 里。不幸的是在 行格式下,原始 page 和 -page 都会加载。
6.【建议】存储金钱的字段,建议用 int 以分为单位存储,最大数值约 4290 万,程序端乘以 100 和除以 100 进行存取。因为 int 占用 4 字节,而 占用 8 字节,空间浪费。
7.【建议】文本数据尽量用 存储。因为 是变长存储,比 char 更省空间。MySQL 层规定一行所有文本最多存 65535 字节,因此在 utf8 字符集下最多存 21844 个字符,超过会自动转换为 字段。而 text 在 utf8 字符集下最多存 21844 个字符, 最多存 2^24/3 个字符, 最多存 2^32 个字符。一般建议用 类型,字符数不要超过 2700。
8.【建议】时间类型尽量选取 。因为 占用 8 字节, 仅占用 4 字节,但是范围为 1970-01-01 00:00:01 到 2038-01-01 00:00:00。更为高阶的方法,选用 int 来存储时间,使用 SQL 函数 () 和 () 来进行转换。
索引设计【强制】 表必须主键为 id int/ ,且主键值禁止被更新。【建议】主键的名称以 pk_ 开头,唯一键以 uk_ 开头,普通索引以 ix_ 开头,一律使用小写格式,以表名/字段的名称或缩写作为后缀。【强制】 和 存储引擎表,索引类型必须为 BTREE; 表可以根据需要选择 HASH 或者 BTREE 类型索引。【强制】单个索引中每个索引记录的长度不能超过 64KB。【建议】单个表上的索引个数不能超过 7 个。【建议】在建立索引时,多考虑建立联合索引,并把区分度最高的字段放在最前面。如列 的区分度可由 count( ) 计算出来。【建议】在多表 join 的 SQL 里,保证被驱动表的连接列上有索引,这样 join 执行效率最高。【建议】建表或加索引时,保证表里互相不存在冗余索引。对于 MySQL 来说,如果表里已经存在 key(a, b),则 key(a) 为冗余索引,需要删除。【建议】如果选择性超过 20%,那么全表扫描比使用索引性能更优,即没有设置索引的必要。分库分表、分区表【强制】分区表的分区字段(-key)必须有索引,或者是组合索引的首列。【强制】单个分区表中的分区(包括子分区)个数不能超过 1024。【强制】上线前 RD 或者 DBA 必须指定分区表的创建、清理策略。【强制】访问分区表的 SQL 必须包含分区键。【建议】单个分区文件不超过 2G,总大小不超过 50G。建议总分区数不超过 20 个。【强制】对于分区表执行 alter table 操作,必须在业务低峰期执行。【强制】采用分库策略的,库的数量不能超过 1024。【强制】采用分表策略的,表的数量不能超过 4096。【建议】单个分表不超过 500W 行,ibd 文件大小不超过 2G,这样才能让数据分布式变得性能更佳。【建议】水平分表尽量用取模方式,日志、报表类数据建议采用日期进行分表。字符集【强制】数据库本身库、表、列所有字符集必须保持一致,为 utf8 或 。【强制】前端程序字符集或者环境变量中的字符集,与数据库、表的字符集必须一致,统一为 utf8。程序层 DAO 设计建议【建议】新的代码不要用 model,推荐使用手动拼 SQL + 绑定变量传入参数的方式。因为 model 虽然可以使用面向对象的方式操作 db,但是其使用不当很容易造成生成的 SQL 非常复杂,且 model 层自己做的强制类型转换性能较差,最终导致数据库性能下降。【建议】前端程序连接 MySQL 或者 Redis,必须要有连接超时和失败重连机制,且失败重试必须有间隔时间。【建议】前端程序报错里尽量能够提示 MySQL 或 Redis 原生态的报错信息,便于排查错误。【建议】对于有连接池的前端程序,必须根据业务需要配置初始、最小、最大连接数,超时时间以及连接回收机制,否则会耗尽数据库连接资源,造成线上事故。【建议】对于 log 或 类型的表,随时间增长容易越来越大,因此上线前 RD 或者 DBA 必须建立表数据清理或归档方案。【建议】在应用程序设计阶段,RD 必须考虑并规避数据库中主从延迟对于业务的影响。尽量避免从库短时延迟(20 秒以内)对业务造成影响,建议强制一致性的读开启事务走主库,或更新后过一段时间再去读从库。【建议】多个并发业务逻辑访问同一块数据( 表)时,会在数据库端产生行锁甚至表锁导致并发下降,因此建议更新类 SQL 尽量基于主键去更新。【建议】业务逻辑之间加锁顺序尽量保持一致,否则会导致死锁。【建议】对于单表读写比大于 10:1 的数据行或单个列,可以将热点数据放在缓存里(如 或 Redis),加快访问速度,降低 MySQL 压力。一个规范的建表语句示例
create table user
(
`id` bigint(11) not null auto_increment,
`user_id` bigint(11) not null comment '用户 ID',
`username` varchar(45) not null comment '登录名',
`email` varchar(30) not null comment '邮箱',
`nickname` varchar(45) not null comment '昵称',
`avatar` int(11) not null comment '头像',
`birthday` date not null comment '生日',
`gender` tinyint(4) default '0' comment '性别',
`intro` varchar(150) default null comment '简介',
`resume_url` varchar(300) not null comment '简历存放地址',
`register_ip` int not null comment '用户注册时的源 IP',
`review_status` tinyint not null comment '审核状态,1-通过,2-审核中,3-未通过,4-尚未提交审核',
`create_time` timestamp not null comment '记录创建的时间',
`update_time` timestamp not null comment '资料修改的时间',
primary key (`id`),
unique key `idx_user_id` (`user_id`),
key `idx_username`(`username`),
key `idx_create_time`(`create_time`, `review_status`)
)
engine = InnoDB
default charset = utf8
comment = '用户基本信息';DML 语句强制】 语句必须指定具体字段名称,禁止写成 *。因为 * 会将不该读的数据也从 MySQL 里读出来,造成网卡压力。【强制】 语句指定具体字段名称,不要写成 into t1 (…),道理同上。【建议】 into … (xx),(xx),(xx)…,这里 xx 的值不要超过 5000 个。值过多虽然上线很快,但会引起主从同步延迟。【建议】 语句不要使用 union,推荐使用 union all,并且 union 子句个数限制在 5 个以内。因为 union all 不需要去重,节省数据库资源,提高性能。【建议】in 值列表限制在 500 以内。例如 … where in(…500 个以内…),这么做是为了减少底层扫描,减轻数据库压力从而加速查询。【建议】事务里批量更新数据需要控制数量,进行必要的 sleep,做到少量多次。【强制】事务涉及的表必须全部是 表。否则一旦失败不会全部回滚,且易造成主从库同步终端。【强制】写入和事务发往主库,只读 SQL 发往从库。【强制】除静态表或小表(100 行以内),dml 语句必须有 where 条件,且使用索引查找。【强制】生产环境禁止使用 hint,如 ,force index, key, join 等。因为 hint 是用来强制 sql 按照某个执行计划来执行,但随着数据量变化我们无法保证自己当初的预判是正确的,因此我们要相信 MySQL 优化器。【强制】where 条件里等号左右字段类型必须一致,否则无法利用索引。【建议】||| 要有 where 子句,且 where 子句的条件必需使用索引查找。【强制】生产数据库中强烈不推荐大表上发生全表扫描,但对于 100 行以下的静态表可以全表扫描。查询数据量不要超过表行数的 25%,否则不会利用索引。【强制】where 子句中禁止只使用全模糊的 like 条件进行查找,必须有其它等值或范围查询条件,否则无法利用索引。【建议】索引列不要使用函数或表达式,否则无法利用索引。如 where (name) = 'admin' 或 where + 2 = 10023。【建议】减少使用 or 语句,可将 or 语句优化为 union,然后在各个 where 条件上建立索引。如 where a = 1 or b = 2 优化为 where a = 1 … union … where b = 2, key(a), key(b)。【建议】分页查询,当 limit 起点较高时,可先用过滤条件进行过滤。如 a, b, c from t1 limit 10000, 20; 优化为: a, b, c from t1 where id > 10000 limit 20;。多表连接【强制】禁止跨 DB 的 join 语句。因为这样可以减少模块间耦合,为数据库拆分奠定坚实基础。【强制】禁止在业务的更新类 SQL 语句中使用 join,比如 t1 join t2 …。【建议】不建议使用子查询,建议将子查询 SQL 拆开结合程序多次查询,或使用 join 来代替子查询。【建议】线上环境,多表 join 不要超过 3 个表。【建议】多表连接查询推荐使用别名,且 列表中要用别名引用字段,数据库.表格式,如 a from db1. where …。【建议】在多表 join 中,尽量选取结果集较小的表作为驱动表mysql创建表默认值,来 join 其它表。事务【建议】事务中 ||| 语句操作的行数控制在 2000 以内,以及 where 子句中 in 列表的传参个数控制在 500 以内。【建议】批量操作数据时,需要控制事务处理间隔时间,进行必要的 sleep,一般建议值 5-10 秒。【建议】对于有 属性字段的表的插入操作,并发需要控制在 200 以内。【强制】程序设计必须考虑“数据库事务隔离级别”带来的影响,包括脏读、不可重复读和幻读。线上建议事务隔离级别为 -read。【建议】事务里包含 SQL 不超过 5 个(支付业务除外)。因为过长的事务会导致锁数据较久,MySQL 内部缓存、连接消耗过多等雪崩问题。【建议】事务里更新语句尽量基于主键或 key,如 … where id = XX;,否则会产生间隙锁,内部扩大锁定范围,导致系统性能下降,产生死锁。【建议】尽量把一些典型外部调用移出事务mysql创建表默认值,如调用 Web ,访问文件存储等,从而避免事务过长。【建议】对于 MySQL 主从延迟严格敏感的 语句,请开启事务强制访问主库。排序和分组【建议】减少使用 order by,和业务沟通能不排序就不排序,或将排序放到程序端去做。order by、group by、 这些语句较为耗费 CPU,数据库的 CPU 资源是极其宝贵的。【建议】order by、group by、 这些 SQL 尽量利用索引直接检索出排序好的数据。如 where a = 1 order by 可以利用 key(a, b)。【建议】包含了 order by、group by、 这些查询的语句,where 条件过滤出来的结果集请保持在 1000 行以内,否则 SQL 会很慢。线上禁止使用的 SQL 语句【高危】禁用 | t1 … where a = XX limit XX; 这种带 limit 的更新语句。因为会导致主从不一致,导致数据错乱。建议加上 order by PK。【高危】禁止使用关联子查询,如 t1 set … where name in( name from user where …);,效率极其低下。【强制】禁用 、、、views、event、外键约束。因为他们消耗数据库资源,降低数据库实例可扩展性。推荐都在程序端实现。【强制】禁用 into … on key … 在高并发环境下,会造成主从不一致。【强制】禁止联表更新语句,如 t1, t2 where t1.id = t2.id …。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » MySQL 数据库设计规范

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码