双旋网络
【SQL】Mysql中一条sql语句的执行过程

【SQL】Mysql中一条sql语句的执行过程
体系结构
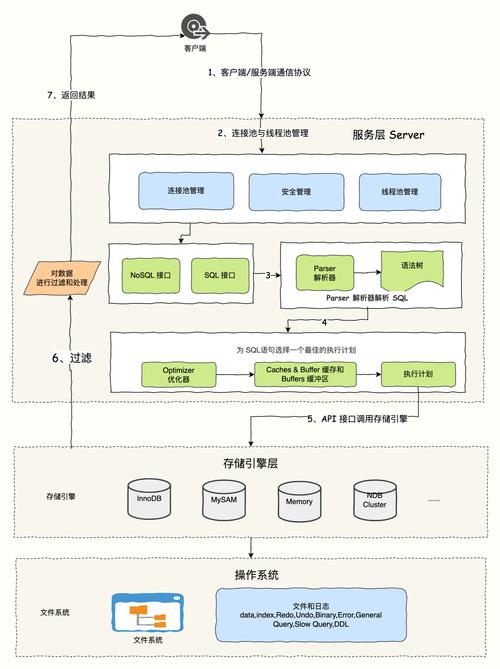
先来看下MySQL的体系结构,下图是在MySQL官方网站上扒下来的,所以有很高的权威性和准确性。
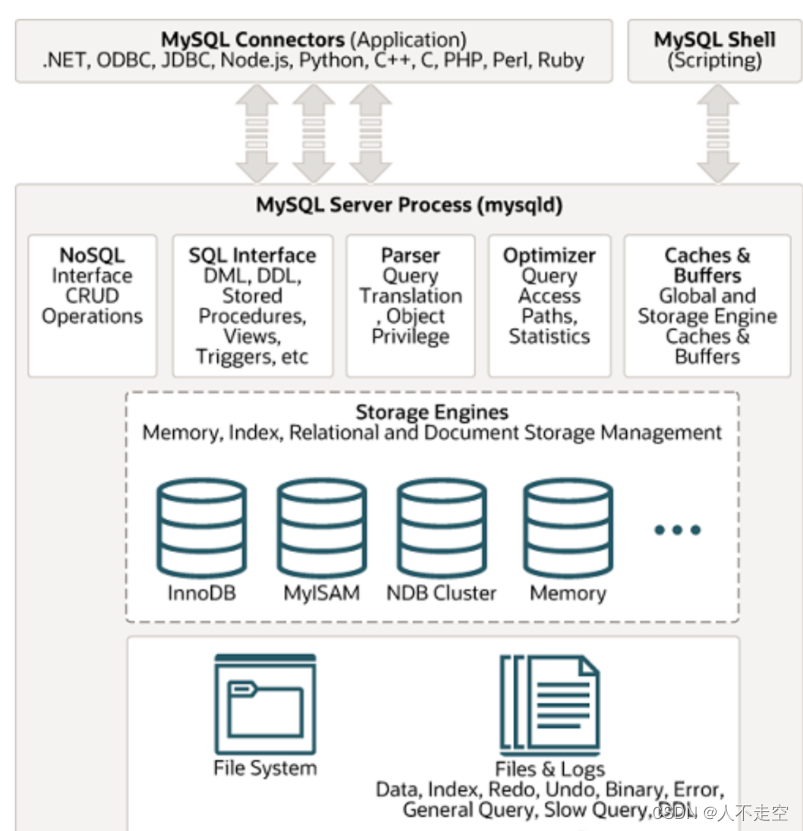
通过这张图,我们可以直观的看到MySQL的内部结构,包括连接器、缓存、解析器、优化器、存储引擎以及支持DDL、DML、存储过程、视图等功能的SQL接口。接下来,通过一条sql语句的执行来深入了解MySQL各个组件功能以及其作用。
一、SQL语句的执行流程1、连接MySQL
通常我们会编写sql语句通过某个客户端来执行并且接受执行结果,比如命令行、JDBC、。但是在执行前肯定需要先和MySQL服务成功建立连接,这个就是「连接器」的工作。
这里通过命令行的方式MySQL服务建立连接,命令如下:
命令连接的是本地的MySQL服务,在输入密码后,连接器会验证用户和密码,如果验证失败会给客户端响应拒绝访问的信息。
MySQL客户端连接
验证成功后,连接器会与该客户端成功建立连接并且读取该用户的权限,用户之后的操作都会基于权限进行控制。
那么用户名和密码以及权限在哪存储呢?
在MySQL中,除了开发人员创建的业务库,还有支撑自己运行的系统库,包括mysql、sys、、,用户信息就存储在mysql这个库。
MySQL系统库
当然,MySQL的连接数也是有限制的,这个可以通过参数控制。
也可以通过 show 查看当前连接的客户端。
MySQL [mysql]> show processlist;
+------+------+-----------------+-------+---------+------+----------+------------------+
| Id | User | Host | db | Command | Time | State | Info |
+------+------+-----------------+-------+---------+------+----------+------------------+
| 1156 | root | 127.0.0.1:61223 | mysql | Query | 0 | starting | show processlist |
+------+------+-----------------+-------+---------+------+----------+------------------+2、查询缓存
当成功建立连接后mysql sql语句优化总结,客户端就可以向MySQL服务发送sql语句了,「SQL接口」就像我们写的一样会接收到sql语句,如果是 语句,将会去「缓存」中检索结果响应给客户端。
有些博客的说法是在解析后才查询缓存,这种说法是不严谨的,这里抛出官方的说明“如果收到相同的语句,服务器将从查询缓存中检索结果,而不是解析并再次执行该语句”
同时在该说明中可以看到“从MySQL 5.7.20开始,查询缓存已被弃用,并在MySQL 8.0中被删除。”这个注释。按照官方的说法是“缓存只适用于表数据不会经常变动的场景,如果表数据经常更新(很明显大多是这个场景),缓存命中率低下,加上频繁的维护缓存,有时候造成的问题比解决的问题还要多,缓存的功能就显得比较鸡肋了。”
3、解析SQL语句
在经过缓存后,就由「解析器」开始工作了,解析器的目的是检查sql语句是否正确以及将sql语句解析成MySQL能够理解的结构,也就是sql语法树。
像 id from 这条sql语句就会在解析时报错,因为没有识别到 这个关键字(对列名、表名的检查和验证是在预处理阶段)。
.png
SQL解析报错
而像 id from 这条sql语句会被解析成下图:
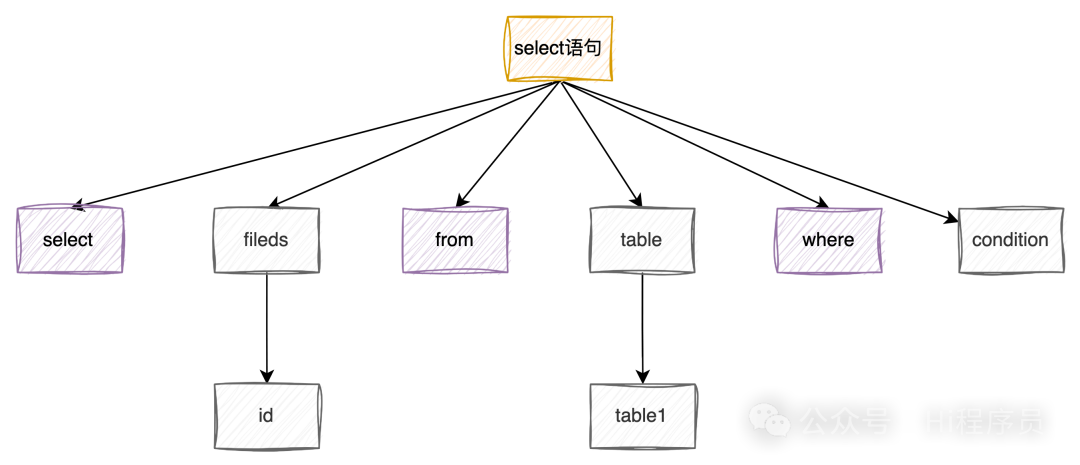
解析树
如果想了解具体的解析过程可以参考这篇博客
4、优化SQL语句
通过解析器生成sql语法树后就到了「优化器」阶段了,sql如何执行、使不使用索引、使用哪个索引都是在这个阶段处理,《MySQL优化的底层逻辑》中有写到,这里不过多赘述。
5、执行SQL语句
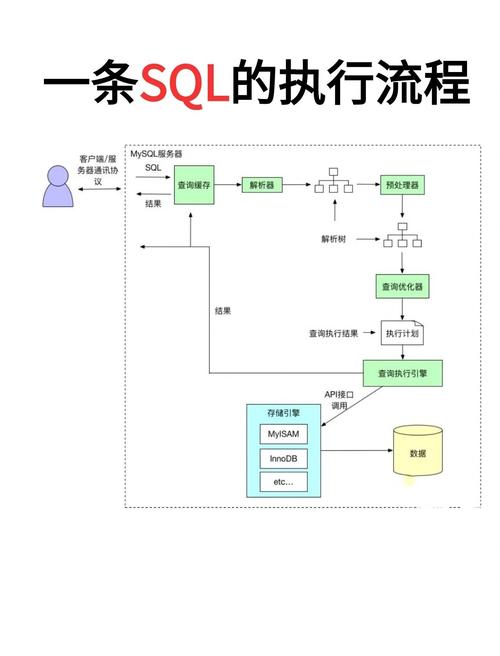
经过「优化器」后最终生成一个最优的执行计划交给「执行器」来执行,执行器通过调用「存储引擎」的接口来获取数据。
这里先不展开执行器与存储引擎的交互,后面的文章会详细阐述一下。
至此,一条查询语句的执行流程已经非常清晰了,同时也认识了MySQL的整个体系结构以及各组件的作用。最后用一张图来收尾本文的核心内容并做总结。
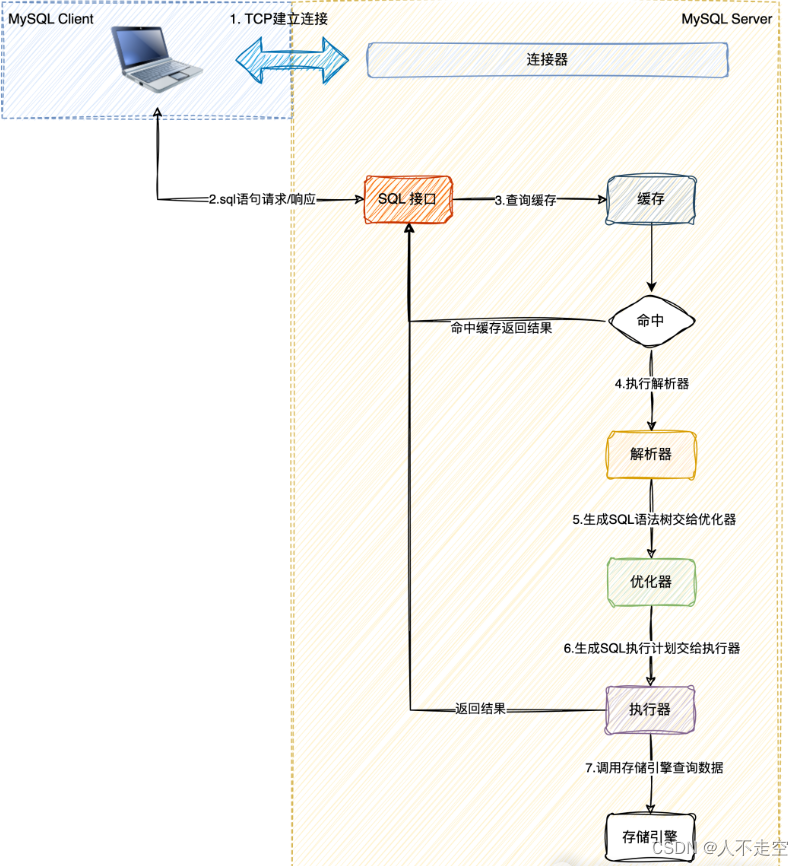
一条查询SQL语句的执行流程:
客户端通过连接器连接MySQL服务。 连接成功后向SQL接口发送SQL语句请求。 SQL接口接收到SQL查询语句会先去缓存查询,如果命中返回给客户端,否则交给解析器。 解析器在拿到SQL语句后会判断语法是否正确,正确会生成sql语法树交给优化器,否则报错给客户端。 优化器会根据sql语法树生成一个最优的执行计划交给执行器执行。 执行器拿到执行计划调用存储引擎来获取数据响应给客户端。 完成!!! 二 语句分析2.1 查询语句
说了以上这么多,那么究竟一条 sql 语句是如何执行的呢?其实我们的 sql 可以分为两种,一种是查询,一种是更新(增加,更新,删除)。我们先分析下查询语句,语句如下:
select * from tb_student A where A.age='18' and A.name=' 张三 ';结合上面的说明,我们分析下这个语句的执行流程:
2.2 更新语句
以上就是一条查询 sql 的执行流程,那么接下来我们看看一条更新语句如何执行的呢?sql 语句如下:
update tb_student A set A.age='19' where A.name=' 张三 ';我们来给张三修改下年龄,在实际数据库肯定不会设置年龄这个字段的【SQL】Mysql中一条sql语句的执行过程【SQL】Mysql中一条sql语句的执行过程,不然要被技术负责人打的。其实条语句也基本上会沿着上一个查询的流程走,只不过执行更新的时候肯定要记录日志啦,这就会引入日志模块了,MySQL 自带的日志模块式 (归档日志) ,所有的存储引擎都可以使用,我们常用的 引擎还自带了一个日志模块 redo log(重做日志),我们就以 模式下来探讨这个语句的执行流程。流程如下:
这里肯定有同学会问,为什么要用两个日志模块mysql sql语句优化总结,用一个日志模块不行吗?
这是因为最开始 MySQL 并没与 引擎( 引擎是其他公司以插件形式插入 MySQL 的) ,MySQL 自带的引擎是 ,但是我们知道 redo log 是 引擎特有的,其他存储引擎都没有,这就导致会没有 crash-safe 的能力(crash-safe 的能力即使数据库发生异常重启,之前提交的记录都不会丢失)mysql sql语句优化总结, 日志只能用来归档。
并不是说只用一个日志模块不可以,只是 引擎就是通过 redo log 来支持事务的。那么,又会有同学问,我用两个日志模块,但是不要这么复杂行不行,为什么 redo log 要引入 预提交状态?这里我们用反证法来说明下为什么要这么做?
如果采用 redo log 两阶段提交的方式就不一样了,写完 后,然后再提交 redo log 就会防止出现上述的问题,从而保证了数据的一致性。那么问题来了,有没有一个极端的情况呢?假设 redo log 处于预提交状态, 也已经写完了,这个时候发生了异常重启会怎么样呢? 这个就要依赖于 MySQL 的处理机制了,MySQL 的处理过程如下:
这样就解决了数据一致性的问题。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » 【SQL】Mysql中一条sql语句的执行过程

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码