双旋网络
Redis从入门到放弃(9):集群模式

前面文章我们介绍了Redis的主从模式是一种在Redis中实现高可用性的方式,但也存在一些缺点。
1、主从模式缺点2、集群的原理
Redis集群是3.0版本提出的一种分布式解决方案。其大致原理是通过分片()和数据复制来实现数据的分布和高可用性。下面是Redis集群的基本原理:
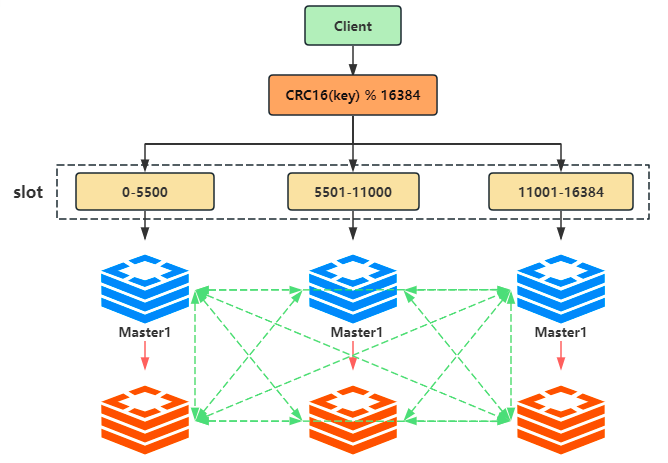
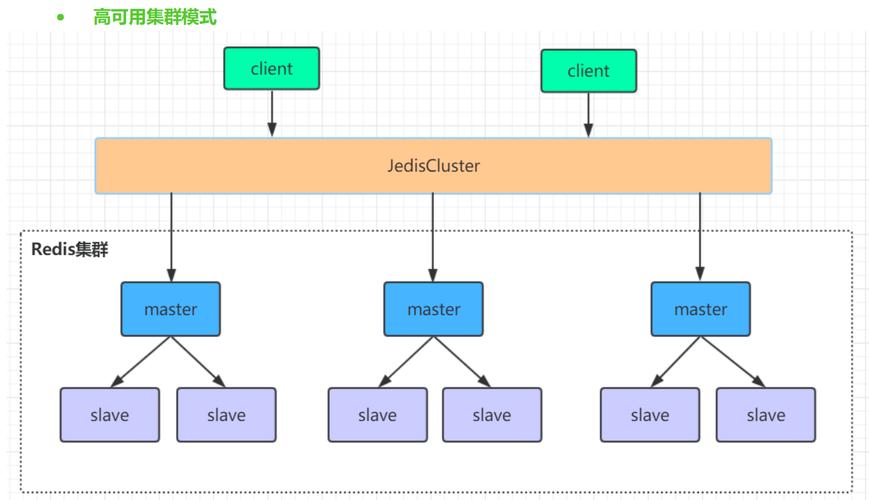
数据分片: Redis集群使用哈希槽(hash slot)分片策略,将整个数据空间划分为固定数量的哈希槽。每个节点负责管理一部分哈希槽,而不是管理具体的键值对。 数据分布: 客户端将键通过哈希函数映射到某个哈希槽,然后找到负责该哈希槽的节点。这样,数据被均匀地分布在不同的节点上。 数据复制: 为了提供高可用性,每个主节点都有多个从节点。主节点会将自己的数据异步复制到从节点,以保持数据的一致性。从节点可以处理读请求,也可以在主节点宕机时升级为新的主节点。 故障检测与转移: Redis集群引入了哨兵()节点,用于监控主节点的状态。当主节点宕机或无法访问时,哨兵会发起选举,选择一个从节点升级为新的主节点,从而实现故障转移。 故障恢复: 当主节点恢复时,它会成为从节点,从新的主节点进行数据同步。这种方式可以确保在节点故障恢复后,数据能够重新同步,保持一致性。 动态扩展: 当需要扩展集群规模时Redis从入门到放弃(9):集群模式,可以增加新的节点,调整哈希槽的分配信息,并在新节点上进行数据迁移。这样集群可以根据需求进行动态扩展,以适应不断增长的数据和流量。 节点通信:集群中每个节点都需要知道其他所有节点的状态信息,包括当前集群状态、集群中各节点负责的哈希槽、集群中各节点的-slave状态、集群中各节点的存活状态等。Redis集群中,节点之间通过建立TCP连接,使用协议来传播集群的信息。 3、数据分区原理
分布式数据存储首先要解决整个数据集如何按照分区规则划分到多个节点问题Redis从入门到放弃(9):集群模式,每个节点负责整个数据集的子集。常见的分区规则有3种:哈希取余分区、一致性哈希算法分区和哈希槽分区。
3.1、哈希取余分区
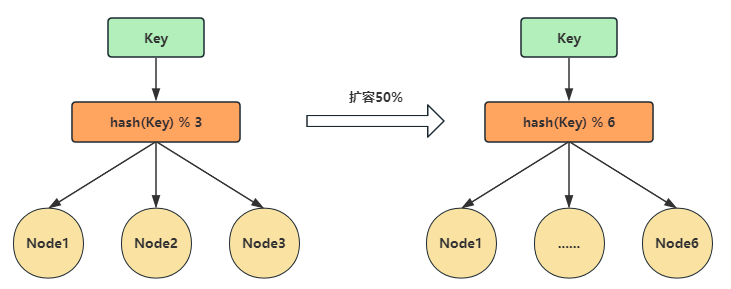
这是最简单的分区方案。数据的键(Key)通过哈希函数得到一个哈希值,然后将哈希值与节点数量(N)取余,以确定数据属于哪个节点。公式:hash(Key) % N
这种方式的优点是 简单,一般采用 预分区 的方式,提前根据 数据量 规划好 分区数,比如划分为 512 或 1024 张表,保证可支撑未来一段时间的 数据容量。扩容时通常采用 翻倍扩容,避免 数据映射 全部被 打乱redis 集群解决方案,导致 全量迁移 的情况。常用于 数据库 的 分库分表。
当 节点数量 变化时,如 扩容 、**收缩 **、 宕机 节点,数据节点 映射关系 需要重新计算redis 集群解决方案redis 集群解决方案,会导致数据的 重新迁移。
3.2、一致性哈希算法分区
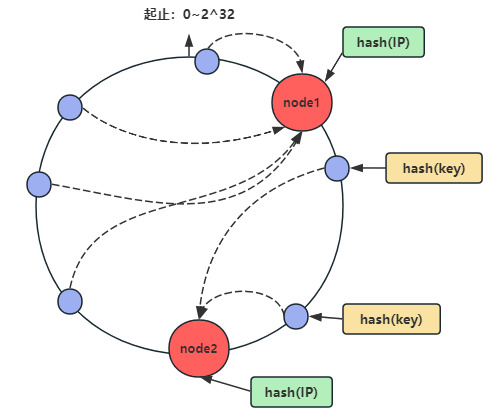
一致性哈希算法就是将整个哈希值空间组织成一个虚拟的圆环,哈希函数的值空间为0~2^32-1(即哈希值是一个32位无符号整形)。
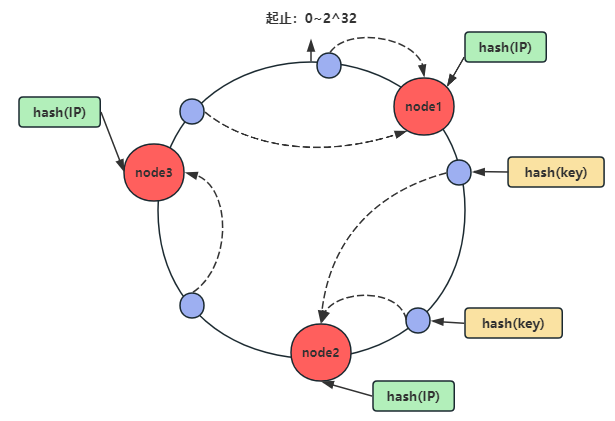
上图为将node1、node2、node3服务器的IP作为唯一关键字,使用Hash(IP)进行哈希,这样每台机器就能确定其在哈希环上的位置。
key落键规则:当我们需要存储一个kv键值对时,首先计算key的hash值(hash(key))将这个key使用相同的哈希函数计算出哈希值,并确定此数据在环上的位置,从此位置沿环顺时针“行走”,第一台遇到的服务器就是其应该定位到的服务器,并将该键值对存储在该节点上,如上图所示。
容错性:若node2挂掉,受影响的数据只有node1和node2之间的数据,且这些数据会转移到node3存储。
扩展性:若在node1和node2之间增加一台node4,受影响的数据只有node1和node4,重写把node1到node4的数据录入到node4即可。
不会导致hash取余数据重新洗牌计算。
数据倾斜:若节点太少且分布不均匀时,会造成大部分数据集中存放在某一台上的问题,如下图所示,大部分数据都会存放在node1上:
3.3、 哈希槽分区(Redis集群方案)
为了解决数据倾斜的问题,.0中引入了哈希槽的概念。
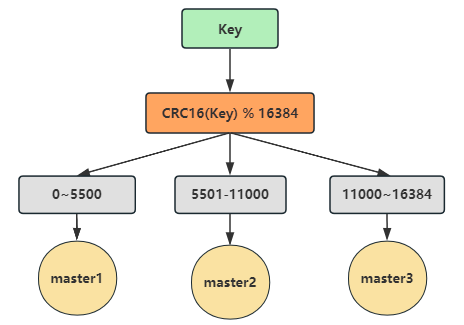
Redis集群有16384个哈希槽,集群会先给每个节点分配一部分哈希槽。比如当前集群有3个节点:
进行set操作时,每个key会通过CRC16校验后再对16384取模来决定放置在哪个槽,比如 CRC16(key) % 16384 = 777,那么这个key就会被分配到节点上,如下图:
4、Redis集群的MOVED重定向
因为Redis客户端可以向集群中的 **任意节点 **发送指令,那么如果数据没有存放在接收到指令的节点上,怎么办呢?
MOVED重定向:
当Redis节点接收到相关指令时,会先计算key落在哪个哈希槽上,如果恰好在自己节点上,那么就直接处理指令并返回结果;
如果key计算出的哈希槽不在自己节点上,那么当前节点就会查看它内部维护的 **哈希槽 **与 **节点ID **之间的映射关系,然后给客户端返回一个MOVED错误:
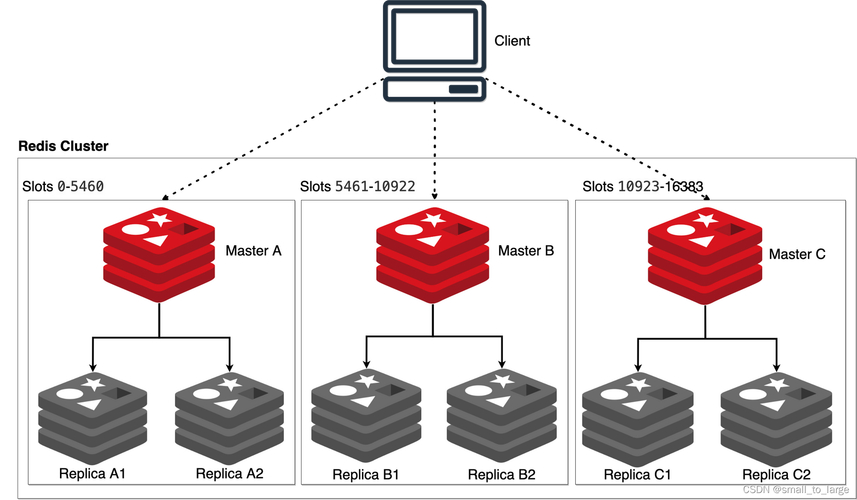
这个错误包含操作的key所属的 **哈希槽 **和能处理这个请求的Redis节点的 **IP **和 **端口号 **,例如“MOVED 3999 127.0.0.1:6379”,客户端需要根据这个信息重新发送查询指令到给定的IP和端口的Redis节点。就完成了MOVED重定向操作。
5、配置集群
准备6台机器,三主三从。
5.1、删除持久化文件
删除原目录下的RDB、AOF格式的文件。
cd /home/redis
rm *.rdb *.aof
5.2、配置redis.conf
对6各节点的redis.conf都做如下配置:
# 开启集群模式
cluster-enabled yes
# 每一个节点需要有一个配置文件,需要6份。每个节点处于集群的角色都需要告知其他所有节点,彼此知道,这个文件用于存储集群模式下的集群状态等信息,这个文件是由redis自己维护,我们不用管。如果你要重新创建集群,那么把这个文件删了就行
cluster-config-file nodes-6379.conf
# 超时时间,超时则认为master宕机,随后主备切换
cluster-node-timeout 5000
5.3、启动所有服务
cd src
redis-server ../redis.conf
5.4、创建集群
执行命令:redis-cli
#####
# 注意1:如果你使用的是redis3.x版本,需要使用redis-trib.rb来构建集群
# 注意2:以下为新版的redis构建方式
#####

# 创建集群,-a 123456是指redis密码, cluster-replicas是指主节点和从节点比例为1,1-3为主,4-6为从,一个主节点对应一个从节点,这也是最经典用的最多的集群模式
redis-cli -a 123456 --cluster create 192.168.1.201:6379 192.168.1.202:6379 192.168.1.203:6379 192.168.1.204:6379 192.168.1.205:6379 192.168.1.206:637 --cluster-replicas 1
6、 2.X 集成Redis集群
spring:
  application:
    name: test.redis
  redis:
    jedis:
      pool:
        #最大连接数据库连接数,设 0 为没有限制
        max-active: 8
        #最大等待连接中的数量,设 0 为没有限制
        max-idle: 8
        #最大建立连接等待时间。如果超过此时间将接到异常。设为-1表示无限制。
        max-wait: -1ms
        #最小等待连接中的数量,设 0 为没有限制
        min-idle: 0
    lettuce:
      pool:
        max-active: 8
        max-idle: 8
        max-wait: -1ms
        min-idle: 0
      shutdown-timeout: 1000ms
    cluster:
      # 此处需要配置每个实例的节点
      nodes: 192.168.1.201:6379 192.168.1.202:6379 192.168.1.203:6379 192.168.1.204:6379 192.168.1.205:6379 192.168.1.206:637
	#密码
    password: 123456
server:
port: 80801. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » Redis从入门到放弃(9):集群模式

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码