双旋网络
带你读Mysql技术内幕[2]——InnoDB引擎概述

本文是自己的阅读《Mysql技术内幕——存储引擎》的笔记,主要是为了将阅读和实践结合起来,途中会穿插自己的理解及自己工作中的实践。
1. 存储引擎概述
是目前mysql使用最广泛,具有的特点有:
行锁设计
支持MVCC
支持事务
支持外键等
一致性非锁定读取
……
2. 体系结构
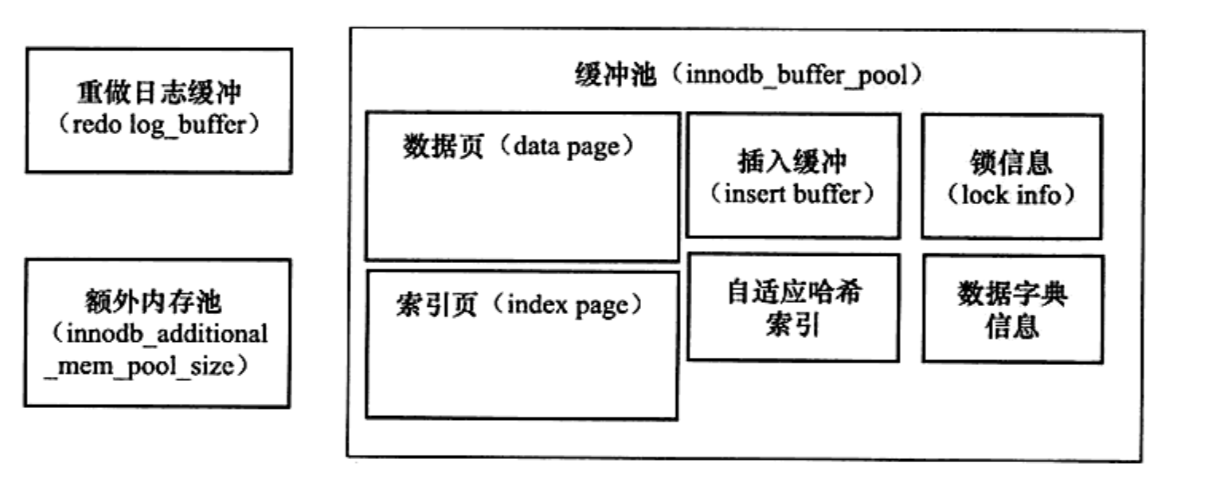
一张图展示体系结构
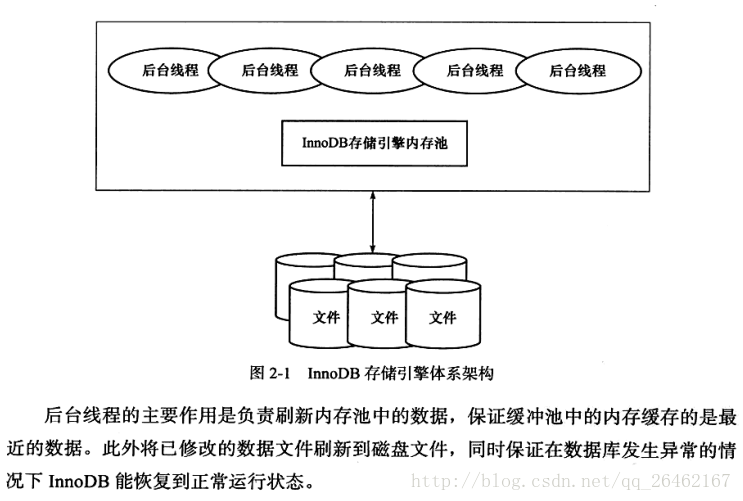
有多个内存块,组成了一个大的内存池,主要负责的工作如下:
主要负责工作
维护所有进程/线程需要访问的多个内部数据结构缓存磁盘上的数据, 方便快速读取, 同时在对磁盘文件修改之前进行缓存重做日志(redo log)缓冲 2.3.1 后台线程
后台线程主要工作是负责刷新内存池中的数据,保证缓存池中的内存缓存是最新的数据。
默认情况下,存储引擎的后台线程:
**后台线程主要组成: **
可以通过如下命令查看InnoDB的IO Thread情况
SHOW ENGINE INNODB STATUSG;
- 1
- 2
2.3.2 内存
因为存储引擎是基于磁盘存储的带你读Mysql技术内幕[2]——InnoDB引擎概述,并且是按照页的方式进行管理,但是呢,cpu速度比磁盘的读写速度压根不在一个数量级别,因此加入一层缓存池(内存)来调解中间的速度差矛盾。(看来整个计算机领域到处都体现了,缓存思想)
主要组成
1. 缓冲池( pool)
主要作用:用于提高数据库的整体性能,为了协调CPU速度和磁盘速度相差较大的问题,比如查询数据时,如果是第一次查询则直接取磁盘中查,然后将结果缓存到缓存池中;下次再查询时,直接从缓存池中取,而不需要再读取速度较慢的磁盘。缓冲池大小与性能也息息相关,可以通过如下命令查看缓冲池大小:ize
- 缓冲池中数据页的类型有:索引页、数据页、undo页、插入缓冲(Insert Buffer)、自适应哈希、锁等
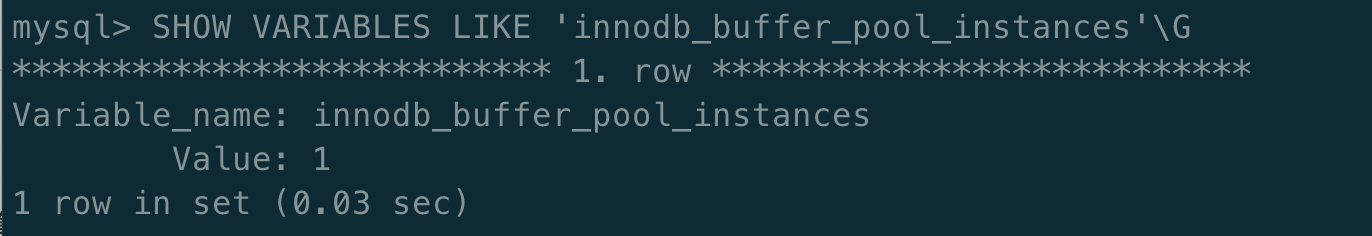
- 可以用如下命令查询缓冲池个数,因为可以建立多个缓冲池实例 ```SHOW VARIABLES LIKE 'innodb_buffer_pool_instances'G;```。默认大小1
- 1
- 2
– 可以通过如下命令设置缓冲池大小SHOW LIKE 'ize'G;
2. LRU list、Free List和Flush list
**主要介绍:存储引擎是如何对内存区域进行管理的?**比如内存的淘汰策略是什么样的,如果回收管理内存啊
使用(LRU)最少使用算法对缓冲池进行管理。最频繁使用的元素放在链表的顶端,但是Innodb并不是直接将最近使用的元素放在顶端,而是通过设置一个`midpoint`来决定插入的位置,最新读取的位置先放到`midpoint`处,**默认配置中,该位置在LRU列表长度的5/8处。**
- 1
SHOW LIKE 't'来控制
思考:为什么不采用朴素的LRU算法?
答:因为如果直接将读取的页放在LRU的首部,则SQL操作可能会使缓冲池中的页刷出,导致热点数据从缓冲池中移除,下次来查询时还是需要查询磁盘,从而影响缓冲池的效率。比如索引或者数据扫描操作时,通常访问的数据较多,而这些数据只是这次使用,并不是热点数据,如果每次将数据放到首部,则可能将热点数据给刷新出去,下次访问热点数据时,还是得去磁盘查询,这就没有起到缓存的作用了。
- 1
为了解决上述问题mysql技术内幕 innodb存储引擎,引入了me来管理LRU列表,用于表示页读取到mid位置后需要等待多久才会被加入到LRU列表的热端。
可以通过SHOW 来查看LRU列表及Free列表的使用情况。
LUR列表:用来管理已经读取的页
Free列表:用来管理保存空闲页
这里还可以看到一个关键的指标:mysql缓存命中率: pool hit rate
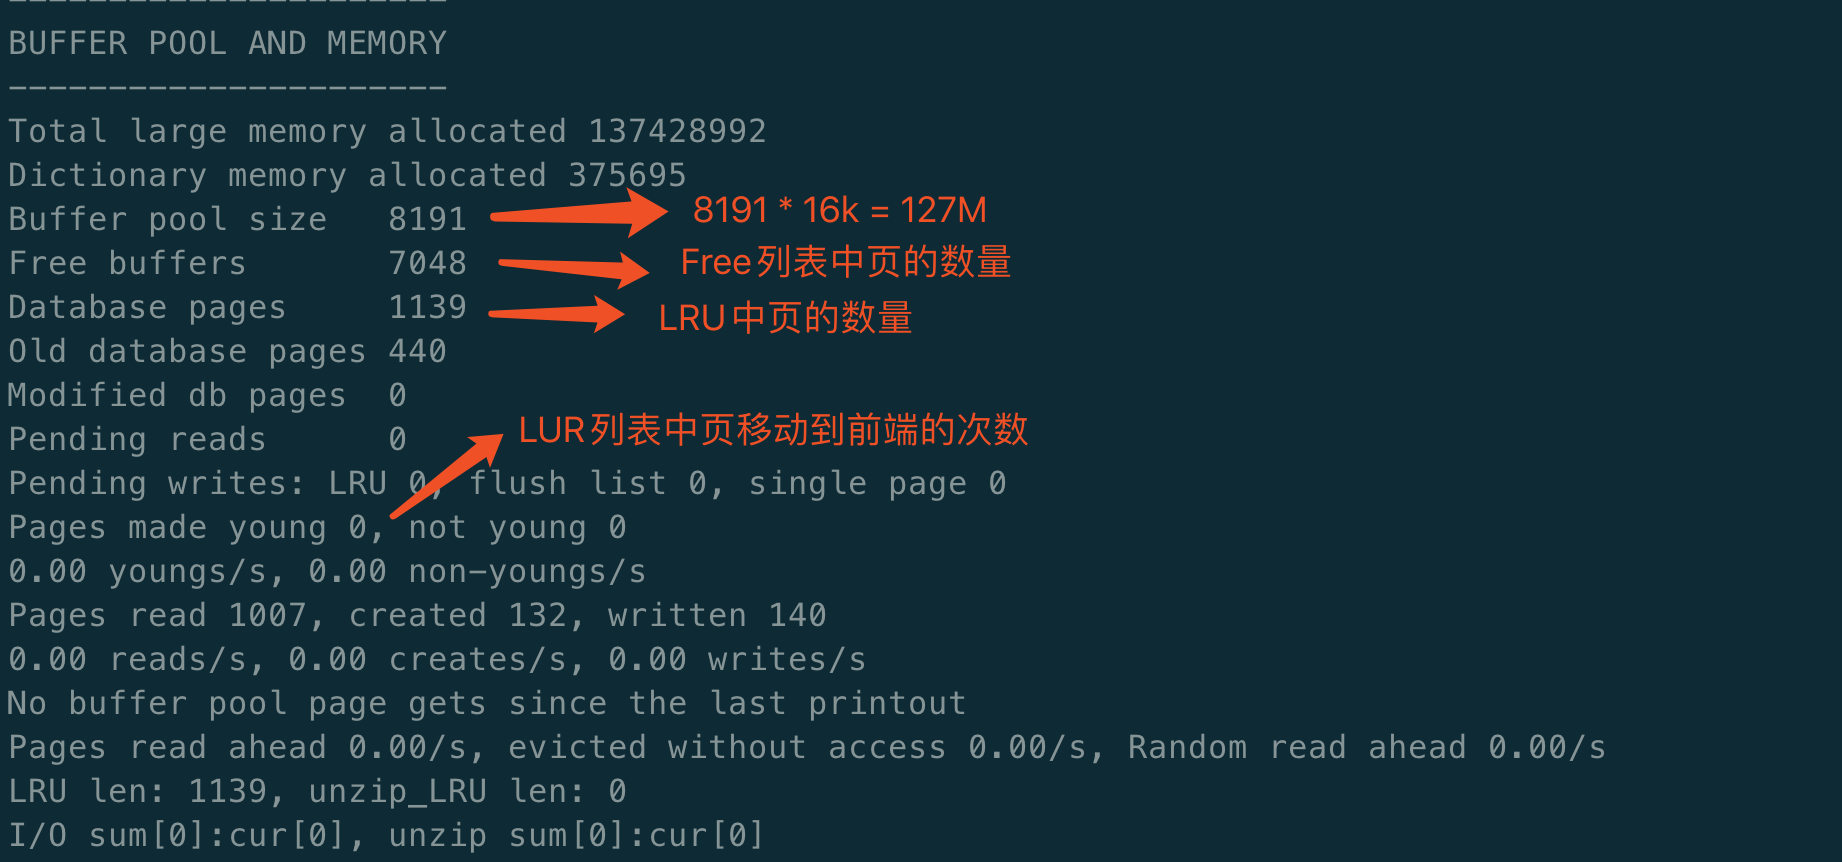
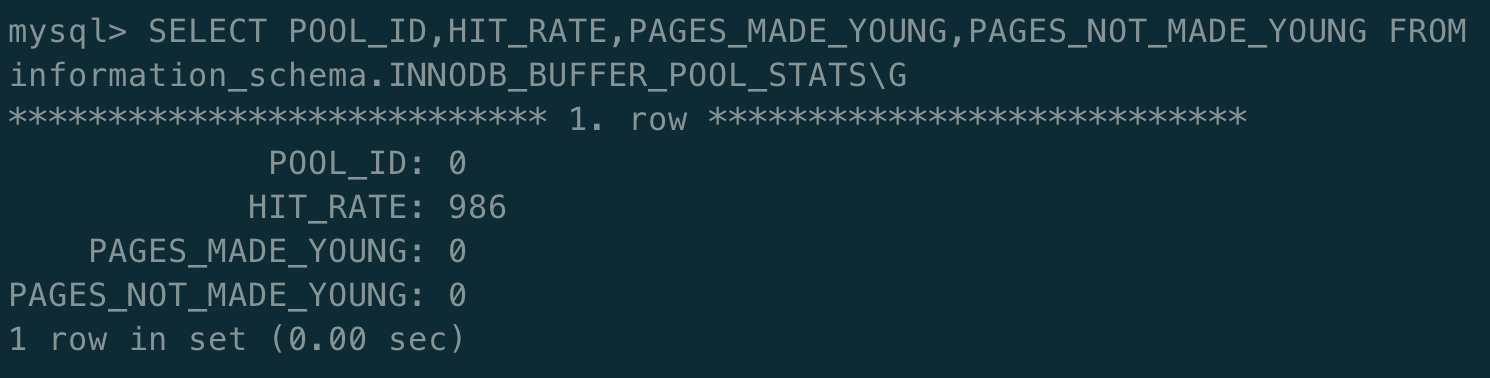
也可以通过如下命令来查看缓冲池的情况
SELECT POOL_ID,HIT_RATE,PAGES_MADE_YOUNG,PAGES_NOT_MADE_YOUNG
FROM information_schema.INNODB_BUFFER_POOL_STATSG;
- 1
- 2
当LRU列表中页数据被修改之后,导致LRU中数据和磁盘中数据不一致,这种情况称为脏页。而通过将数据刷回磁盘中
3. 重做日志缓冲池(redo log )
存储引擎一般将重做日志信息先放到这个缓冲区,然后按照一定频率将其刷新到重做日志文件中。该值由配置参考ze控制,默认大小是8M
// 查看
SHOW VARIABLES LIKE 'innodb_log_buffer_size'G';
- 1
- 2
一般出现下面三种情况会将重做日志缓冲中的内容刷新到外部磁盘中的重做日志文件中:
4. 额外的内存池( pool)
对数据结构本身的内存进行分配时,就是利用额外的内存池
下图展示的内存数据结构
3 技术
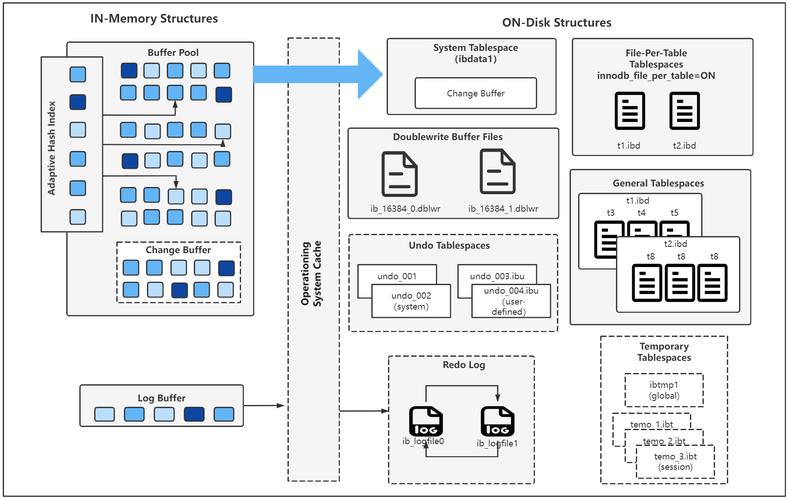
缓冲池主要的目的是解决CPU和磁盘速度的极大差距,每次修改都先修改缓冲池数据,缓冲池数据比磁盘数据新,为了能够高效解决该问题,提出该技术。
可以想一下,如果每次更新数据都将缓冲池中的数据刷新到磁盘中,性能必然会很低。
提出的原因:
为了解决以上的矛盾,当前事务数据库都采用 Write Ahead Log策略,即当事务提交时,先写重做日志,再修改日志。如果发生了宕机,则可以利用重做日志来恢复数据。
该技术解决的问题 缩短数据库恢复时间缓冲池不够用时,将脏页刷新到磁盘(保证缓冲池和磁盘数据一致)重做日志不可用时,刷新脏页。(因为重做日志不可能无限扩大,而是循环使用的)
每次数据库发生宕机时,数据库不需要重写所有的日志,只需要将之后的数据进行恢复即可,这样恢复的时间较短。
并且当缓冲池不够用时,会强制执行,将脏页刷新到磁盘中。
存储引擎有两种
4.
将缓冲池中的数据异步刷新到磁盘中,保证数据的一致性。
3.1 源码分析(1.x之前)
内部组成
主循环(loop)后台循环( loop)刷新循环(flush loop)暂停循环( loop)
主循环
主要包括每秒钟的操作和每10秒钟的操作
void master_thread(){
loop:
for(int i= 0; i<10; i++){
   do thing once per second
   sleep 1 second if necessary
}
do things once per ten seconds
goto loop;
}
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
每秒一次的操作包括:
日志缓冲刷新到磁盘,即使这个事务还没有提交(总是);合并插入缓冲(可能,IO次数是否小于5次,如果小于5次,引擎认为服务器I/O压力较小,则开始合并操作);至多刷新100个的缓冲池中的脏页到磁盘(可能,判断当前缓冲池中脏页比例是否超过配置文件中,如果超过,则刷入100脏页到磁盘);如果当前没有用户活动,则切换到 loop(可能)。
每一秒中的伪代码
void master_thread(){
   goto loop;
loop:
for(int i = 0; i<10; i++){
   thread_sleep(1) // sleep 1 second
   do log buffer flush to disk				// 每一秒都执行刷新操作
   if (last_one_second_ios < 5 )			// io次数是否小于5次
      do merge at most 5 insert buffer
   if ( buf_get_modified_ratio_pct > innodb_max_dirty_pages_pct )			// 脏页比率是否大于设定的值
      do buffer pool flush 100 dirty page
   if ( no user activity )				// 是否有用户活动
      goto backgroud loop
}
do things once per ten seconds
background loop:
   do something
   goto loop:
}
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
接下来可以看每10秒钟的操作:
刷新100个脏页到磁盘(可能,判断过去10秒之内磁盘的IO操作是否小于200次,如果是,刷新到磁盘);合并至多5个插入缓冲(总是);将日志缓冲刷新到磁盘(总是);删除无用的Undo页(总是)do full purge;刷新100个或者10%的脏页到磁盘(总是)(如果脏页比例超过70%,则刷新100页到磁盘,如果比例小于70%,则刷新10%到磁盘)。产生一个检查点(总是)
主循环完整的伪代码
void master_thread(){
   goto loop;
loop:
// 每一秒的操作
for(int i = 0; i<10; i++){
   thread_sleep(1) // sleep 1 second
   do log buffer flush to disk
   if (last_one_second_ios < 5 )
      do merge at most 5 insert buffer
   if ( buf_get_modified_ratio_pct > innodb_max_dirty_pages_pct )
      do buffer pool flush 100 dirty page
   if ( no user activity )
      goto backgroud loop
}
// 没10s的操作
if ( last_ten_second_ios < 200 )
   do buffer pool flush 100 dirty page
do merge at most 5 insert buffer
do log buffer flush to disk
do full purge
if ( buf_get_modified_ratio_pct > 70% )
   do buffer pool flush 100 dirty page
else
   buffer pool flush 10 dirty page
goto loop
background loop:
   do something
goto loop:
}
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
- 29
接下来看后台循环
当前没有用户活动(数据库空闲时)或者数据库关闭(),就会切换到这个循环。
主要操作
删除无用的Undo页(总是);合并20个插入缓冲(总是);跳回到主循环(总是);不断刷新100个页直到符合条件(可能,跳转到flush loop中完成)
若flush loop中也没有什么事情可以做了,存储引擎会切换到,将 挂起,等待事件的发生。若用户启用()了存储引擎mysql技术内幕 innodb存储引擎,却没有使用任何存储引擎的表,那么 总是处于挂起的状态。
所有的伪代码
void master_thread(){
   goto loop;
loop:
for(int i = 0; i<10; i++){
   thread_sleep(1) // sleep 1 second
   do log buffer flush to disk
   if ( last_one_second_ios < 5 )
      do merge at most 5 insert buffer
   if ( buf_get_modified_ratio_pct > innodb_max_dirty_pages_pct )
      do buffer pool flush 100 dirty page
   if ( no user activity )
      goto backgroud loop
}
if ( last_ten_second_ios < 200 )
   do buffer pool flush 100 dirty page
do merge at most 5 insert buffer
do log buffer flush to disk
do full purge
if ( buf_get_modified_ratio_pct > 70% )
   do buffer pool flush 100 dirty page
else
   buffer pool flush 10 dirty page
goto loop
background loop:
do full purge
do merge 20 insert buffer
if not idle:
goto loop:
else:
   goto flush loop
flush loop:
do buffer pool flush 100 dirty page
if ( buf_get_modified_ratio_pct>innodb_max_dirty_pages_pct )
   goto flush loop
goto suspend loop
suspend loop:
suspend_thread()
waiting event
goto loop;
}
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
- 29
- 30
- 31
- 32
- 33
- 34
- 35
- 36
- 37
- 38
- 39
- 40
3.2 .x版本之前的
1.0.x版本的缺点:
无论何时 存储引擎最大只会刷新100个脏页到磁盘,合并20个插入缓冲,严重影响性能,如果服务器宕机,在恢复数据的时候刷回到磁盘时,则整个恢复持续时间较长。
针对该问题提供了一个参数,用于表示磁盘IO的吞吐量,参数为默认为200。对于刷新到磁盘页的数量,会按照的百分比来控制。规则如下:
1. 在合并插入缓冲时,合并插入缓冲的数量为 的5%
2. 从缓冲区刷新脏页时,刷新脏页的数量为
后来又引入了hing自适应刷新mysql技术内幕 innodb存储引擎,会自动大概判断一个最合适的刷新数量
3.3 1.2.x版本的
针对 进行优化,伪代码如下:
if InnoDB is idle
    srv_master_do_idle_tasks();             //之前版本的每10s操作
else
    srv_master_do_active_tasks();           //之前每一秒的操作
- 1
- 2
- 3
- 4
同时对于刷新脏页的操作,从 线程中分离到一个单独的Page (专门用于刷新缓冲池到磁盘中)提高了系统的并发性。
5. 关键特征
关键特征包括:
插入缓冲( )两次写( write)自适应哈希索引异步IO(Adync IO)刷新邻接页 1. 插入缓冲 为什么需要插入缓冲,解决什么问题?
聚集索引的记录插入一般都是顺序进行磁盘I/O,对于非聚集索引,叶子节点的插入不是顺序的,需要离散地访问非聚集索引页,进行随机磁盘的I/O,插入性能变低。
怎么做的?
对于非聚集索引的插入或更新操作,不是每一次直接插入到索引页中,而是先判断插入的非聚集索引页是否在缓冲池中,若在,则直接插人;若不在,则先放人到一个 对象中,好似欺骗数据库这
个非聚集的索引已经插到叶子节点,而实际并没有,只是存放在另一个位置。然后再以一定的频率和情况进行 和辅助索引页子节点的merge(合并)操作,这时通常能将多个插入合并到一个操作中(因为在一个索引页中),这就大大提高了对于非聚集索引插入的性能。
使用 的两个条件:
遗留了哪些问题?使用插入缓存的缺点
不过考虑这样一种情况:应用程序进行大量的插入操作,这些都涉及了不唯一的非聚集索引,也就是使用了 。若此时MySQL数据库发生了宕机,
这时势必有大量的 并没有合并到实际的非聚集索引中去。因此这时恢复可能需要很长的时间,在极端情况下甚至需要几个小时。
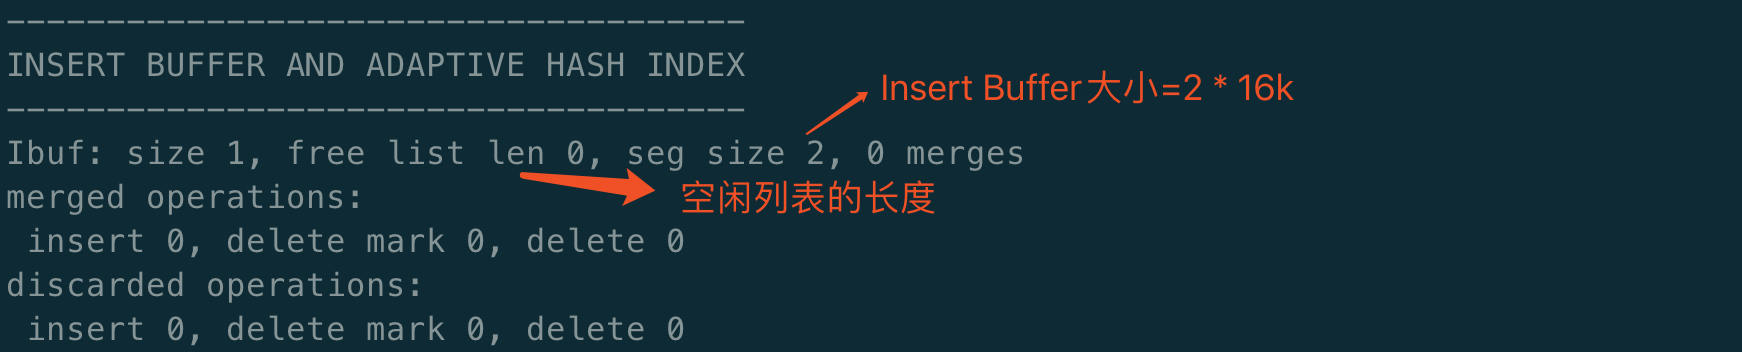
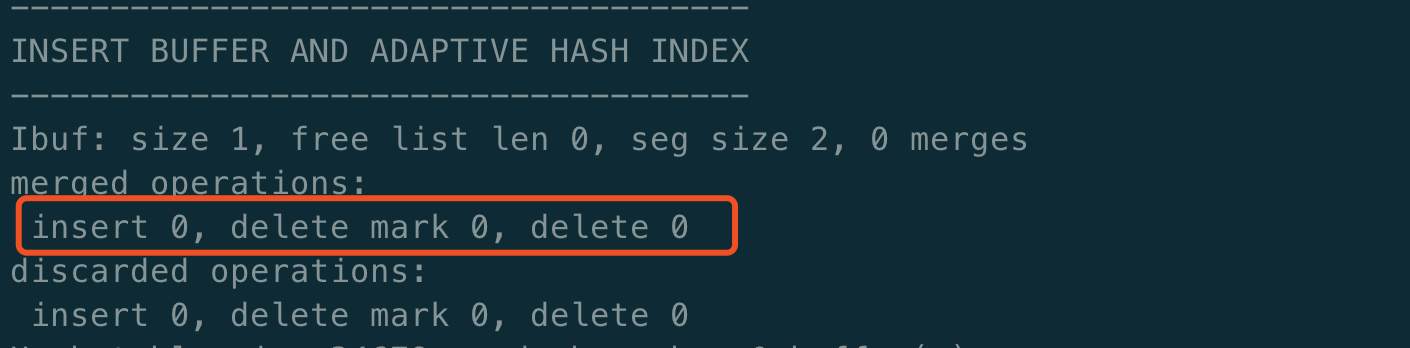
查看命令
show engine innodb statusG;
- 1
2
引入 、 、Purge 分别对 进行缓冲,可以看做是 的升级版本,这些适用的对象仍然是非唯一的非聚集索引。
show variables like 'innodb_change_buffer_max_size'G;
- 1
可以通过参数来控制 最大使用内存的数量,该值默认是25,表示最多使用1/4换缓冲池内存空间。
3 的内部实现
的使用场景:非唯一辅助索引的插入操作。
底层其实是一颗B+树
非叶子节点存放的是查询的 key(键值)
总结: 主要用于提升引擎性能。
2. 二次写() 为什么用该技术?
当发生数据库宕机时,可能存储引擎正在写入某个页到表中,而这个页只写了一部分,比如16B
的页,只写了前4KB,之后就发生了宕机,这种情况被称为部分写失效( page write)。
在存储引擎未使用技术前,曾经出现过因为部分写失效而导致数据丢失的情况。
解决了什么问题
解决的问题:提升数据页的可靠性。
下图是 write 结构
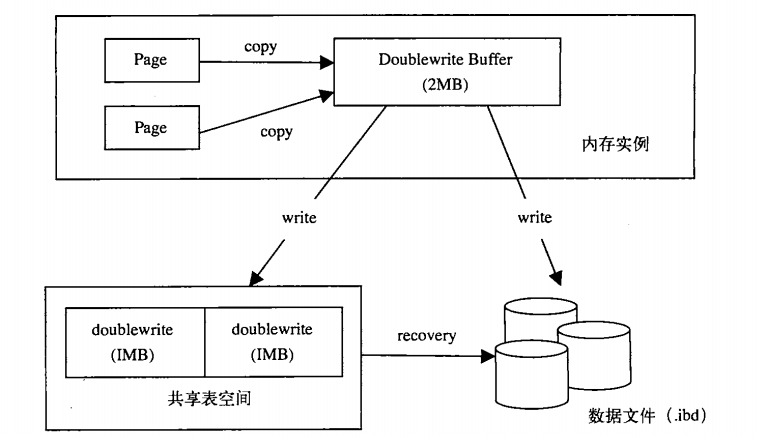
二次写基本流程:
有两部分组成,一部分是内存中的,大小为2M,另外一部分物理磁盘上的共享表空间中连续的128个页,即两个区,大小同样为2M当缓冲池的作业刷新时,并不直接写硬盘,而是通过函数将脏页先拷贝到内存中的 ,通过 再分两次写,每次写入1M到共享表空间的物理磁盘上,然后马上调用fsync函数,同步磁盘。(由于是连续的带你读Mysql技术内幕[2]——InnoDB引擎概述,属于顺序磁盘I/O,开销不是太大)再将中的数据写入到数据文件中
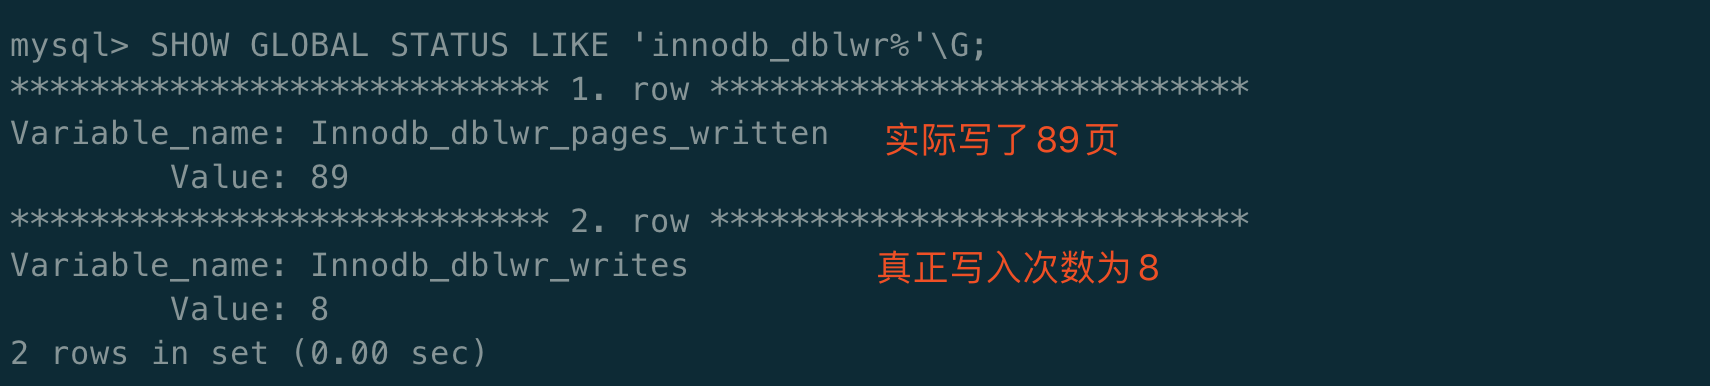
可以通过如下命令查看二次写的情况
SHOW GLOBAL STATUS LIKE 'innodb_dblwr%'G;
- 1
3. 自适应哈希 (智能) 为什么需要自适应hash? 哈希(hash) 是一种非常快的查找方法,在一般情况下这种查找的时间复杂度为0(1),即一般仅需要一次查找就能定位数据。而B+树的查找次数,取决于B+树的高度,在生产环境中,B+树的高度- -般为3~4层,故需要3~ 4次的查询。存储引擎会监控对表上各索引页的查询。如果观察到建立哈希索引可以带来速度提升,则建立哈希索引,称之为自适应哈希索引( Hash Index, AHI)。 AHI是通过缓冲池的B+树页构造而来,因此建立的速度很快,而且不需要对整张表构建哈希索引。 存储引擎会自动根据访问的频率和模式来自动地为某些热点页建立哈希索引。
因为hash索引查找很快,如果可以灵活的建立hash索引对于查找数据有很大的帮助。
由于不支持hash索引,但是在某些情况下hash索引的效率很高。
于是出现了 hash index功能,存储引擎会监控对表上索引的查找
如果观察到建立hash索引可以提高性能的时候,则自动建立hash索引。通过系统自定检测是否启动索引,不需要人工的介入。
可以通过 show G 来查看自适应哈西索引的使用情况。
可以使用来禁用和启用hash索引,默认开启。
缺点
由于hash本身的特性,hash索引只能进行等值查询,而无法进行范围查询。
4. 异步IO
为了提高磁盘操作性能,当前的数据库系统都是采用异步IO(AIO)的方式来处理磁盘操作。
在同步IO中,每次进行IO操作,都需要等待次操作结束才能继续进行的操作。
但是在异步IO中,用户可以在发出一个IO请求后立即发送另一个IO请求,当全部IO请求发送完毕后,等待所有的IO操作完成。
可以通过下面的命令来控制是否启用 AIO
o
5. 刷新临接页
工作原理:当刷新一个脏页时,会检测该页所在区()的所有页,如果是脏页,那么一起进行刷新。
6. 启动、关闭、恢复 关闭
通常有三个数表示(0,1,2)
y 通常有(0-6)
0. 代表当发生需要恢复时,进行所有的恢复操作,当不能进行有效恢复时,如数据页
发生了,MySQL数据库可能发生宕机(crash),并把错误写入错误日志中去。
总结
主要理解存储引擎的整体的概述,主要讲解了 和内存结构,又详细介绍了主要特性,每个关键特性的作用及含义。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » 带你读Mysql技术内幕[2]——InnoDB引擎概述

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码