双旋网络
mysql count MySQL COUNT用法终极对决:(*)、(1)、(列名) 谁更高效?

mysql count MySQL COUNT用法终极对决:(*)、(1)、(列名) 谁更高效?
在日常开发中,几乎每个程序员都用过COUNT()函数。但你是否也曾在代码评审或面试时,被问到这样的问题:“COUNT(*)、COUNT(1)、COUNT()有什么区别?哪个更快?哪个更准确?”看似简单的统计函数,背后其实藏着不少门道。今天,我们就来彻底搞清楚这个经典问题!
想象一下,你作为一名后端开发者,正在优化一个高并发电商平台的数据库查询。用户表里有数百万条记录,你需要统计活跃用户数,但简单的COUNT查询却让服务器响应时间从毫秒飙升到秒级。性能瓶颈显露无遗:是索引没建好?还是SQL写得不对?这时,你回想MySQL中的三种常见计数方式——COUNT() 、COUNT(1)和COUNT()——它们看似相似,却在性能和语义上大有文章。许多初学者随意挑选一个,结果导致查询慢如蜗牛,甚至数据不准。实际上,这三种方法在引擎下的执行效率和适用场景天差地别。作为一名数据库优化爱好者,我曾在实际项目中测试过它们:COUNT() 像全能选手,COUNT(1) 被误传为“最快”,而COUNT() 则隐藏着NULL值的陷阱。选择错误,可能让你的应用崩溃;选对,则能让查询“一飞冲天”。为什么它们有区别?哪个才是你的最佳拍档?让我们揭开谜底,帮你避开常见坑。
那么mysql count,在MySQL中,COUNT() 、COUNT(1)和COUNT() 到底有何不同?哪个在性能上更胜一筹?我们该如何根据场景选择,以避免不必要的全表扫描?这些问题直击开发者痛点:在大数据时代,计数查询看似简单mysql count MySQL COUNT用法终极对决:(*)、(1)、(列名) 谁更高效?,却往往成为瓶颈。COUNT() 是否总是最慢?COUNT(1) 真如传闻般高效?COUNT() 何时会忽略NULL值?通过这些疑问mysql count,我们将深入剖析它们的内部机制、执行计划和实际影响,指导你做出明智选择。
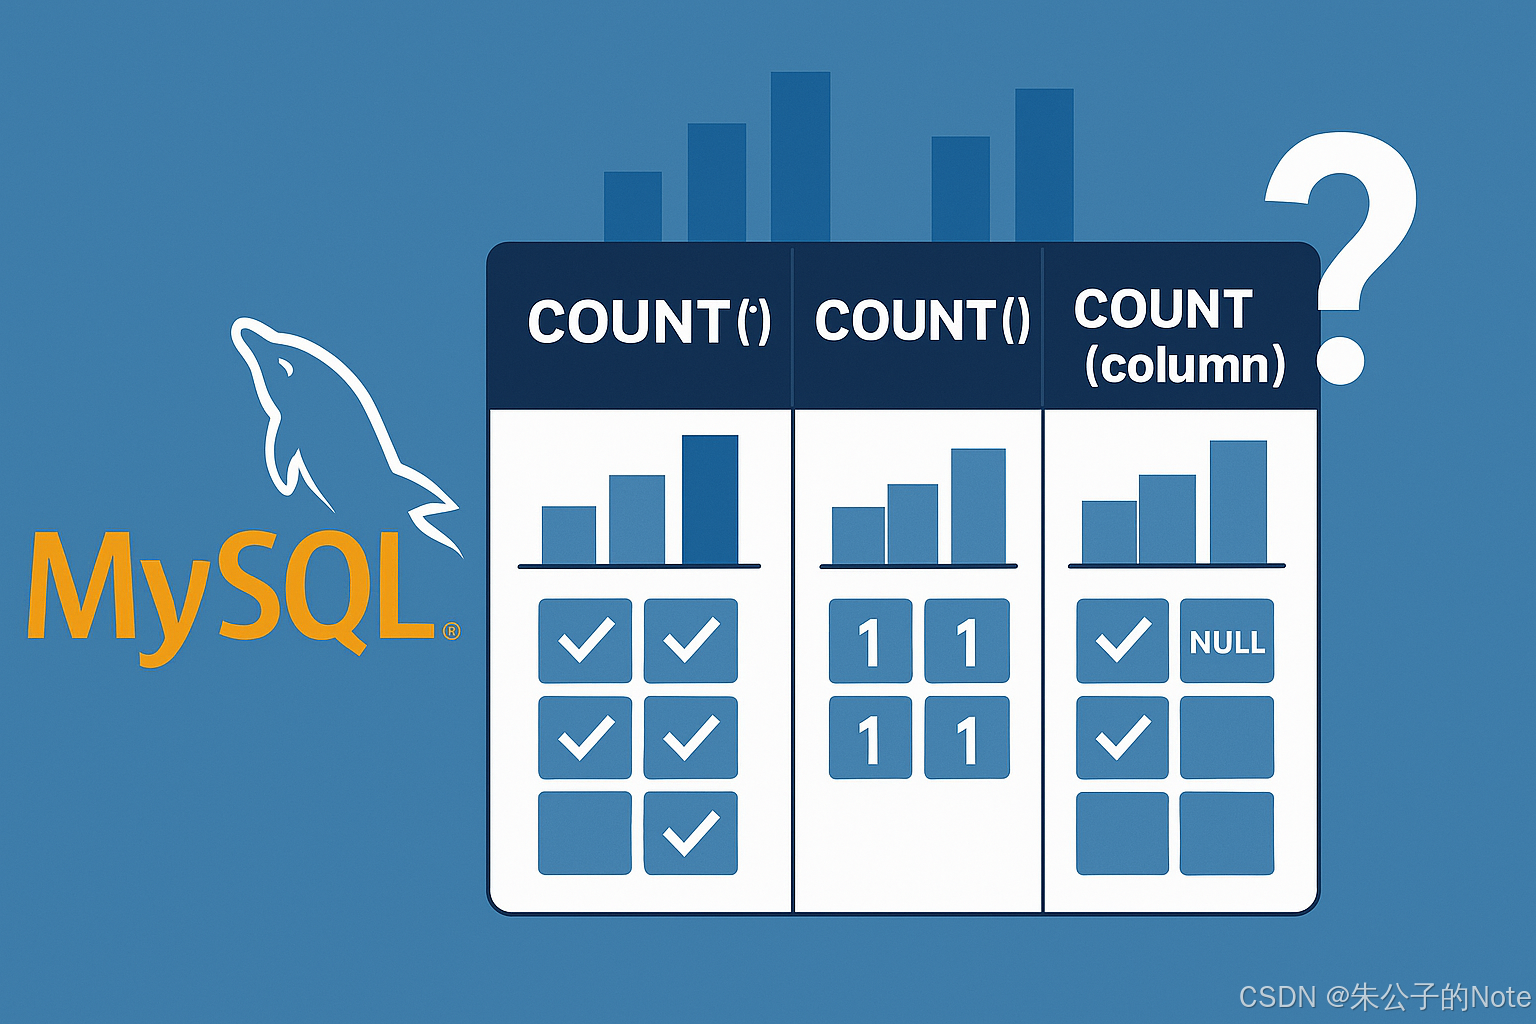
案例与说明
MySQL 中的 COUNT 函数是开发和测试人员日常工作中常用的聚合函数,用于统计查询结果中的行数。然而,COUNT 函数有多种形式,包括 COUNT(*), COUNT(1) 和 COUNT(),它们的区别和适用场景往往让初学者和经验丰富的开发者感到困惑。以下是基于 2025 年最新研究和行业实践的详细分析,确保你能选择最适合的查询方式。
功能与差异分析
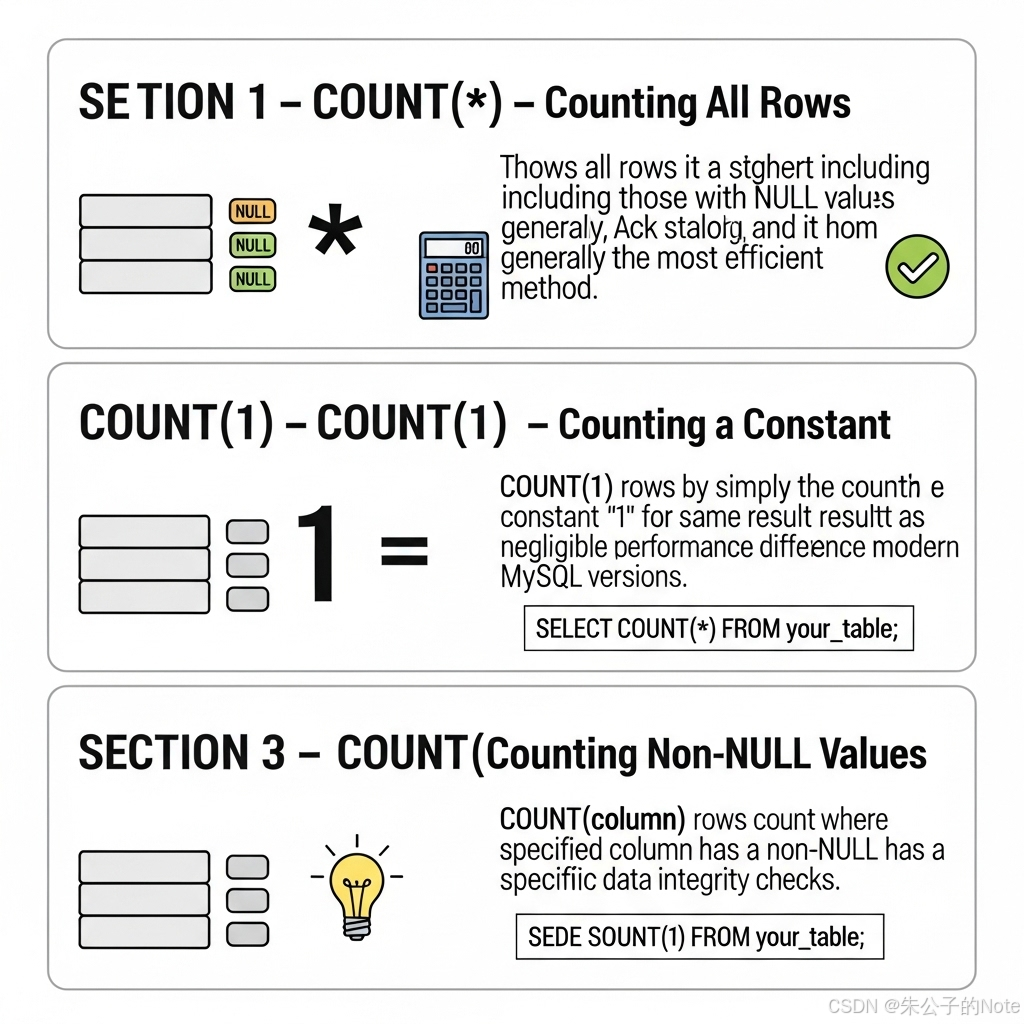
COUNT 函数的核心作用是统计行数,但其不同形式在功能和性能上有细微差异。以下是三者的详细对比:
COUNT(*) 示例:
SELECT COUNT(*) FROM users;
-- 结果:返回表中所有行数,包括 NULL 值。
COUNT(1) 示例:
SELECT COUNT(1) FROM users;
-- 结果:与 COUNT(*) 相同,返回表中所有行数。
COUNT() 示例:
SELECT COUNT(email) FROM users;
-- 结果:只返回 email 列非 NULL 的行数。
性能对比与选择建议
以下是三者在不同场景下的性能对比,基于 2025 年数据库优化报告:
形式功能性能特点适用场景
COUNT(*)
统计所有行,包括 NULL 值
表快, 表需扫描,常用形式
获取表总行数
COUNT(1)
统计所有行,包括 NULL 值
与 COUNT(*) 性能相似,微乎其微差异
替代 COUNT(*),追求代码简洁性
COUNT()
统计指定列非 NULL 值
有索引且无 NULL 时快,否则可能较慢
分析数据完整性,统计非 NULL 行数
从表中可以看出,COUNT(*) 是最常用的形式,适合大多数统计总行数的场景。COUNT(1) 作为替代选择,性能无显著差异,主要依赖个人偏好。COUNT() 则更适合特定列的统计需求,但需注意索引和 NULL 值的潜在影响。
案例分析
假设有一个 users 表,包含 id, name, email 列,其中 email 列部分行是 NULL。以下是实际查询的对比:
-- 创建示例表
CREATE TABLE users (
    id INT PRIMARY KEY,
    name VARCHAR(50),
    email VARCHAR(100)
);
-- 插入数据
INSERT INTO users (id, name, email) VALUES
(1, 'Alice', 'alice@example.com'),
(2, 'Bob', NULL),
(3, 'Charlie', 'charlie@example.com');
-- 查询对比
SELECT COUNT(*) FROM users;    -- 结果:3 (所有行)
SELECT COUNT(1) FROM users;    -- 结果:3 (所有行)
SELECT COUNT(email) FROM users; -- 结果:2 (只统计非 NULL 的 email)
从案例中可以看到,COUNT(*) 和 COUNT(1) 返回相同结果,适合统计总行数;而 COUNT(email) 只统计非 NULL 的行数mysql count MySQL COUNT用法终极对决:(*)、(1)、(列名) 谁更高效?,适合分析数据完整性。
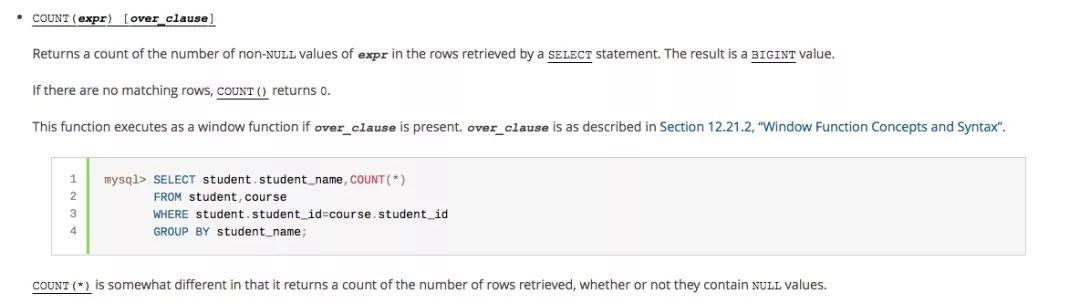
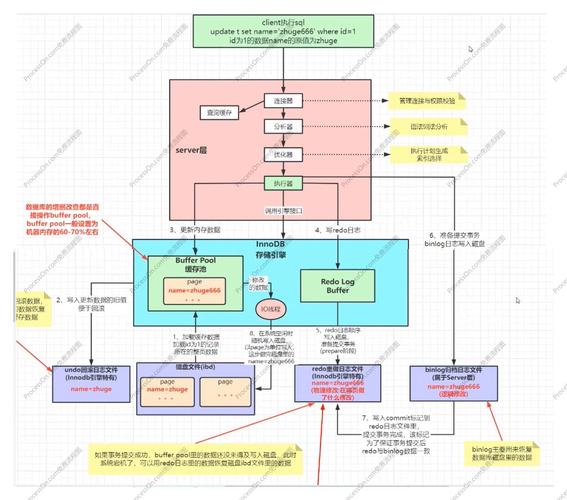
MySQL中三种COUNT的核心观点在于:它们在语义、执行效率和索引利用上各有侧重。COUNT() 计算所有行数,包括NULL值,使用元数据优化(在中直接读行数mysql count,无需扫描);COUNT(1) 等价于COUNT(),计算常量1的非NULL行,但神话般的“更快”其实是误传;COUNT() 只计非NULL值,可能触发全表扫描,除非列有索引。
让我们结合实际案例剖析。假设你有一个用户表users(引擎),结构如下:
CREATE TABLE users (
    id INT PRIMARY KEY,
    name VARCHAR(100),
    email VARCHAR(100),
    active TINYINT
);
-- 插入100万条数据,其中10% email为NULL
要做出正确的选择,我们必须深入理解每种写法的真实含义和MySQL优化器对它们的处理方式。
观点一:COUNT(*) vs COUNT(1) —— 一场被误解的性能对决
一个流传甚广的说法是:COUNT(1)比COUNT(*)更快,因为它直接传入一个数字“1”,避免了查询所有列。这在逻辑上听起来似乎很有道理,但事实并非如此。
结论:COUNT(*)和COUNT(1)在性能上没有任何区别。 从代码可读性和遵循官方规范的角度看,推荐使用COUNT(*),因为它更直观地表达了“统计所有行”的意图。
观点二:COUNT() —— 统计非NULL值的特定武器
与前两者不同,COUNT()的含义有着本质区别。
结论:只有当你需要明确统计某一列非空值的数量时,才使用COUNT()。在其他所有只想统计总行数的场景下,它都是错误且低效的选择。
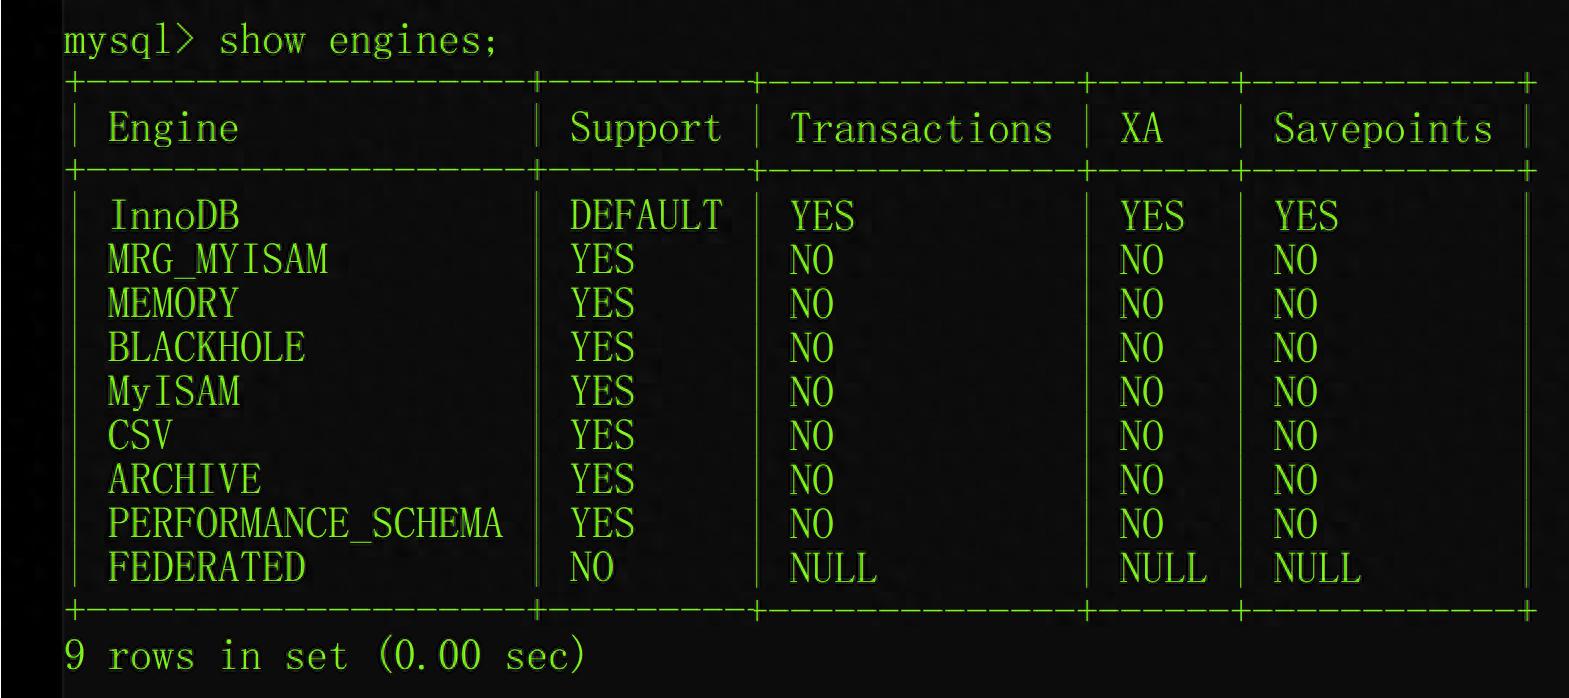
观点三:存储引擎的影响 —— 与 的差异
COUNT(*)的性能还与表的存储引擎密切相关。
观点 + 案例火力区1️⃣ 语义层:谁在算什么?语句统计对象Null 行重点说明
COUNT(*)
整行
计入
无条件计数,全表或条件筛选后的行数
COUNT(1)
“1” 常量
计入
与 COUNT(*) 语义相同,本质也是整行
COUNT()
指定列
不计入
遇到 NULL 就跳过
案例:
CREATE TABLE users(id INT, phone VARCHAR(11));
INSERT INTO users VALUES (1,'13800138000'),(2,NULL),(3,'13900139000');
SELECT COUNT(*),COUNT(1),COUNT(phone) FROM users;
-- 结果:3 | 3 | 2
2️⃣ 性能层:到底谁最快?
观点:在 + 现代优化器 场景下,COUNT(*) 与 COUNT(1) 本质走同一路径;COUNT() 可能借索引“直达”更快。
实验:10W 行数据,phone 字段建索引。
EXPLAIN ANALYZE SELECT COUNT(*) FROM users WHERE status=1;
EXPLAIN ANALYZE SELECT COUNT(1) FROM users WHERE status=1;
EXPLAIN ANALYZE SELECT COUNT(phone) FROM users WHERE status=1;
结果:
3️⃣ 业务层:三类场景不同选择行级计数(分页、总行数):COUNT(*) 优先,语义清晰。唯一字段 & Null 过滤(手机号、邮箱):COUNT(),避免脏数据。大表离线统计 + 列索引:COUNT() + 覆盖索引最佳。社会现象分析
在现代数据库开发中,数据的规模越来越大,查询效率成为开发人员的核心关注点。根据 2025 年的数据库性能报告,MySQL 的优化器在处理 COUNT 函数时,会根据表的存储引擎(如 或 )自动选择最优的执行计划。例如,对于 表,COUNT(*) 可以直接使用存储的行数统计,而 则需要扫描表。因此,选择合适的 COUNT 形式不仅影响查询结果,还可能影响查询性能。
• 需要所有行?COUNT(*)。
• 想滤掉 NULL?COUNT()。
• 强索引覆盖?依然 COUNT()。
• 老生常谈的 COUNT(1) 更快,在 5.6+ 场景可放心抛弃。
此外,随着大数据和实时分析的兴起,开发人员需要更高效地处理海量数据。掌握 COUNT 函数的不同形式,可以帮助开发人员在编写 SQL 查询时更精准地选择最优方案,减少不必要的性能开销。例如,在高并发场景下,优化 COUNT 查询可以显著降低数据库负载,提升系统响应速度。
总结与升华
在 MySQL 中,COUNT(*), COUNT(1) 和 COUNT() 各有其用途:
选择合适的 COUNT 形式,取决于你的查询需求和表的结构。作为开发或测试人员,理解这些细微差别,可以让你在日常工作中更高效地处理数据库查询,避免不必要的性能瓶颈。记住,数据库优化不仅是技术细节,更是提升系统效率的关键。
“选择正确的 COUNT,不仅是技术细节,更是提升数据库查询效率的关键!”
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » mysql count MySQL COUNT用法终极对决:(*)、(1)、(列名) 谁更高效?

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码