双旋网络
java wrapper Java后端必看!公共SQL复用3种实战方案,告别重复编码

java wrapper Java后端必看!公共SQL复用3种实战方案,告别重复编码
作为 Java 后端开发人员,你是否经常遇到这样的场景?同一个查询用户信息的 SQL 语句,在用户列表、个人中心、数据统计等 5 个以上模块重复出现;当产品要求增加 “用户状态筛选” 条件时,需要逐个查找所有涉及该 SQL 的 文件,修改 10 余次才能完成上线;更棘手的是,不同开发人员编写的相似 SQL 存在语法差异,导致联调时出现数据不一致的诡异问题。
这些看似不起眼的 “重复 SQL”,正在悄悄消耗团队的开发效率 —— 调研显示,Java 后端项目中约 65% 的 SQL 存在重复编写情况java wrapper,平均每个重复 SQL 会增加 30% 的维护成本,而因重复 SQL 导致的线上 bug 占比高达 18%。对于追求高效开发、注重代码可维护性的互联网软件开发人员来说,解决公共 SQL 复用问题,早已不是 “可选技能”,而是必备的核心能力。
为什么公共 SQL 复用成为后端开发刚需?
随着微服务架构的普及和业务场景的复杂化,Java 后端项目的 SQL 量呈指数级增长。一方面java wrapper,同一业务域(如用户、订单、商品)的核心查询逻辑高度相似,重复编写不仅浪费开发时间,更会导致 “一处修改,多处联动” 的维护噩梦;另一方面,多人协作开发时,缺乏统一的 SQL 复用规范,容易出现 SQL 冗余、性能差异、数据不一致等问题,严重影响项目稳定性。
从技术演进角度来看,、-Plus 等持久层框架的广泛应用,为 SQL 复用提供了成熟的技术支撑。而在面试场景中,“如何实现公共 SQL 复用” 已成为 Java 后端岗位的高频问题,能清晰阐述复用方案的开发者java wrapper Java后端必看!公共SQL复用3种实战方案,告别重复编码,往往更受面试官青睐 —— 这背后体现的,正是企业对代码质量、开发效率和可维护性的核心诉求。
3 种公共 SQL 复用实战方案(附代码案例)
基于主流开发框架和企业实战经验,以下 3 种 SQL 复用方案覆盖从简单场景到复杂业务,适配不同项目架构,建议根据实际需求选择组合使用。
方案 1: 标签复用(入门级,适合简单 SQL)
核心原理:利用 的标签定义公共 SQL 片段,通过标签在其他 SQL 中引用,实现基础的 SQL 片段复用。
实战代码:
    id, username, phone, email, status, create_time, update_time


    SELECT

    FROM sys_user

        status = #{status}
        AND username LIKE CONCAT('%', #{username}, '%')


    SELECT

    FROM sys_user
    WHERE id = #{id}
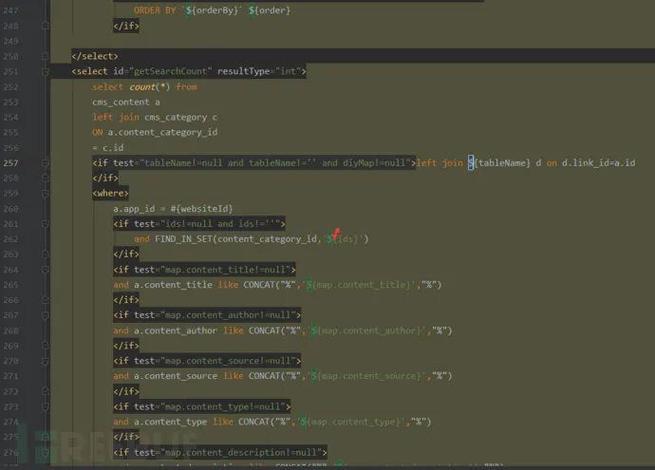
优势:零额外依赖,直接基于 原生功能实现,学习成本低,适合单表查询的简单 SQL 复用; 注意事项:不支持动态参数传递,复杂关联查询场景适配性差。
方案 2:工具类封装(进阶级,适合复杂查询)
核心原理:针对多表关联、动态条件复杂的公共 SQL,通过 Java 工具类封装查询逻辑java wrapper,利用 -Plus 的 或 构建动态 SQL,统一提供查询方法供各模块调用。
实战代码:
// 公共SQL工具类:用户相关查询封装
@Component
public class UserQueryUtil {
    @Autowired
    private UserMapper userMapper;
    /**
     * 公共查询方法:根据条件查询用户列表
     * @param status 用户状态
     * @param keyword 搜索关键词(用户名/手机号)
     * @return 用户列表
     */
    public List queryUserList(Integer status, String keyword) {
        LambdaQueryWrapper queryWrapper = Wrappers.lambdaQuery();
        // 公共查询条件
        queryWrapper.eq(status != null, User::getStatus, status)
                    .like(StringUtils.isNotBlank(keyword), User::getUsername, keyword)
                    .or(StringUtils.isNotBlank(keyword),
                        wrapper -> wrapper.like(User::getPhone, keyword))
                    .orderByDesc(User::getCreateTime);
        return userMapper.selectList(queryWrapper);
    }
    /**
     * 公共统计方法:用户数量统计
     * @param status 用户状态
     * @return 统计结果
     */
    public Long countUser(Integer status) {
        LambdaQueryWrapper queryWrapper = Wrappers.lambdaQuery();
        queryWrapper.eq(status != null, User::getStatus, status);
        return userMapper.selectCount(queryWrapper);
    }
}
// 业务模块调用示例
@Service
public class UserService {
    @Autowired
    private UserQueryUtil userQueryUtil;
    public List getUserList(Integer status, String keyword) {
        // 直接调用公共工具类,无需重复编写SQL
        return userQueryUtil.queryUserList(status, keyword);
    }
}
优势:支持动态参数传递,适配复杂查询场景,代码复用性强,便于统一维护和性能优化; 注意事项:需依赖 -Plus 框架,工具类需做好职责划分,避免过度耦合。
方案 3:XML 文件分离复用(企业级,适合大型项目)
核心原理:将公共 SQL 片段抽取到独立的 XML 文件中(如 -sql.xml),通过 的标签跨 文件引用,配合命名空间规范,实现全局 SQL 复用。
实战步骤:
创建公共 SQL 文件-sql.xml:
        id, order_no, user_id, amount, pay_status, create_time, pay_time


        AND create_time >= #{startTime}
        AND create_time <= #{endTime}
在业务 文件中引用公共 SQL:
        SELECT

        FROM sys_order


            AND pay_status = #{payStatus}
配置 扫描公共 XML 文件(.yml):
优势:全局统一管理公共 SQL,支持跨模块、跨 引用,适合大型分布式项目,维护成本极低; 注意事项:需规范命名空间和 SQL 片段 IDjava wrapper Java后端必看!公共SQL复用3种实战方案,告别重复编码,避免冲突;修改公共 SQL 时需谨慎,做好影响范围评估。
总结
以上 3 种方案各有侧重:简单场景用 标签,复杂查询用工具类封装,大型项目用 XML 分离复用。核心目标都是通过 “一次编写、多次引用”,减少重复编码、降低维护成本、提升项目稳定性。
作为互联网软件开发人员,代码的 “复用性” 和 “可维护性” 往往决定了你的开发效率和职业上限。建议你:
梳理当前项目中的重复 SQL,优先用对应方案进行重构;制定团队 SQL 复用规范,明确不同场景的适配方案;结合实际业务,灵活组合 3 种方案,而非拘泥于单一实现。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » java wrapper Java后端必看!公共SQL复用3种实战方案,告别重复编码

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码