双旋网络
kafka java Kafka——入门与基础

数据发送前,会执行此方法,进行数据发送前的预处理
数据发送后,获取应答时,会执行此方法
close
生产者关闭时,会执行此方法,完成一些资源回收和释放的操作
创建生产者对象的时候,会执行此方法,可以根据场景对生产者对象的配置进行统一修改或转换
2.4.3.1.2.配置拦截器
package com.atguigu.kafka.producer;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.common.serialization.StringSerializer;
import java.util.HashMap;
import java.util.Map;
public class KafkaProducerInterceptorTest {
    public static void main(String[] args) {
        //配置属性集合
        Map<String, Object> configMap = new HashMap<>();
        //配置属性:Kafka 服务器集群地址
        configMap.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        //配置属性:Kafka 生产的数据为 KV 对,所以在生产数据进行传输前需要分别对 K,V 进行对应的序列化操作
        configMap.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        configMap.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        //配置自定义拦截器
        configMap.put(ProducerConfig.INTERCEPTOR_CLASSES_CONFIG, ValueInterceptorTest.class.getName());
        //创建 Kafka 生产者对象,建立 Kafka 连接,构造对象时,需要传递配置参数
        KafkaProducer<String, String> producer = new KafkaProducer<>(configMap);
        //准备数据,定义泛型,构造对象时需要传递 【Topic 主题名称】,【Key】,【Value】三个参数
        for (int i = 0; i < 10; i++) {
            ProducerRecord<String, String> record = new ProducerRecord<>(
                    "test", "key" + i, "value" + i
            );
            //生产(发送)数据
            producer.send(record);
        }
        //关闭生产者连接
        producer.close();
    }
}
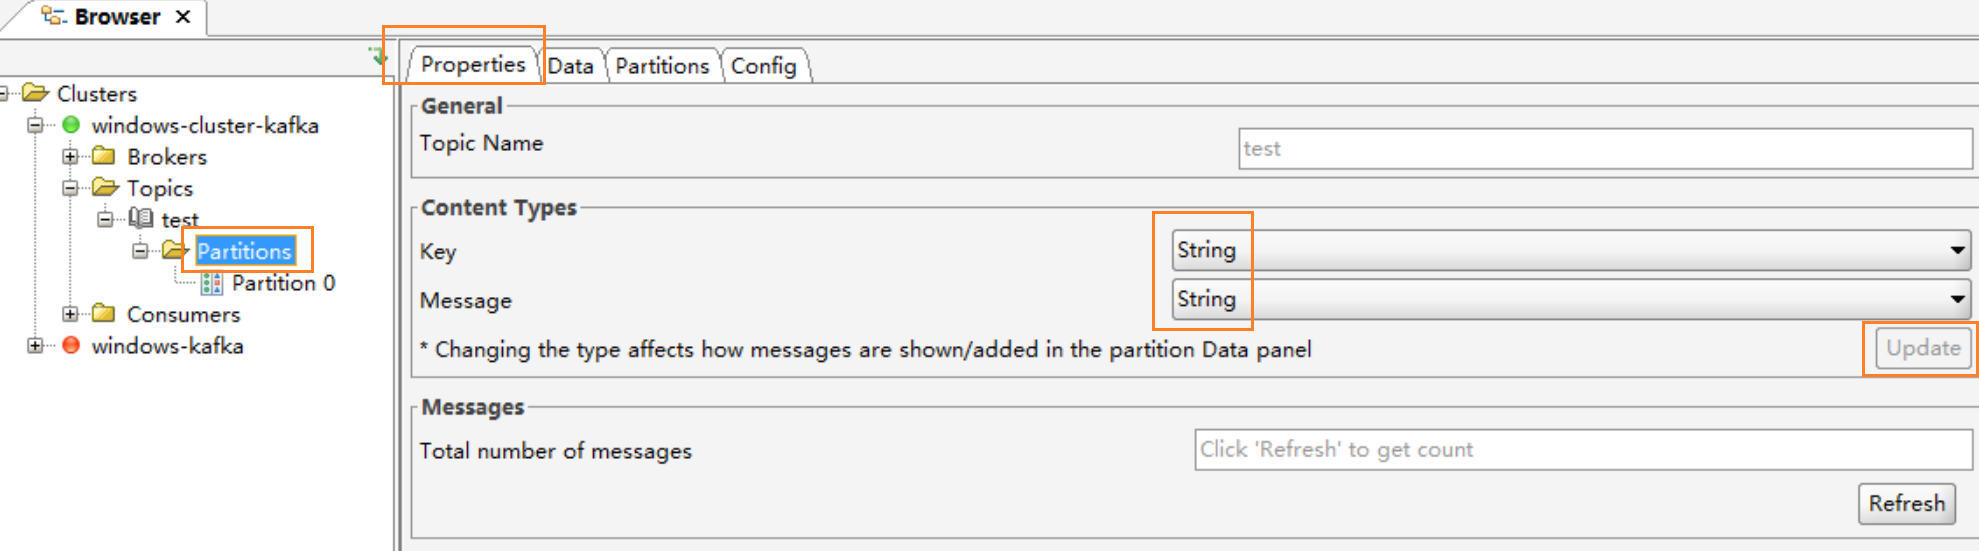
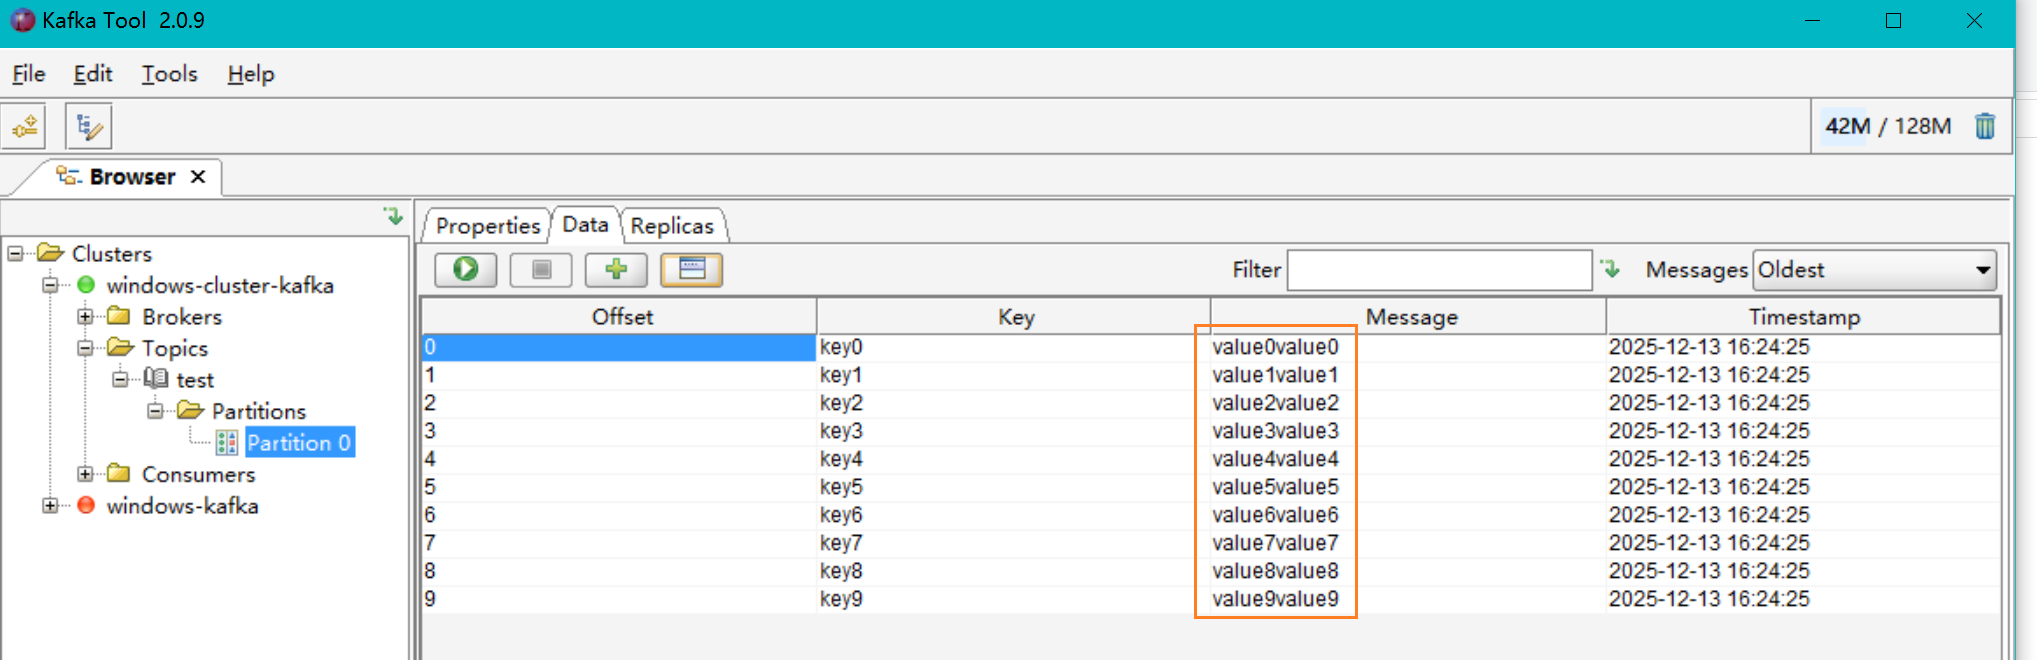
执行上述代码,然后在 Kafka Tool 中查看主题 test 中的数据:
2.4.3.2.回调方法
Kafka 发送数据时,可以同时传递回调对象 () 用于对数据的发送结果进行对应处理,具体代码实现采用匿名类或 表达式都可以。
package com.atguigu.kafka.producer;
import org.apache.kafka.clients.producer.*;
import org.apache.kafka.common.serialization.StringSerializer;
import java.util.HashMap;
import java.util.Map;
public class KafkaProducerCallbackTest {
    public static void main(String[] args) {
        //配置属性集合
        Map<String, Object> configMap = new HashMap<>();
        //配置属性:Kafka 服务器集群地址
        configMap.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        //配置属性:Kafka 生产的数据为 KV 对,所以在生产数据进行传输前需要分别对 K,V 进行对应的序列化操作
        configMap.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        configMap.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        //创建 Kafka 生产者对象,建立 Kafka 连接,构造对象时,需要传递配置参数
        KafkaProducer<String, String> producer = new KafkaProducer<>(configMap);
        //准备数据,定义泛型,构造对象时需要传递 【Topic 主题名称】,【Key】,【Value】三个参数
        for (int i = 0; i < 10; i++) {
            ProducerRecord<String, String> record = new ProducerRecord<>(
                    "test", "key" + i, "value" + i
            );
            //生产(发送)数据
            producer.send(record, new Callback() {
                @Override
                public void onCompletion(RecordMetadata metadata, Exception exception) {
                    //数据发送成功后,会回调此方法
                    if (exception != null) {
                        System.err.println("数据发送失败: {}" + exception.getMessage());
                    } else {
                        System.out.println("数据发送成功: " + metadata);
                    }
                }
            });
        }
        //关闭生产者连接
        producer.close();
    }
}
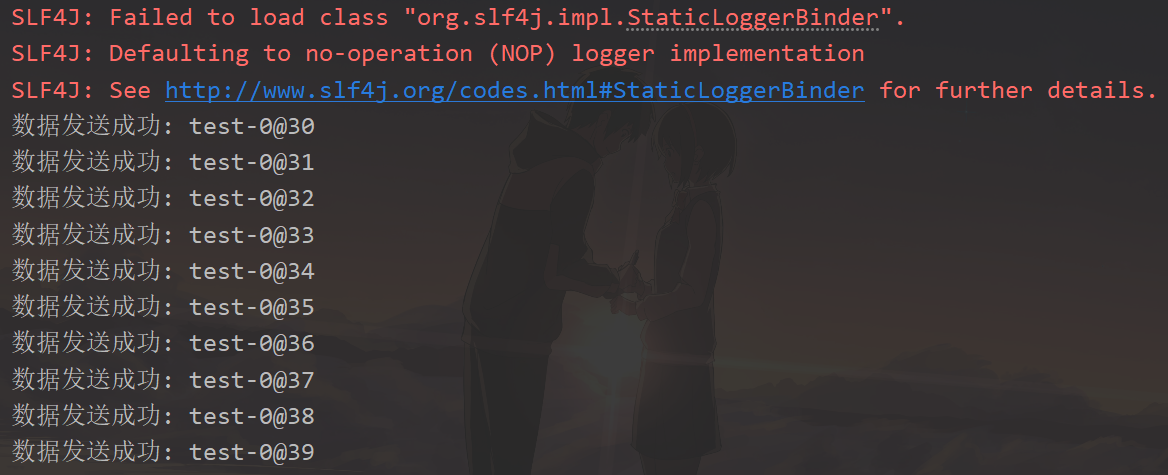
执行上述代码,打印结果如下:
2.4.3.3.异步发送
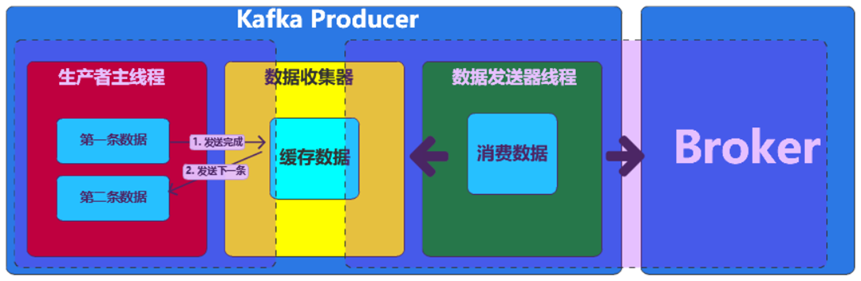
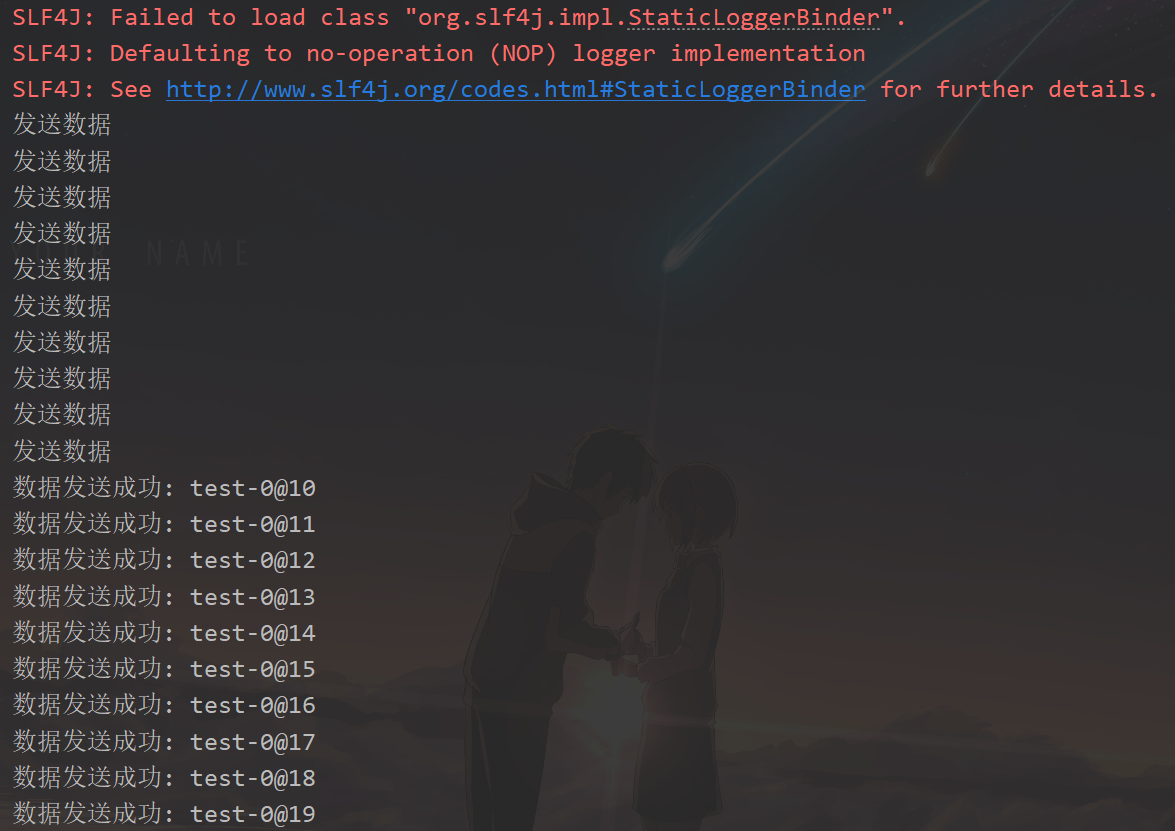
Kafka 发送数据时,底层的实现类似于生产者消费者模式。对应的,底层会由主线程代码作为生产者向缓冲区中放数据,而数据发送线程会从缓冲区中获取数据进行发送。 接收到数据后进行后续处理。如果 Kafka 通过主线程代码将一条数据放入到缓冲区后,无需等待数据的后续发送过程,就直接发送一下条数据的场合,我们就称之为异步发送。
package com.atguigu.kafka.producer;
import org.apache.kafka.clients.producer.*;
import org.apache.kafka.common.serialization.StringSerializer;
import java.util.HashMap;
import java.util.Map;
public class KafkaProducerCallbackTest {
    public static void main(String[] args) {
        //配置属性集合
        Map<String, Object> configMap = new HashMap<>();
        //配置属性:Kafka 服务器集群地址
        configMap.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        //配置属性:Kafka 生产的数据为 KV 对,所以在生产数据进行传输前需要分别对 K,V 进行对应的序列化操作
        configMap.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        configMap.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        //创建 Kafka 生产者对象,建立 Kafka 连接,构造对象时,需要传递配置参数
        KafkaProducer<String, String> producer = new KafkaProducer<>(configMap);
        //准备数据,定义泛型,构造对象时需要传递 【Topic 主题名称】,【Key】,【Value】三个参数
        for (int i = 0; i < 10; i++) {
            ProducerRecord<String, String> record = new ProducerRecord<>(
                    "test", "key" + i, "value" + i
            );
            //生产(发送)数据
            producer.send(record, new Callback() {
                @Override
                public void onCompletion(RecordMetadata metadata, Exception exception) {
                    //数据发送成功后,会回调此方法
                    if (exception != null) {
                        System.err.println("数据发送失败: {}" + exception.getMessage());
                    } else {
                        System.out.println("数据发送成功: " + metadata);
                    }
                }
            });
            System.out.println("发送数据");
        }
        //关闭生产者连接
        producer.close();
    }
}
执行上述代码,打印结果如下:
2.4.3.4.同步发送
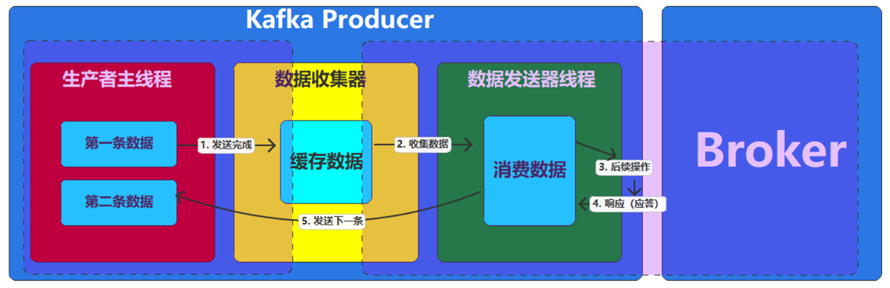
(1)Kafka发送数据时,底层的实现类似于生产者消费者模式。对应的,底层会由主线程代码作为生产者向缓冲区中放数据,而数据发送线程会从缓冲区中获取数据进行发送。接收到数据后进行后续处理。
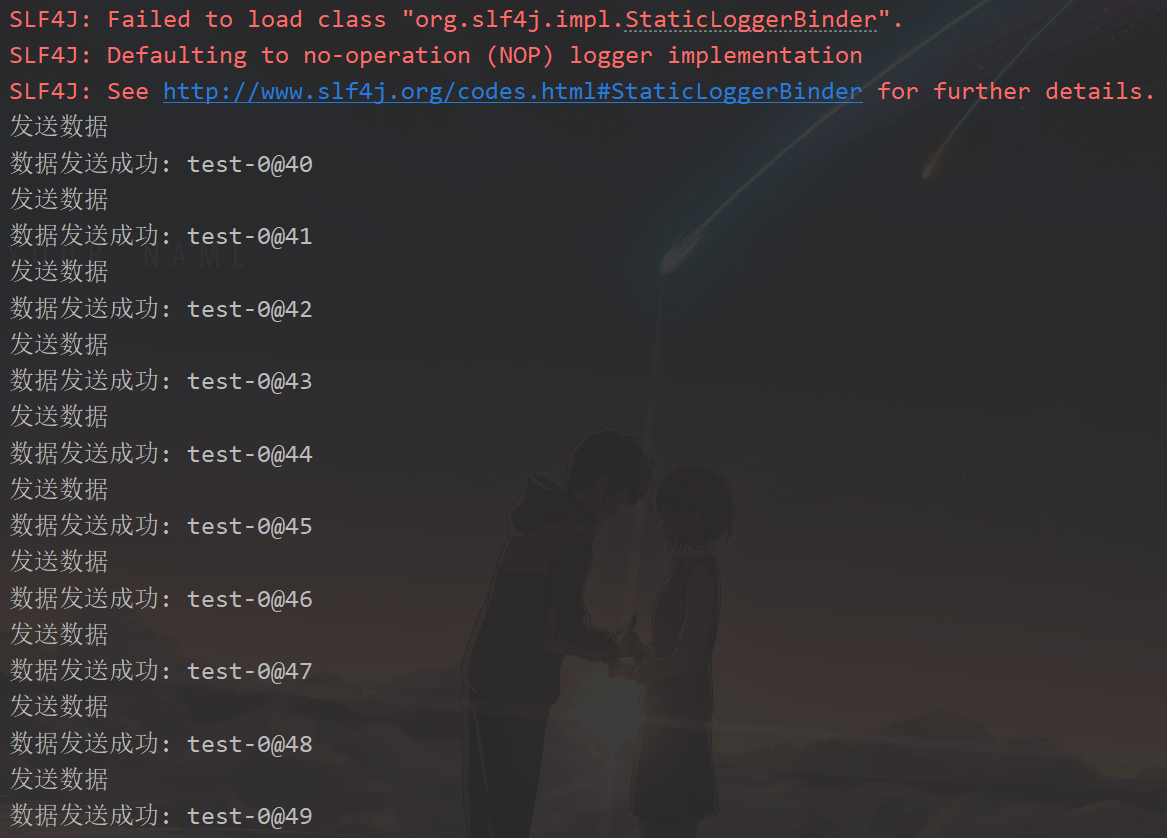
(2)如果 Kafka 通过主线程代码将一条数据放入到缓冲区后,需等待数据的后续发送操作的应答状态,才能发送一下条数据的场合,我们就称之为同步发送。所以这里的所谓同步,就是生产数据的线程需要等待发送线程的应答(响应)结果。
(3)代码实现上kafka java,采用的是 JDK1.5 增加的 JUC 并发编程的 接口的 get 方法实现。
package com.atguigu.kafka.producer;
import org.apache.kafka.clients.producer.*;
import org.apache.kafka.common.serialization.StringSerializer;
import java.util.HashMap;
import java.util.Map;
import java.util.concurrent.ExecutionException;
import java.util.concurrent.Future;
/**
 * @ClassName KafkaProducerTest
 * @Description KafkaProducerTest
 * @Date 2025/11/23 15:23
 * @Version 1.0
 */
public class KafkaProducerCallbackTest {
    public static void main(String[] args) throws ExecutionException, InterruptedException {
        //配置属性集合
        Map<String, Object> configMap = new HashMap<>();
        //配置属性:Kafka 服务器集群地址
        configMap.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        //配置属性:Kafka 生产的数据为 KV 对,所以在生产数据进行传输前需要分别对 K,V 进行对应的序列化操作
        configMap.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        configMap.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        //创建 Kafka 生产者对象,建立 Kafka 连接,构造对象时,需要传递配置参数
        KafkaProducer<String, String> producer = new KafkaProducer<>(configMap);
        //准备数据,定义泛型,构造对象时需要传递 【Topic 主题名称】,【Key】,【Value】三个参数
        for (int i = 0; i < 10; i++) {
            ProducerRecord<String, String> record = new ProducerRecord<>(
                    "test", "key" + i, "value" + i
            );
            //生产(发送)数据
            Future<RecordMetadata> send = producer.send(record, new Callback() {
                @Override
                public void onCompletion(RecordMetadata metadata, Exception exception) {
                    //数据发送成功后,会回调此方法
                    if (exception != null) {
                        System.err.println("数据发送失败: {}" + exception.getMessage());
                    } else {
                        System.out.println("数据发送成功: " + metadata);
                    }
                }
            });
            System.out.println("发送数据");
            send.get();
        }
        //关闭生产者连接
        producer.close();
    }
}
执行上述代码,打印结果如下:
有关 模式的具体知识,可以查看 Java 并发编程面试题—— 模式这篇文章。
2.4.4.消息分区 2.4.4.1.指定分区
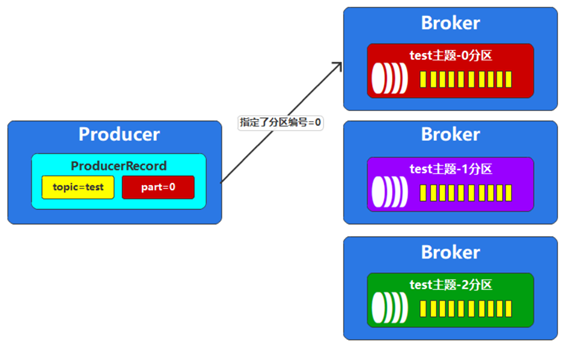
Kafka 中主题是对数据逻辑上的分类,而分区才是数据真正存储的物理位置。所以在生产数据时,如果只是指定主题的名称,其实 Kafka 是不知道将数据发送到哪一个 节点的。我们可以在构建数据传递主题参数的同时,也可以指定数据存储的分区编号。
for (int i = 0; i < 1; i++) {
	// ProducerRecord 中的入参:主题名称、分区编号、key、value
	ProducerRecord<String, String> record = new ProducerRecord<String, String>("test", 0, "key" + i, "value" + i);
	producer.send(record);
}
2.4.4.2.未指定分区
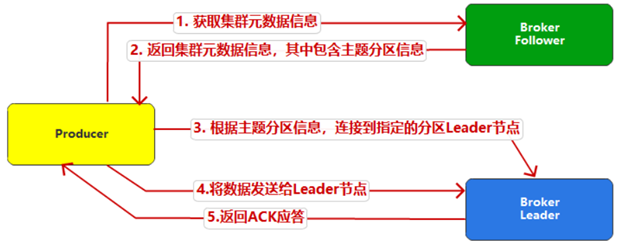
(1)指定分区传递数据是没有任何问题的。Kafka 会进行基本简单的校验,比如是否为空,是否小于 0 之类的,但是你的分区是否存在就无法判断了,所以需要从 Kafka 中获取集群元数据信息,此时会因为长时间获取不到元数据信息而出现超时异常。所以如果不能确定分区编号范围的情况,不指定分区还是一个不错的选择。
(2)如果不指定分区,Kafka会根据集群元数据中的主题分区来通过算法来计算分区编号并设定:
2.4.4.3.分区器
(1)在某些场合中,指定的数据我们是需要根据自身的业务逻辑发往指定的分区的。所以需要自己定义分区编号规则,而不是采用 Kafka 自动设置就显得尤其必要了。Kafka 早期版本中提供了两个分区器,不过在当前 Kafka 版本中已经不推荐使用了。
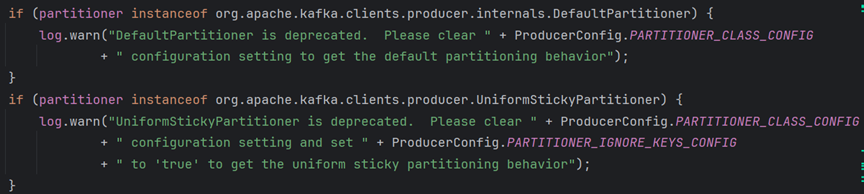
(2)接下来我们就说一下当前版本 Kafka 中如何定义我们自己的分区规则:分区器
2.4.4.3.1.增加分区器类
首先我们需要创建一个类,然后实现 Kafka 提供的分区类接口 ,接下来重写方法。这里我们只关注 方法即可,因为此方法的返回结果就是需要的分区编号。
package com.atguigu.kafka.producer;
import org.apache.kafka.clients.producer.Partitioner;
import org.apache.kafka.common.Cluster;
import java.util.Map;
public class MyKafkaPartitioner implements Partitioner {
    @Override
    public int partition(String topic, Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster) {
	    //自定义分区编号逻辑
        return 0;
    }
    @Override
    public void close() {
    }
    @Override
    public void configure(Map<String, ?> configs) {
    }
}
2.4.4.3.2.配置分区器
public class KafkaProducerPartitionerTest {
    public static void main(String[] args) {
        //配置属性集合
        Map<String, Object> configMap = new HashMap<>();
        //配置属性:Kafka 服务器集群地址
        configMap.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        //配置属性:Kafka 生产的数据为 KV 对,所以在生产数据进行传输前需要分别对 K,V 进行对应的序列化操作
        configMap.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        configMap.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        //配置自定义分区器
        configMap.put(ProducerConfig.PARTITIONER_CLASS_CONFIG, MyKafkaPartitioner.class.getName());
        //创建 Kafka 生产者对象,建立 Kafka 连接,构造对象时,需要传递配置参数
        KafkaProducer<String, String> producer = new KafkaProducer<>(configMap);
        //准备数据,定义泛型,构造对象时需要传递 【Topic 主题名称】,【Key】,【Value】三个参数
        for (int i = 0; i < 10; i++) {
            ProducerRecord<String, String> record = new ProducerRecord<>(
                    "test", "key" + i, "value" + i
            );
            //生产(发送)数据
            producer.send(record);
        }
        //关闭生产者连接
        producer.close();
    }
}
2.4.5.消息可靠性
(1)对于生产者发送的数据,我们有的时候是不关心数据是否已经发送成功的,我们只要发送就可以了。在这种场景中,消息可能会因为某些故障或问题导致丢失,我们将这种情况称之为消息不可靠。虽然消息数据可能会丢失,但是在某些需要高吞吐,低可靠的系统场景中,这种方式也是可以接受的,甚至是必须的。
(2)但是在更多的场景中,我们是需要确定数据是否已经发送成功了且 Kafka 正确接收到数据的,也就是要保证数据不丢失,这就是所谓的消息可靠性保证。而这个确定的过程一般是通过 Kafka 给我们返回的响应确认结果 () 来决定的,这里的响应确认结果我们也可以简称为 ACK 应答。根据场景,Kafka 提供了 3 种应答处理,可以通过配置对象进行配置:
configMap.put(ProducerConfig.ACKS_CONFIG, "-1");
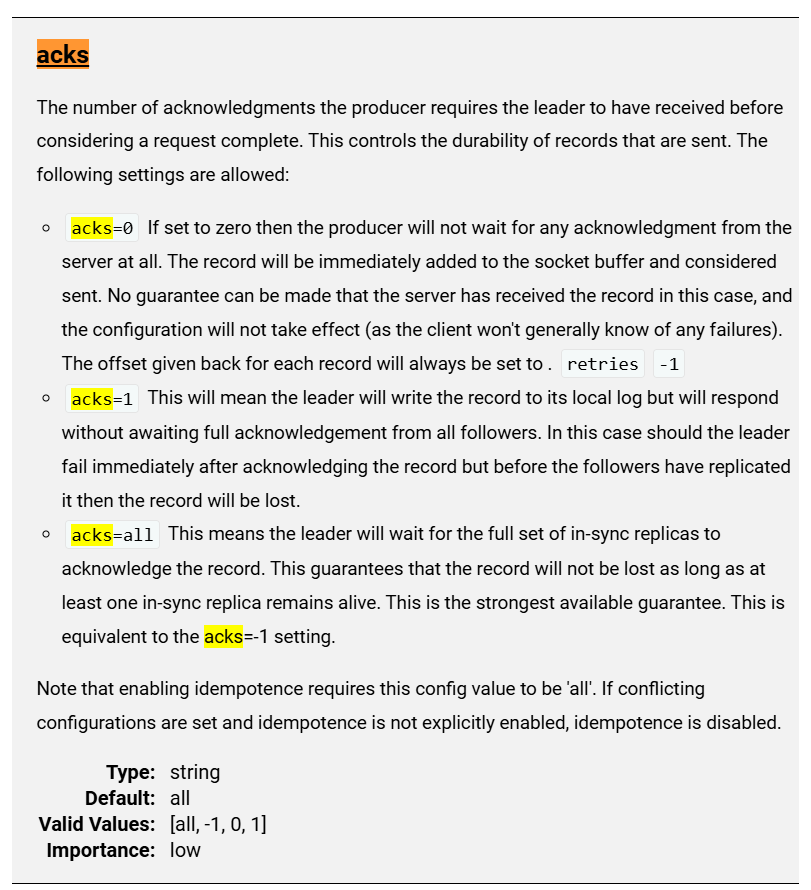
2.4.5.1.ACK = 0
(1)当生产数据时,生产者对象将数据通过网络客户端将数据发送到网络数据流中的时候,Kafka 就对当前的数据请求进行了响应(确认应答),如果是同步发送数据,此时就可以发送下一条数据了。如果是异步发送数据,回调方法就会被触发。
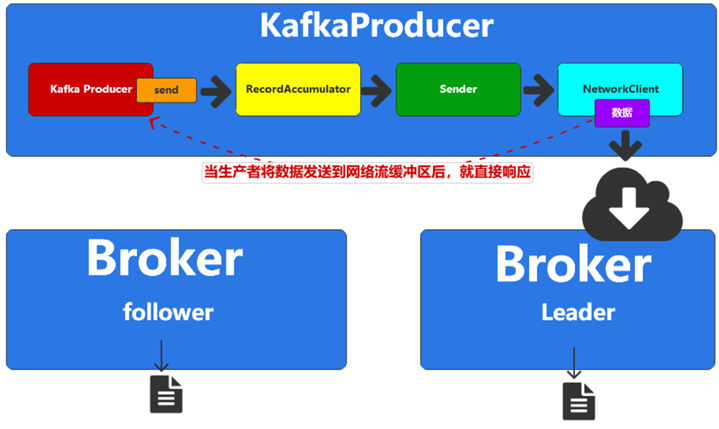
(2)通过图形,明显可以看出,这种应答方式,数据已经走网络给 Kafka 发送了,但这其实并不能保证 Kafka 能正确地接收到数据,在传输过程中如果网络出现了问题,那么数据就丢失了。也就是说这种应答确认的方式,数据的可靠性是无法保证的。不过相反,因为无需等待 Kafka 服务节点的确认,通信效率倒是比较高的,也就是系统吞吐量会非常高。
2.4.5.2.ACK = 1
(1)当生产数据时,Kafka 副本将数据接收到并写入到了日志文件后,就会对当前的数据请求进行响应(确认应答),如果是同步发送数据,此时就可以发送下一条数据了。如果是异步发送数据,回调方法就会被触发。
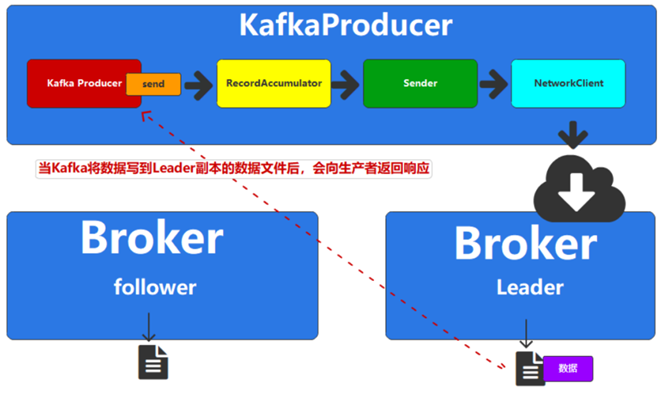
(2)通过图形,可以看出这种应答方式,数据已经存储到了分区 副本中,那么数据相对来讲就比较安全了,也就是可靠性比较高。之所以说相对来讲比较安全kafka java Kafka——入门与基础,就是因为现在只有一个节点存储了数据,而数据并没有来得及进行备份到 副本,那么一旦当前存储数据的 节点出现了故障,数据也依然会丢失。
2.4.5.3.ACK = -1 或者 all(默认)
(1)生产数据时,Kafka 副本和 副本都已经将数据接收到并写入到了日志文件后,再对当前的数据请求进行响应(确认应答),如果是同步发送数据,此时就可以发送下一条数据了。如果是异步发送数据,回调方法就会被触发。
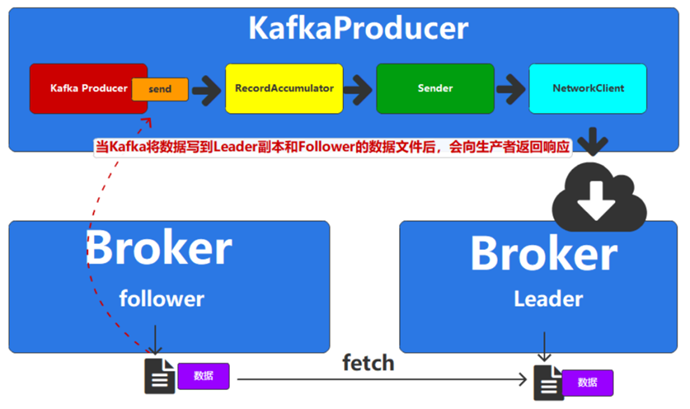
(2)通过图形,可以看出,这种应答方式,数据已经同时存储到了分区 副本和 副本中,那么数据已经非常安全了,可靠性也是最高的。此时,如果 副本出现了故障,那么 副本能够开始起作用,因为数据已经存储了,所以数据不会丢失。
(3)不过这里需要注意,如果假设我们的分区有 5 个 副本,编号为 1、2、3、4、5
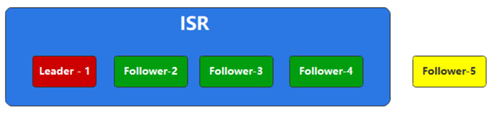
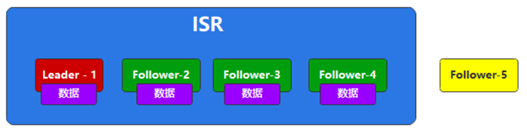
但是此时只有 3 个副本处于和 副本之间处于数据同步状态,那么此时分区就存在一个同步副本列表,我们称之为 In Syn ,简称为 ISR。此时,Kafka 只要保证 ISR 中所有的 4 个副本接收到了数据,就可以对数据请求进行响应了。无需 5 个副本全部收到数据。
2.4.6 消息去重 & 有序 2.4.6.1.数据重试
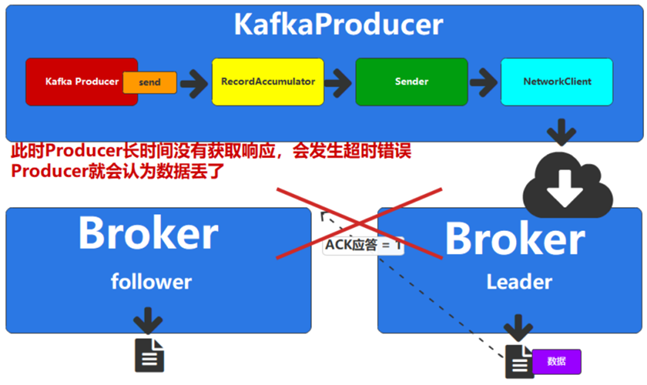
(1)由于网络或服务节点的故障,Kafka 在传输数据时,可能会导致数据丢失,所以我们才会设置 ACK 应答机制,尽可能提高数据的可靠性。但其实在某些场景中,数据的丢失并不是真正地丢失,而是“虚假丢失”,比如将 ACK 应答设置为 1,也就是说一旦 副本将数据写入文件后,Kafka 就可以对请求进行响应了。
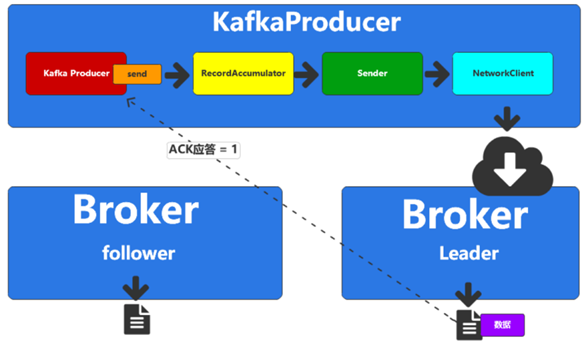
(2)此时,如果假设由于网络故障的原因,Kafka 并没有成功将 ACK 应答信息发送给 ,那么此时对于 来讲,以为 Kafka 没有收到数据,所以就会一直等待响应,一旦超过某个时间阈值,就会发生超时错误,也就是说在 Kafka 眼里,数据已经丢失了。
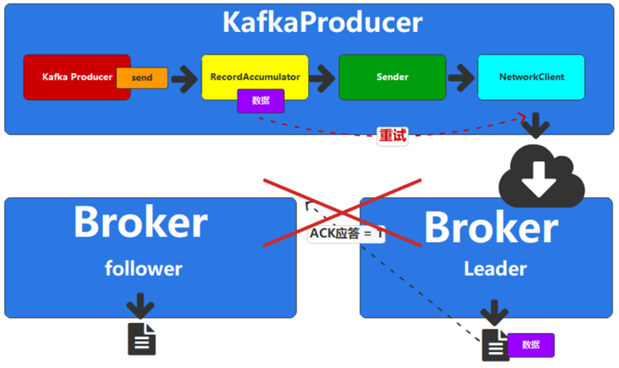
(3)所以在这种情况下,Kafka 会尝试对超时的请求数据进行重试 (retry) 操作。通过重试操作尝试将数据再次发送给 Kafka。
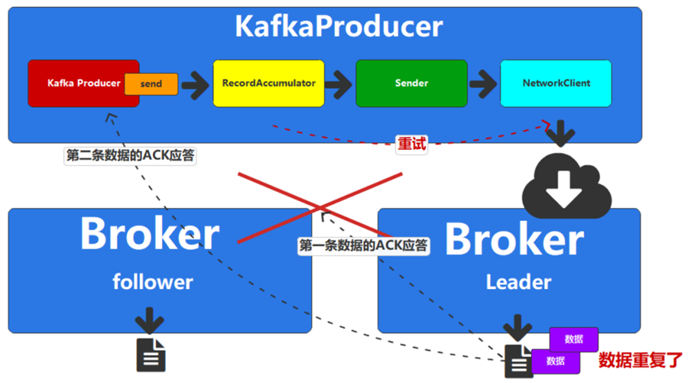
(4)如果此时发送成功,那么 Kafka 就又收到了数据,而这两条数据是一样的,也就是说,导致了数据重复。
2.4.6.2.数据乱序
(1)数据重试 (retry) 功能除了可能会导致数据重复以外,还可能会导致数据乱序。假设我们需要将编号为 1、2、3 的三条连续数据发送给 Kafka。每条数据会对应于一个连接请求:
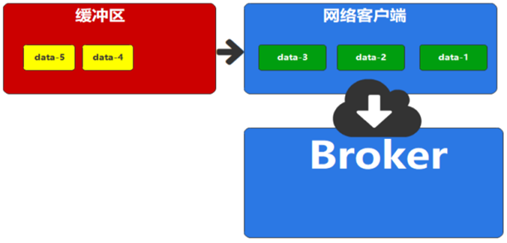
(2)此时,如果第 1 个数据的请求出现了故障,而第 2 个数据和第 3 个数据的请求正常,那么 就收到了第 2 个数据和第 3 个数据,并进行了应答。
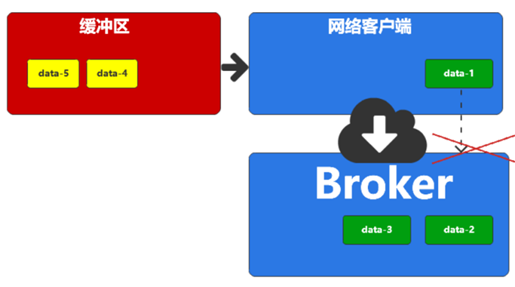
(3)为了保证数据的可靠性,此时,Kafka 会将第 1 条数据重新放回到缓冲区的第一个。进行重试操作。
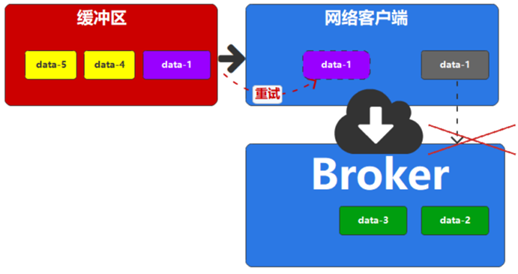
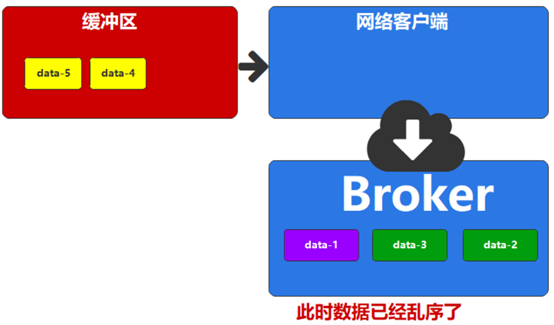
(4)如果重试成功, 收到第一条数据,此时据的顺序已经被打乱了,而某些实际场景下对数据顺序是有严格要求的。
2.4.6.3.数据幂等性
(1)为了解决 Kafka 传输数据时,所产生的数据重复和数据乱序问题,Kafka 引入了幂等性操作,所谓的幂等性,就是 同样的一条数据,无论向 Kafka 发送多少次,Kafka 都只会存储一条。注意,这里的同样的一条数据,指的不是内容一致的数据,而是指的不断重试的数据。
(2)幂等性配置在 Kafka 0.11 – 1.x 中默认是关闭的,Kafka 2.0+则默认开启。在生产者对象中的具体配置如下。
配置项配置值说明
.
true
开启幂等性
max.in…per.
小于等于 5
每个连接的在途请求数,不能大于 5,取值范围为
acks
all(-1)
确认应答,固定值,不能修改
>0
重试次数,推荐使用 Int 最大值
Map<String, Object> configMap = new HashMap<>();
//开启幂等性
configMap.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, true);
//会自动设置,但显式声明更清晰
configMap.put(ProducerConfig.ACKS_CONFIG, "all");
//重试次数
configMap.put(ProducerConfig.RETRIES_CONFIG, Integer.MAX_VALUE);
//每个连接的在途请求数
configMap.put(ProducerConfig.MAX_IN_FLIGHT_REQUESTS_PER_CONNECTION, 5);
(3)Kafka 实现数据幂等性操作总体流程如下:
(4)从上面的流程可以看出,Kafka 的幂等性是通过消耗时间和性能的方式提升了数据传输的有序和去重,在一些对数据敏感的业务中是十分重要的。但是通过原理也能明白,这种幂等性还是有缺陷的:
2.4.6.4.数据事务
(1)对于幂等性的缺陷,Kafka 可以采用事务的方式解决跨会话的幂等性。基本的原理就是通过事务功能管理生产者 ID,保证事务开启后,生产者对象总能获取一致的生产者 ID。
(2)为了实现事务,Kafka 引入了事务协调器 (r) 负责事务的处理,所有的事务逻辑包括分派生产者 ID 等都是由r 负责实施的。r 会将事务状态持久化到该主题中。
(3)事务基本的实现思路就是将配置的事务 ID 与生产者 ID 进行绑定,然后存储在 Kafka 专门管理事务的内部主题 中,而内部主题的操作是由事务协调器 (r) 对象完成的,这个协调器对象有点类似于数据发送时的那个副本 。其实这种设计是很巧妙的,因为 Kafka 将事务 ID 和生产者 ID 看成了消息数据,然后将数据发送到一个内部主题中。这样,使用事务处理的流程和自己发送数据的流程是很像的。接下来,我们就把这两个流程简单做一个对比。
2.4.6.4.1.普通数据发送流程
2.4.6.4.2.事务数据发送流程
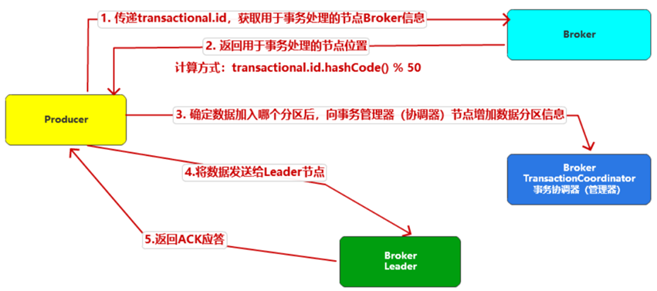
通过两张图大家可以看到,基本的事务操作和数据操作是很像的,不过要注意,我们这里只是简单对比了数据发送的过程,其实它们的区别还在于数据发送后的提交过程。普通的数据操作,只要数据写入了日志,那么对于消费者来讲。数据就可以读取到了,但是事务操作中,如果数据写入了日志,但是没有提交的话,其实数据默认情况下也是不能被消费者看到的。只有提交后才能看见数据。
2.4.6.4.3.事务提交流程
(1)Kafka 中的事务是分布式事务,所以采用的也是二阶段提交:
(2)特殊情况下,事务已经提交成功,但还是读取不到数据,那是因为当前提交成功只是一阶段提交成功,事务协调器会继续向各个 发送 信息,此操作会无限重试,直至成功。
(3)但是不同的 可能无法全部同时接收到 信息,此时有的 上的数据还是无法访问,这也是正常的,因为 Kafka 的事务不能保证强一致性,只能保证最终数据的一致性,无法保证中间的数据是一致的。不过对于常规的场景这里已经够用了,事务协调器会不遗余力的重试,直至成功。
2.4.6.4.4.事务操作代码
package com.atguigu.kafka.producer;
import org.apache.kafka.clients.producer.*;
import org.apache.kafka.common.serialization.StringSerializer;
import java.util.HashMap;
import java.util.Map;
import java.util.concurrent.ExecutionException;
import java.util.concurrent.Future;
public class KafkaProducerTransactionTest {
    public static void main(String[] args) throws ExecutionException, InterruptedException {
        //配置属性集合
        Map<String, Object> configMap = new HashMap<>();
        //配置属性:Kafka 服务器集群地址
        configMap.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        //配置属性:Kafka 生产的数据为 KV 对,所以在生产数据进行传输前需要分别对 K,V 进行对应的序列化操作
        configMap.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        configMap.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        //开启幂等性配置
        configMap.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, true);
        configMap.put(ProducerConfig.ACKS_CONFIG, "-1");
        //重试次数
        configMap.put(ProducerConfig.RETRIES_CONFIG, Integer.MAX_VALUE);
        //增加事务 id,事务是基于幂等性操作的,produceId 与 transactionId 绑定,如果这个生产者实例换了事务 id,那么 produceId 也会不同
        configMap.put(ProducerConfig.TRANSACTIONAL_ID_CONFIG, "my-tx-id");
        //配置事务超时时间
        configMap.put(ProducerConfig.TRANSACTION_TIMEOUT_CONFIG, 5);
        //创建 Kafka 生产者对象,建立 Kafka 连接,构造对象时,需要传递配置参数
        KafkaProducer<String, String> producer = new KafkaProducer<>(configMap);
        //初始化事务
        producer.initTransactions();
        try {
            //开启事务
            producer.beginTransaction();
            //准备数据,定义泛型,构造对象时需要传递 【Topic 主题名称】,【Key】,【Value】三个参数
            for (int i = 0; i < 10; i++) {
                ProducerRecord<String, String> record = new ProducerRecord<>(
                        "test", "key" + i, "value" + i
                );
                //生产(发送)数据
                Future<RecordMetadata> send = producer.send(record, new Callback() {
                    @Override
                    public void onCompletion(RecordMetadata metadata, Exception exception) {
                        //数据发送成功后,会回调此方法
                        if (exception != null) {
                            System.err.println("数据发送失败: {}" + exception.getMessage());
                        } else {
                            System.out.println("数据发送成功: " + metadata);
                        }
                    }
                });
                System.out.println("发送数据");
                send.get();
            }
            //提交事务
            producer.commitTransaction();
        } catch (Exception e) {
            e.printStackTrace();
            //终止事务
            producer.abortTransaction();
        } finally {
            //关闭生产者连接
            producer.close();
        }
    }
}
2.4.6.5.数据传输语义 传输语义说明例子
at most once
最多一次:不管是否能接收到,数据最多只传一次。这样数据可能会丢失。
, ACK=0
at least once
最少一次:消息不会丢失,如果接收不到,那么就继续发,所以会发送多次,直到收到为止,有可能出现数据重复。
ACK=1
once
精准一次:消息只会发送一次,不会丢失,也不会重复。
幂等 + 事务 + ACK=-1
2.5.存储消息
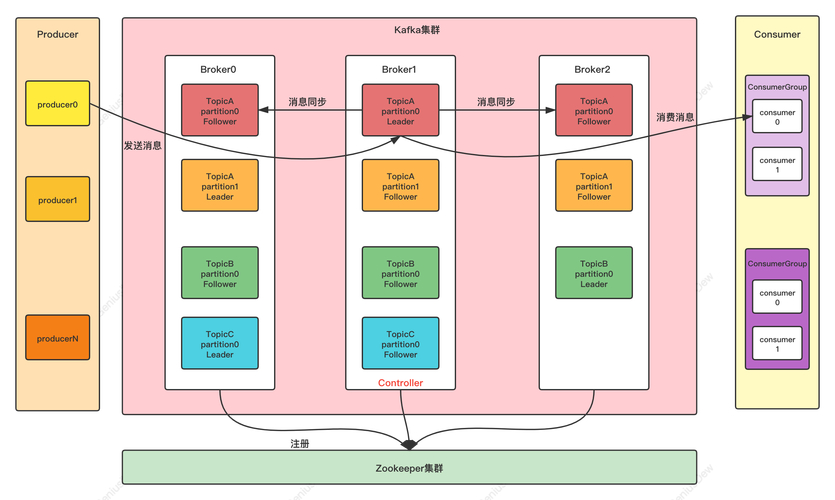
数据已经由生产者 发送给 Kafka 集群,当 Kafka 接收到数据后,会将数据写入本地文件中。
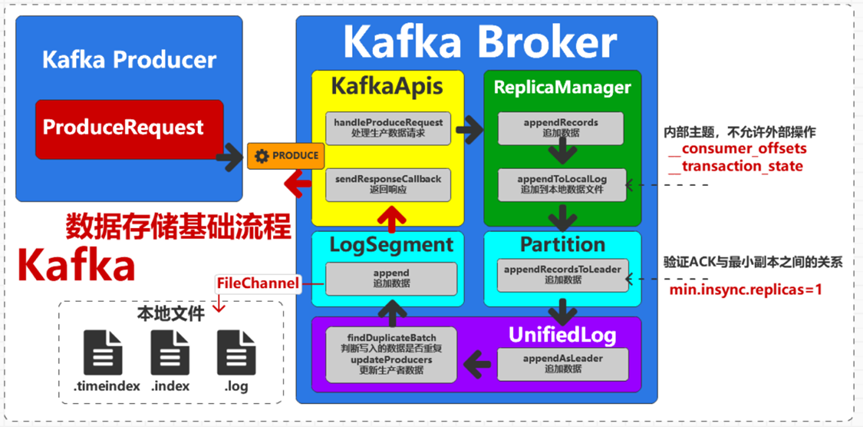
2.5.1.存储组件 参数名参数作用类型默认值推荐值
min..
最小同步副本数量
推荐
log..bytes
文件段字节数据大小限制
可选
1G = 4 byte
log.roll.hours
文件段强制滚动时间阈值
可选
7天 = 24 * 7 * 60 * 60 * 1000L ms
log.flush..
满足刷写日志文件的数据条数
可选
Long.
不推荐
log.flush..ms
满足刷写日志文件的时间周期
可选
Long.
不推荐
log.index..bytes
刷写索引文件的字节数
可选
4 * 1024
.lag.time.max.ms
副本延迟同步时间
可选
30s
2.5.2.数据存储
Kafka 节点从获取到生产者的数据请求到数据存储到文件的过程相对比较简单,只是中间会进行一些基本的数据检查和校验。所以接下来我们就将数据存储的基本流程介绍一下:
2.5.2.1.ACKS 校验
(1) 将数据发送给Kafka 时,会告知当前生产者的数据生产场景,从而要求Kafka对数据请求进行应答响应确认数据的接收情况,获取应答后可以进行后续的处理。这个数据生产场景主要考虑的就是数据的可靠性和数据发送的吞吐量。由此,Kafka将生产场景划分为3种不同的场景:
(2)基于上面的三种生产数据的场景,在存储数据前,需要校验生产者需要的应答场景是否合法有效。
2.5.2.2.内部主题校验
向 Kafka 发送数据时,必须指定主题,但是这个主题的名称不能是 Kafka 的内部主题名称。Kafka 为了管理的需要,创建了 2 个内部主题,一个是用于事务处理的 内部主题,还有一个是用于处理消费者偏移量的 内部主题。生产者是无法对这两个主题生产数据的,所以在存储数据之前,需要对主题名称进行校验有效性校验。
2.5.2.3.ACKS 应答及副本数量关系校验
(1)Kafka 为了数据可靠性更高一些,需要分区的所有副本都能够存储数据,但是分布式环境中难免会出现某个副本节点出现故障,暂时不能同步数据。在 Kafka 中,能够进行数据同步的所有副本,我们称之为 In Sync ,简称 ISR 列表。
(2)当生产者 要求的数据 ACKS 应答为 -1 的时候,那么就必须保证能够同步数据的所有副本能够将数据保存成功后,再进行数据的确认应答。但是一种特殊情况就是,如果当前 ISR 列表中只有一个 存在,那么此时只要这一个 数据保存成功了,那么就产生确认应答了,数据依然是不可靠的,那么就失去了设置 ACK = -1 的意义了,所以此时还需要对 ISR 列表中的副本数量进行约束,至少不能少于 2 个。这个数量是可以通过配置文件配置的。参数名为 min..。默认值为 1(不推荐)所以存储数据前,也需要对 ACK 应答和最小分区副本数量的关系进行校验。
2.5.2.4.日志文件滚动判断
(1)数据存储到文件中,如果数据文件太大,对于查询性能是会有很大影响的,所以副本数据文件并不是一个完整的大的数据文件,而是根据某些条件分成很多的小文件,每个小文件我们称之为文件段。其中的一个条件就是文件大小,参数名为 log..bytes。默认值为 1G。如果当前日志段剩余容量可能无法容纳新消息集合,因此有必要创建一个新的日志段来保存待写入的所有消息。此时日志文件就需要滚动生产新的。
(2)除了文件大小外,还有时间间隔,如果文件段第一批数据有时间戳,那么当前批次数据的时间戳和第一批数据的时间戳间隔大于滚动阈值,那么日志文件也会滚动生产新的。如果文件段第一批数据没有时间戳,那么就用当前时间戳和文件创建时间戳进行比对,如果大于滚动阈值,那么日志文件也会滚动生产新的。这个阈值参数名为 log.roll.hours,默认为 7 天。如果时间到达,但是文件不满 1G,依然会滚动生产新的数据文件。
(3)如果索引文件或时间索引文件满了,或者索引文件无法存放当前索引数据了,那么日志文件也会滚动生产新的。基于以上的原则,需要在保存数据前进行判断。
2.5.2.5.请求数据重复性校验
因为 Kafka 允许生产者进行数据重试操作,所以因为一些特殊的情况,就会导致数据请求被 Kafka 重复获取导致数据重复,所以为了数据的幂等性操作,需要在 端对数据进行重复性校验。这里的重复性校验只能对同一个主题分区的 5 个在途请求中数据进行校验,所以需要在生产者端进行相关配置。
2.5.2.6.请求数据序列号校验
因为 Kafka 允许生产者进行数据重试操作,所以因为一些特殊的情况,就会导致数据请求被 Kafka 重复获取导致数据顺序发生改变从而引起数据乱序。为了防止数据乱序,需要在 端对数据的序列号进行连续性(插入数据序列号和 缓冲的最后一个数据的序列号差值为 1)校验。
2.5.2.7.数据存储
将数据通过 中 对象。将数据写入日志文件,写入完成后,更新当前日志文件的数据偏移量。
2.5.3.存储文件格式
我们已经将数据存储到了日志文件中,当然除了日志文件还有其他的一些文件,所以接下来我们就了解一下这些文件:
2.5.3.1.数据日志文件
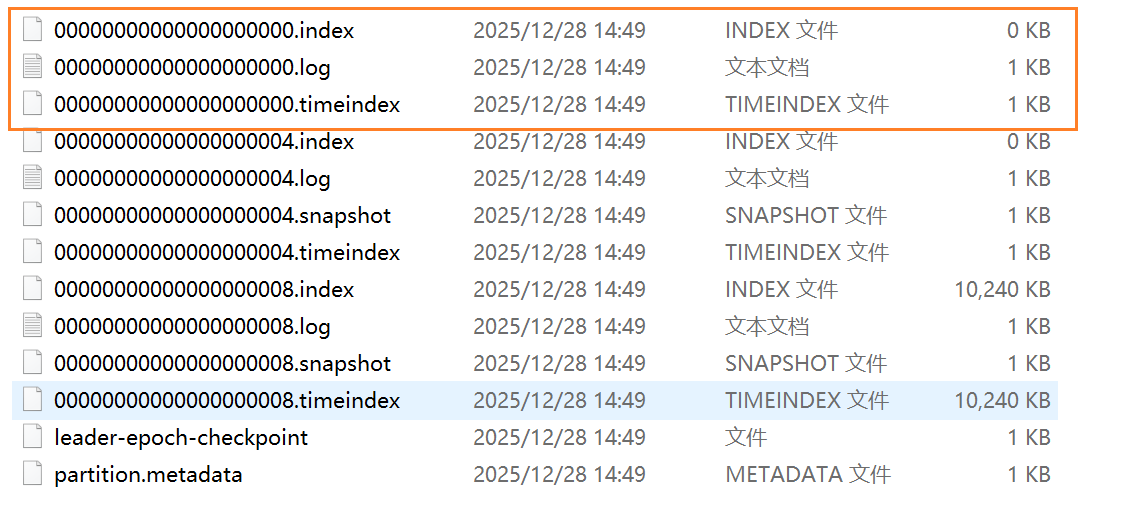
(1)Kafka 系统早期设计的目的就是日志数据的采集和传输,所以数据是使用 log 文件进行保存的。我们所说的数据文件就是以 .log 作为扩展名的日志文件。文件名长度为 20 位长度的数字字符串,数字含义为当前日志文件的第一批数据的基础偏移量,也就是文件中保存的第一条数据偏移量。字符串数字位数不够的,前面补 0。
(2)为了能快速看到日志文件中的内容,. 配置文件中的相关配置如下(实际这么配置会导致性能灾难,下面的配置只是为了达到日志文件中有内容的目的):
# 每收到 1 条消息 就强制将数据从操作系统缓存刷写到磁盘
log.flush.interval.messages=1
# 每个日志段文件最大 200 字节
log.segment.bytes=200
# 每 5 毫秒 就强制滚动创建新的日志段文件
log.roll.ms=5
执行下面的生产者代码:
package com.atguigu.kafka.producer;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.common.serialization.StringSerializer;
import java.util.HashMap;
import java.util.Map;
public class KafkaProducerTest {
    public static void main(String[] args) {
        //配置属性集合
        Map<String, Object> configMap = new HashMap<>();
        //配置属性:Kafka 服务器集群地址
        configMap.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        //配置属性:Kafka 生产的数据为 KV 对,所以在生产数据进行传输前需要分别对 K,V 进行对应的序列化操作
        configMap.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        configMap.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        configMap.put(ProducerConfig.BATCH_SIZE_CONFIG, 2);
        //创建 Kafka 生产者对象,建立 Kafka 连接,构造对象时,需要传递配置参数
        KafkaProducer<String, String> producer = new KafkaProducer<>(configMap);
        //准备数据,定义泛型,构造对象时需要传递 【Topic 主题名称】,【Key】,【Value】三个参数
        for (int i = 0; i < 10; i++) {
            ProducerRecord<String, String> record = new ProducerRecord<>(
                    "test", "key" + i, "value" + i
            );
            //生产(发送)数据
            producer.send(record);
        }
        //关闭生产者连接
        producer.close();
    }
}
进入目录 E:.12-3.6.1datakafkatest-0 中查看:
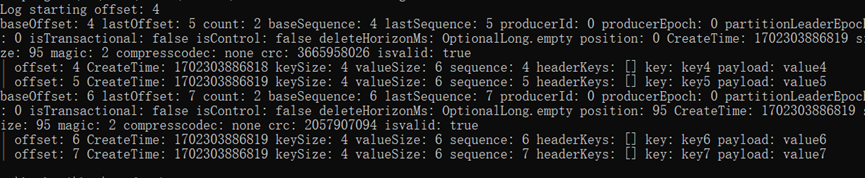
(3)查看 log 文件内容
# 在 E:kafka_2.12-3.6.1binwindows 目录的控制命令行中执行如下查看 log 文件内容的命令
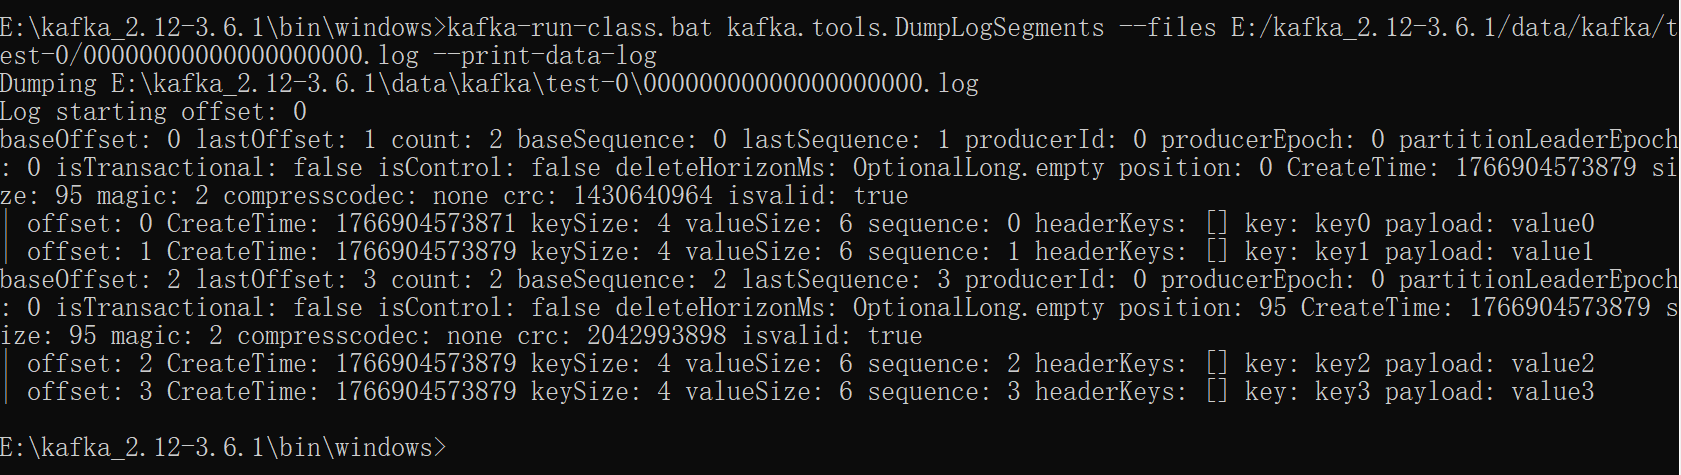
kafka-run-class.bat kafka.tools.DumpLogSegments --files E:/kafka_2.12-3.6.1/data/kafka/test-0/00000000000000000000.log --print-data-log
Log starting offset: 0
baseOffset: 0 lastOffset: 1 count: 2 baseSequence: 0 lastSequence: 1 producerId: 0 producerEpoch: 0 partitionLeaderEpoch: 0 isTransactional: false isControl: false deleteHorizonMs: OptionalLong.empty position: 0 CreateTime: 1766904573879 size: 95 magic: 2 compresscodec: none crc: 1430640964 isvalid: true
| offset: 0 CreateTime: 1766904573871 keySize: 4 valueSize: 6 sequence: 0 headerKeys: [] key: key0 payload: value0
| offset: 1 CreateTime: 1766904573879 keySize: 4 valueSize: 6 sequence: 1 headerKeys: [] key: key1 payload: value1
baseOffset: 2 lastOffset: 3 count: 2 baseSequence: 2 lastSequence: 3 producerId: 0 producerEpoch: 0 partitionLeaderEpoch: 0 isTransactional: false isControl: false deleteHorizonMs: OptionalLong.empty position: 95 CreateTime: 1766904573879 size: 95 magic: 2 compresscodec: none crc: 2042993898 isvalid: true
| offset: 2 CreateTime: 1766904573879 keySize: 4 valueSize: 6 sequence: 2 headerKeys: [] key: key2 payload: value2
| offset: 3 CreateTime: 1766904573879 keySize: 4 valueSize: 6 sequence: 3 headerKeys: [] key: key3 payload: value3
我们的常规数据主要分为两部分:批次头 + 数据体。
2.5.3.1.1.批次头 数据项含义长度
基础偏移量偏移量
长度偏移量
分区纪元偏移量
魔数偏移量
属性偏移量
T
基础时间戳偏移量
最大时间戳偏移量
FSET
最后偏移量偏移量
生产者 ID 偏移量
T
生产者纪元偏移量
基础序列号偏移量
记录数量偏移量
CRC校验偏移量
批次头总的字节数为:61 byte
2.5.3.1.2.数据体 数据项含义长度
size
固定值
固定值
时间戳
Key字节长度
1(动态)
()
Key变量压缩长度算法需要大小
1(动态)
value字节长度
1(动态)
()
Value变量压缩长度算法需要大小
1(动态)
数组固定长度
1(动态)
上面长度之和的压缩长度算法需要大小
表中的后 5 个值为动态值,需要根据数据的中 key、value 变化计算得到。此处以数据 key=key1、value= 为例来进行计算:
# 压缩长度算法:
中间值1 = (算法参数 << 1) ^ (算法参数 >> 31));
中间值2 = Integer.numberOfLeadingZeros(中间值1);
结果    = (38 - 中间值2) / 7 + 中间值2 / 32;
假设当前 key 为 key1,调用算法时,参数为 key.length = 4
中间值1 = (4<<1) ^ (4>>31) = 8
中间值2 = Integer.numberOfLeadingZeros(8) = 28
结果    = (38-28)/7 + 28/32 = 1 + 0 = 1
所以如果 key 取值为 key1,那么key的变长长度就是1
按照上面的计算公式可以计算出,如果我们发送的数据是一条为 (key1, ) 的数据, 那么 Kafka 当前会向日志文件增加的数据大小为:
# 追加数据字节计算
批次头 = 61
数据体 = 1 + 1 + 1 + 4 + 1 + 6 + 1 + 1 + 1 = 17
总的字节大小为61 + 17 = 78
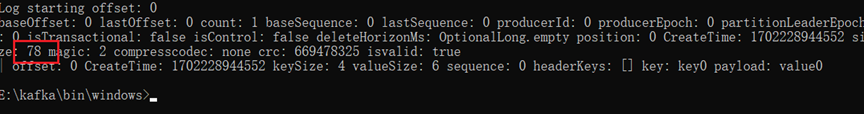
如果我们发送的数据是两条为 (key1, )、(key2, ) 的数据, 那么 Kafka 当前会向日志文件增加的数据大小为:
# 追加数据字节计算
第一条数据:
批次头 = 61
数据体 = 1 + 1 + 1 + 4 + 1 + 6 + 1 + 1 + 1 = 17
第二条数据:
# 因为字节少,没有满足批次要求,所以两条数据是在一批中的,那么批次头不会重新计算,直接增加数据体即可
数据体 = 1 + 1 + 1 + 4 + 1 + 6 + 1 + 1 + 1 = 17
总的字节大小为61 + 17 + 17 = 95
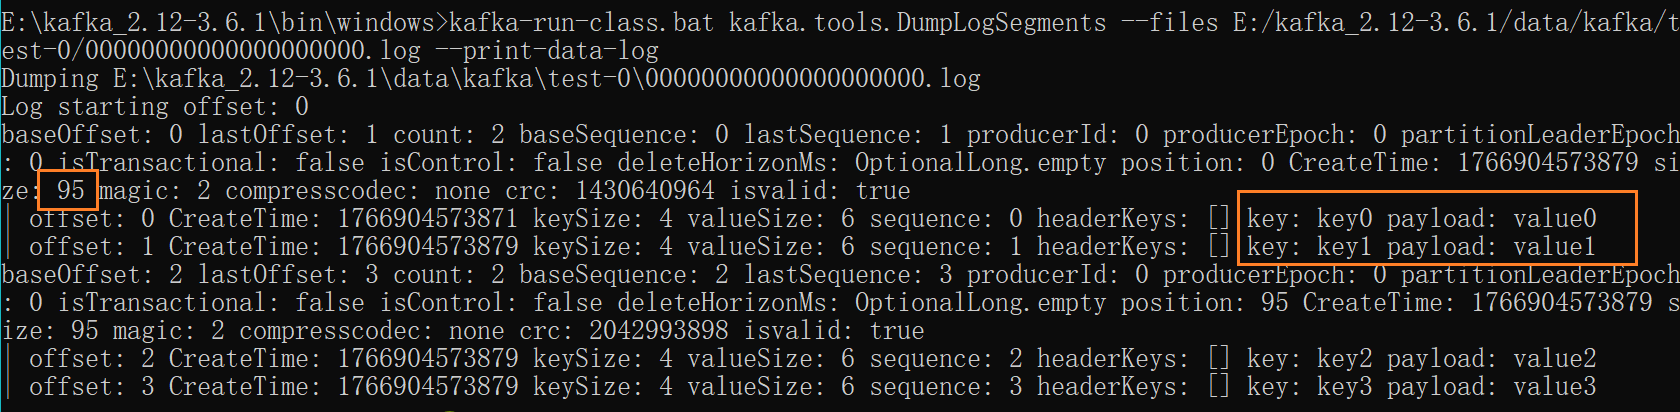
2.5.3.1.3.数据含义 数据项含义
当前 batch 中第一条消息的位移
最新消息的位移相对于第一条消息的唯一增量
count
当前 batch 有的数据数量,Kafka 在进行消息遍历的时候,可以通过该字段快速的跳跃到下一个 batch 进行数据读取
记录了当前消息所在分区的 的服务器版本(纪元),主要用于进行一些数据版本的校验和转换工作
crc
当前整个 batch 的数据 crc 校验码,主要用于对数据进行差错校验的
数据压缩格式,主要有 GZIP、LZ4、、zstd 四种
当前批次中的基础序列号
当前批次中的最后一个序列号
生产者 ID
记录了当前消息所在分区的 的服务器版本(纪元)
是否开启事务
magic
魔数(Kafka 服务程序协议版本号)
数据创建的时间戳
控制类数据,false – 普通消息,应用程序通过 发送,true – 控制消息,Kafka 内部自动生成的事务控制元数据 ()
压缩格式,默认无
数据是否有效
数据偏移量,从 0 开始
key
数据 key
数据 value
当前批次中数据的序列号
当前批次中最后一条数据的创建时间戳
2.5.3.2.数据索引文件
(1)Kafka 的基础设置中,数据日志文件到达 1G 才会滚动生产新的文件。那么从 1G 文件中想要快速获取我们想要的数据,效率还是比较低的。通过前面的介绍,如果我们能知道数据在文件中的位置 (),那么定位数据就会快很多,问题在于我们如何才能在知道这个位置呢?
(2)Kafka 在存储数据时,都会保存数据的偏移量信息,而偏移量是从 0 开始计算的。简单理解就是数据的保存顺序。比如第一条保存的数据,那么偏移量就是 0,第二条保存的数据偏移量就是 1,但是这个偏移量只是告诉我们数据的保存顺序,却无法定位数据,不过需要注意的是,每条数据的大小是可以确定的(参考上一个小节的内容)。既然可以确定,那么数据存放在文件的位置起始也就是确定了,所以 Kafka 在保存数据时,其实是可以同时保存位置的,那么我们在访问数据时,只要通过偏移量其实就可以快速定位日志文件的数据了。
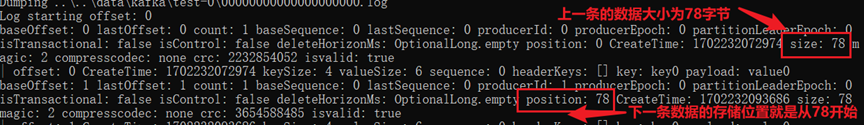
(3)不过这依然有问题,就是数据量太多了,对应的偏移量也太多了,并且主题分区的数据文件会有很多,那我们是如何知道数据在哪一个文件中呢?为了定位方便 Kafka 在提供日志文件保存数据的同时,还提供了用于数据定位的索引文件,索引文件中保存的就是逻辑偏移量和数据物理存储位置(偏移量)的对应关系。并且还记得吗?每个数据日志文件的名称就是当前文件中数据䣌起始偏移量,所以通过偏移量就可以快速选取文件以及定位数据的位置从而快速找到数据。这种感觉就有点像 Java 的 通过 Key 可以快速找到Value的感觉一样,如果不知道 Key,那么从 中获取 Value 是不是就特别慢。道理是一样的。
(4)Kafka 的数据索引文件都保存了什么呢?来看一下:
# 在 E:kafka_2.12-3.6.1binwindows 目录的控制命令行中执行如下查看 index 文件内容的命令
kafka-run-class.bat kafka.tools.DumpLogSegments --files E:/kafka_2.12-3.6.1/data/kafka/test-0/00000000000000000000.index --print-data-log
通过图片可以看到,索引文件中保存的就是逻辑偏移量和物理偏移量位置的关系。
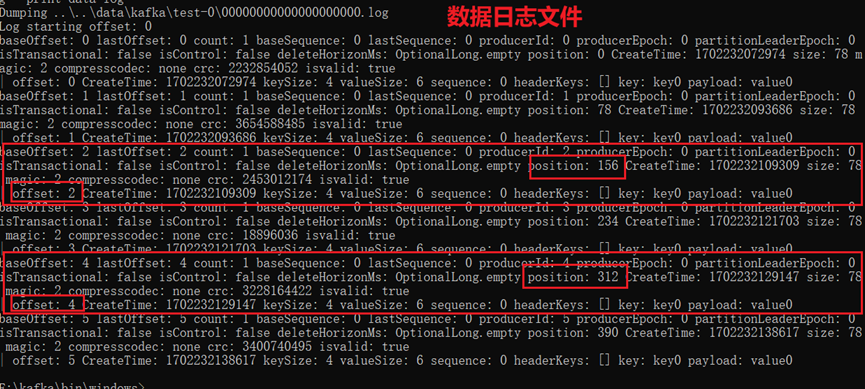
有了这个索引文件,那么我们根据数据的顺序获取数据就非常的方便和高效了。不过,相信大家也注意到了,那就是索引文件中的 并不连续。那如果我想获取 等于 3 的数据怎么办?其实也不难,因为 等于 3 不就是 等于 2 的一下条吗?那我使用 等于 2 的数据的 + size 不就定位了 等于 3 的位置了吗,当然了我举得例子有点过于简单了,不过本质确实差的不多,Kafka 在查询定位时其实采用的就是二分查找法。
(5)不过,为什么 Kafka 的索引文件是不连续的呢?那是因为如果每条数据如果都把偏移量的定位保存下来,数据量也不小,还有就是,如果索引数据丢了几条,其实并不会太影响查询效率,比如咱们之前举的 等于 3 的定位过程。因为 Kafka 底层实现时,采用的是虚拟内存映射技术 mmap (-Map),将内存和文件进行双向映射,操作内存数据就等同于操作文件,所以效率是非常高的,但是因为是基于内存的操作,所以并不稳定,容易丢数据,因此 Kafka 的索引文件中的索引信息是不连续的,而且为了效率,Kafka 默认情况下,4kb 的日志数据才会记录一次索引,但是这个是可以进行配置修改的,参数为 log.index..bytes,默认值为 4096。所以我们有的时候会将 Kafka 的不连续索引数据称之为稀疏索引。
2.5.3.3.数据时间索引文件
(1)某些场景中,我们不想根据顺序(偏移量)获取 Kafka 的数据,而是想根据时间来获取的数据。这个时候,可没有对应的偏移量来定位数据,那么查找的效率就非常低了,因为 Kafka 还提供了时间索引文件,咱们来看看它的内容是什么
# 在 E:kafka_2.12-3.6.1binwindows 目录的控制命令行中执行如下查看 index 文件内容的命令
kafka-run-class.bat kafka.tools.DumpLogSegments --files E:/kafka_2.12-3.6.1/data/kafka/test-0/00000000000000000000.timeindex --print-data-log
(2)通过图片,大家可以看到,这个时间索引文件起始就是将时间戳和偏移量对应起来了,那么此时通过时间戳就可以找到偏移量,再通过偏移量找到定位信息,再通过定位信息找到数据就非常方便了。
2.5.4.数据刷写
(1)在 Linux 系统中,当我们把数据写入文件系统之后,其实数据在操作系统的 (页缓冲)里面,并没有刷到磁盘上。如果操作系统挂了,数据就丢失了。一方面,应用程序可以调用 fsync 这个系统调用来强制刷盘,另一方面,操作系统有后台线程,定时刷盘。频繁调用 fsync 会影响性能,需要在性能和可靠性之间进行权衡。实际上,Kafka 提供了参数进行数据的刷写:
(2)log.flush.. 和 log.flush..ms 无论哪个达到,都会 flush。官方不建议通过上述的三个参数来强制写盘,数据的可靠性应该通过 来保证,而强制 flush 数据到磁盘会对整体性能产生影响。
2.5.5.副本同步
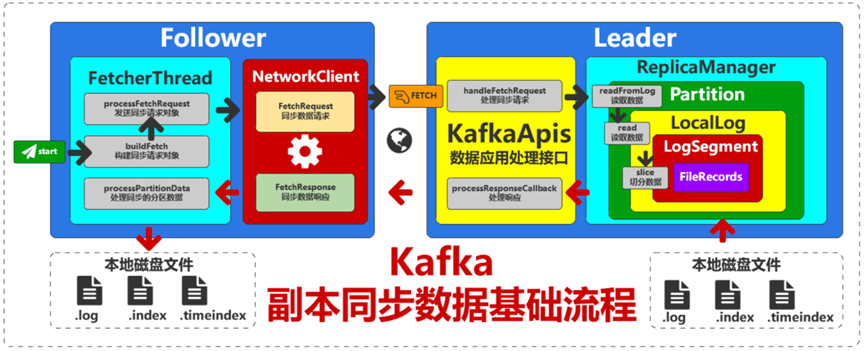
Kafka 中,分区的某个副本会被指定为 ,负责响应客户端的读写请求。分区中的其他副本自动成为 ,主动拉取(同步) 副本中的数据,写入自己本地日志,确保所有副本上的数据是一致的。
2.5.6.1.启动数据同步线程
(1)Kafka 创建主题时,会根据副本分配策略向指定的 节点发出请求,将不同的副本节点设定为 或 。一旦某一个 节点设定为 节点,那么 节点会启动数据同步线程 ,从 副本节点同步数据。
(2)线程运行后,会不断重复两个操作:截断 () 和抓取 (fetch)。
2.5.6.2.生成数据同步请求
启动线程后,需要周期地向 节点发送 fetch 请求,用于从 获取数据。
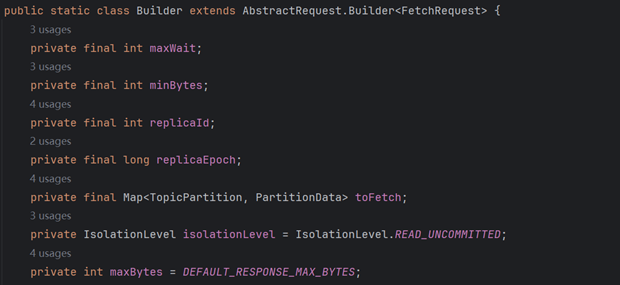
等待节点的响应的过程中,会阻塞当前同步数据线程。
2.5.6.3.处理数据响应
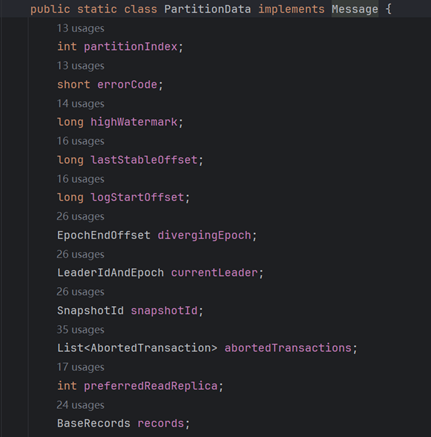
当 副本返回响应数据时,其中会包含多个分区数据,当前副本会遍历每一个分区,将分区数据写入数据文件中。
2.5.6.4.更新数据偏移量
当 副本返回响应数据时,除了包含多个分区数据外,还包含了和偏移量相关的数据 HW 和 LSO,副本需要根据场景对 返回的不同偏移量进行更新。
2.5.6.4.1.
Kafka 的每个分区的数据都是有序的kafka java,所谓的数据偏移量 (),指的就是 Kafka 在保存数据时,用于快速定位数据的标识,类似于 Java 中数组的索引,从 0 开始。
Kafka的数据文件以及数据访问中包含了大量和偏移量的相关的操作。
2.5.6.4.1.LSO
起始偏移量 (Log Start , LSO),每个分区副本都有起始偏移量,用于表示副本数据的起始偏移位置,初始值为 0。LSO一般情况下是无需更新的,但是如果数据过期,或用户手动删除数据时, 的 Log Start 可能发生变化, 副本的日志需要和 保持严格的一致,因此,如果 的该值发生变化, 自然也要发生变化保持一致。
2.5.6.4.3.LEO
日志末端位移 (Log End , LEO),表示下一条待写入消息的 ,每个分区副本都会记录自己的 LEO。对于 副本而言,它能读取到 副本 LEO 值以下的所有消息。
2.5.6.4.1.HW
高水位值 (High ),定义了消息可见性,标识了一个特定的消息偏移量 (),消费者只能拉取到这个水位 之前的消息,同时这个偏移量还可以帮助 Kafka 完成副本数据同步操作。
2.5.6.数据一致性 2.5.6.1.数据一致性
(1)Kafka 的设计目标是:高吞吐、高并发、高性能。为了做到以上三点,它必须设计成分布式的,多台机器可以同时提供读写,并且需要为数据的存储做冗余备份。
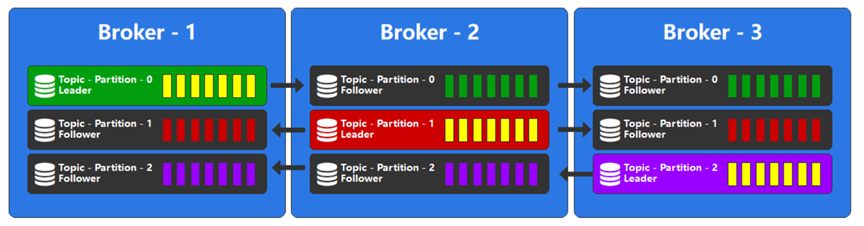
(2)上图中的主题有 3 个分区,每个分区有 3 个副本,这样数据可以冗余存储,提高了数据的可用性。并且 3 个副本有两种角色, 和 , 副本会同步 副本的数据。一旦 副本挂了, 副本可以选举成为新的 副本, 这样就提升了分区可用性,但是相对的,在提升了分区可用性的同时,也就牺牲了数据的一致性。
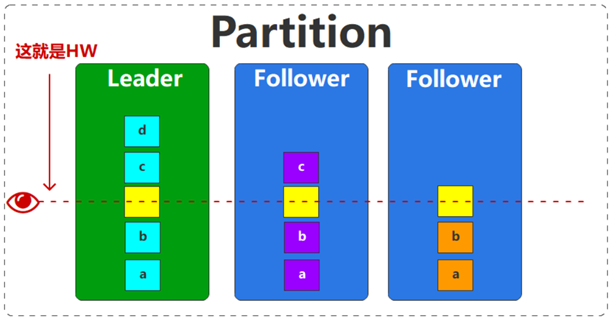
(3)我们来看这样的一个场景:一个分区有 3 个副本,一个 和两个 。 副本作为数据的读写副本,所以生产者的数据都会发送给 副本,而两个 副本会周期性地同步 副本的数据,但是因为网络,资源等因素的制约,同步数据的过程是有一定延迟的,所以 3 个副本之间的数据可能是不同的。具体如下图所示:
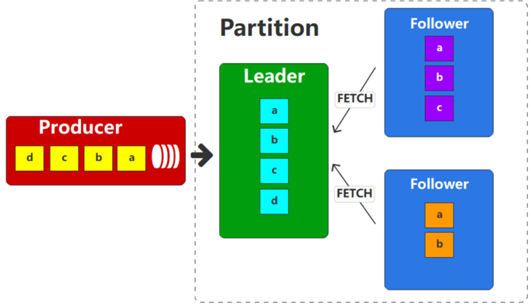
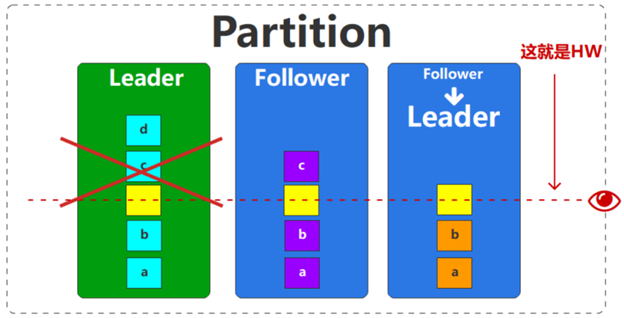
(4)此时,假设 副本因为意外原因宕掉了,那么 Kafka 为了提高分区可用性,此时会选择 2 个 副本中的一个作为 对外提供数据服务。此时我们就会发现,对于消费者而言,之前 副本能访问的数据是 d,但是重新选择 副本后,能访问的数据就变成了 c,这样消费者就会认为数据丢失了,也就是所谓的数据不一致了。
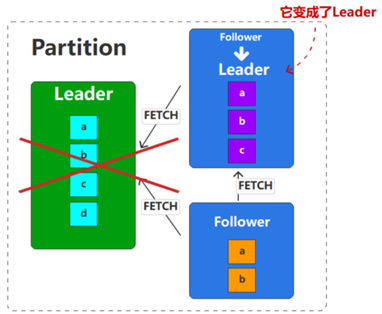
(5)为了提升数据的一致性,Kafka 引入了高水位 (HW: High ) 机制,Kafka 在不同的副本之间维护了一个水位线的机制(其实也是一个偏移量的概念),消费者只能读取到水位线以下的的数据。这就是所谓的木桶理论:木桶中容纳水的高度,只能是水桶中最短的那块木板的高度。这里将整个分区看成一个木桶,其中的数据看成水,而每一个副本就是木桶上的一块木板,那么这个分区(木桶)可以被消费者消费的数据(容纳的水)其实就是数据最少的那个副本的最后数据位置(木板高度)。
(6)也就是说,消费者一开始在消费 的时候,虽然 副本中已经有 a、b、c、d 这 4 条数据,但是由于高水位线的限制,所以也只能消费到 a、b 这两条数据。
这样即使 挂掉了,但是对于消费者来讲,消费到的数据其实还是一样的,因为它能看到的数据是一样的,也就是说,消费者不会认为数据不一致。
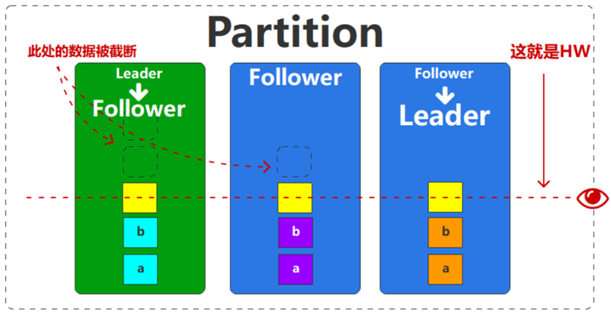
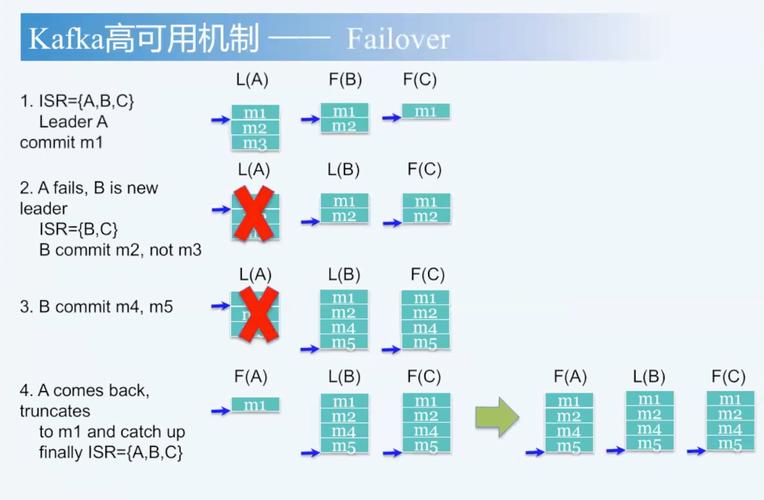
不过也要注意,因为 要求和 的日志数据严格保持一致,所以就需要根据现在 的数据偏移量值对其他的副本进行数据截断 () 操作。
2.5.6.2.HW 在副本之间的传递
(1)HW 高水位线会随着 的数据同步操作,而不断上涨,也就是说, 同步的数据越多,那么水位线也就越高,那么消费者能访问的数据也就越多。接下来,我们就看一看, 在同步数据时 HW 的变化。
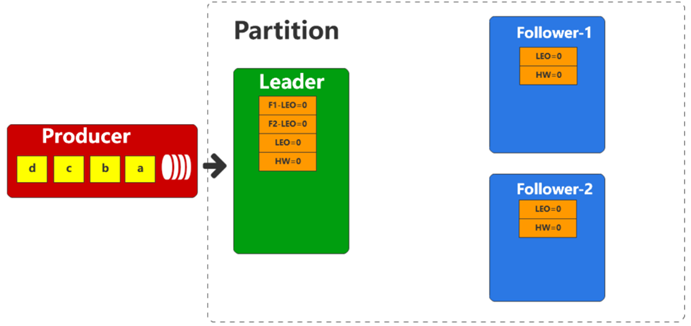
(2)首先,初始状态下, 和 都没有数据,所以和偏移量相关的值都是初始值 0kafka java Kafka——入门与基础,而由于 需要管理 ,所以也包含着 的相关偏移量 (LEO) 数据。
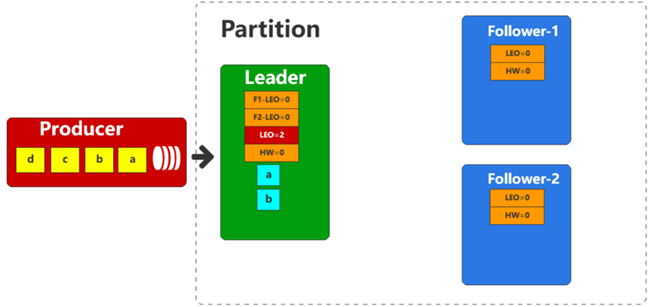
生产者向 发送两条数据, 收到数据后,会更新自身的偏移量信息。
// Leader 副本偏移量更新:
LEO=LEO+2=2
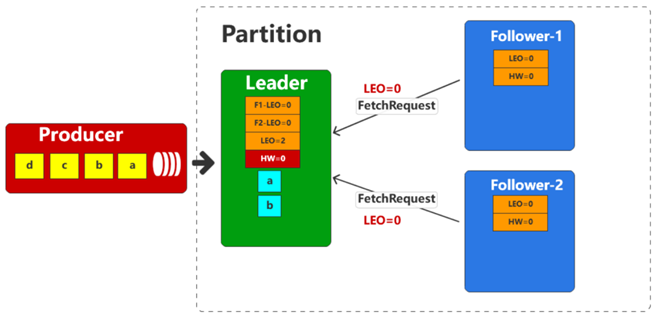
接下来, 开始同步的数据,同步数据时,会将自身的 LEO 值作为参数传递给 。此时, 会将数据传递给 ,且同时 会根据所有副本的 LEO 值更新 HW。
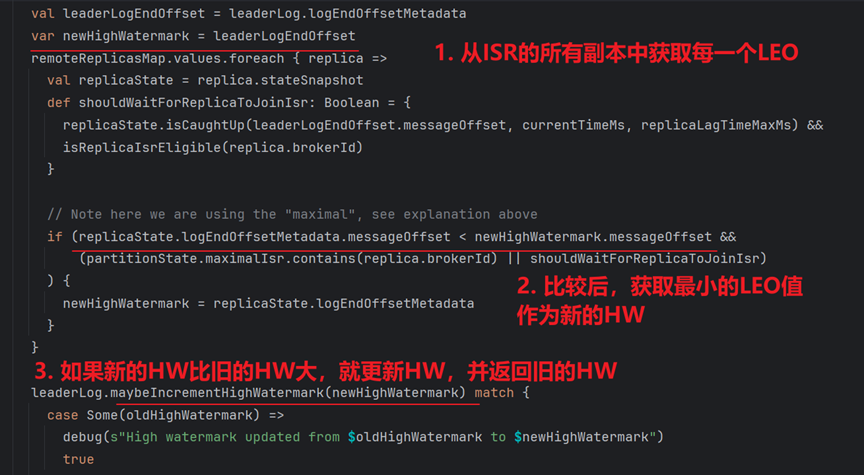
// Leader 副本偏移量更新:
HW = Math.max[HW, min(LeaderLEO,F1-LEO,F2-LEO)]=0
由于两个 的数据拉取速率不一致,所以 -1 抓取了 2 条数据,而 -2 抓取了 1 条数据。 再收到数据后,会将数据写入文件,并更新自身的偏移量信息。
// Follower-1 副本偏移量更新:
LEO=LEO+2=2
HW = Math.min[LeaderHW, LEO]=0
// Follower-2 副本偏移量更新:
LEO=LEO+1=1
HW = Math.min[LeaderHW, LEO]=0
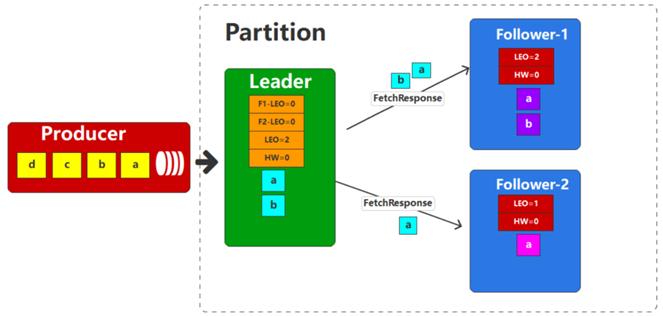
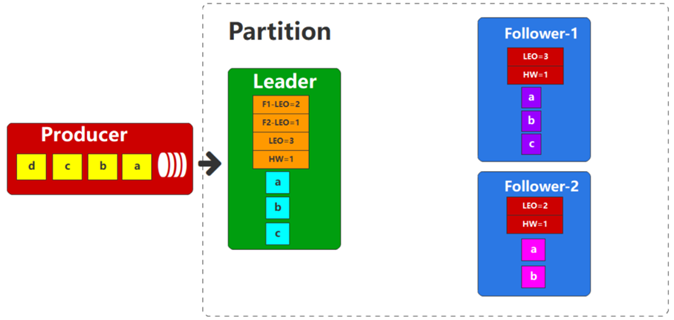
接下来 收到了生产者的数据 c,那么此时会根据相同的方式更新自身的偏移量信息
// Leader 副本偏移量更新:
LEO=LEO+1=3
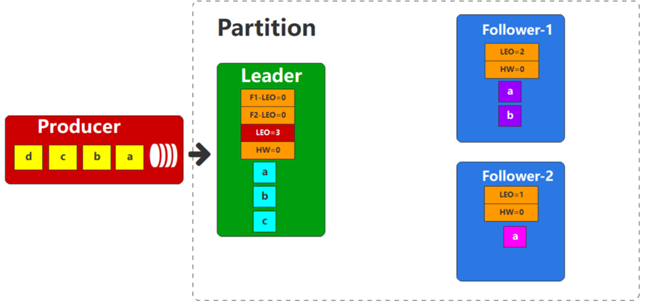
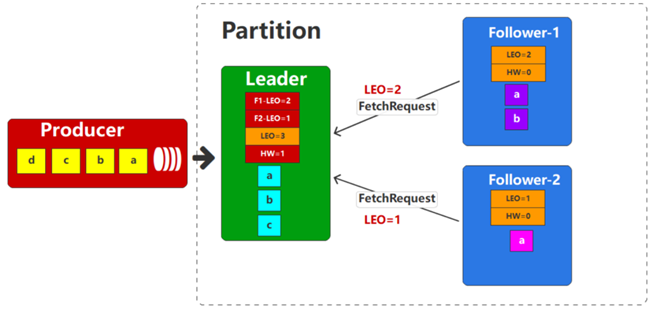
接着向 发送 Fetch 请求,同样会将最新的 LEO 作为参数传递给 。 收到请求后,会更新自身的偏移量信息。
// Leader 副本偏移量更新:
HW = Math.max[HW, min(LeaderLEO,F1-LEO,F2-LEO)]=0
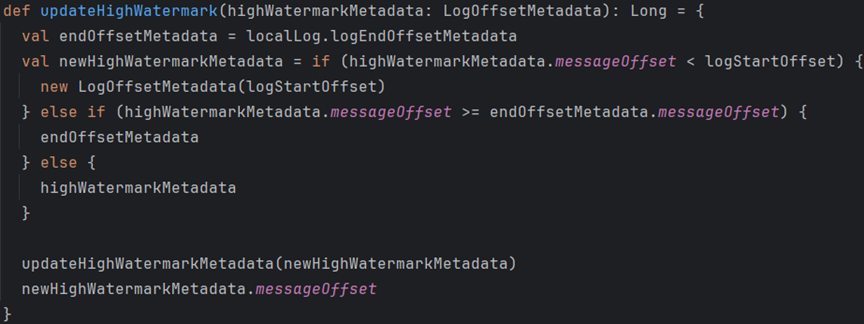
此时, 会将数据发送给 ,同时也会将 HW 一起发送。
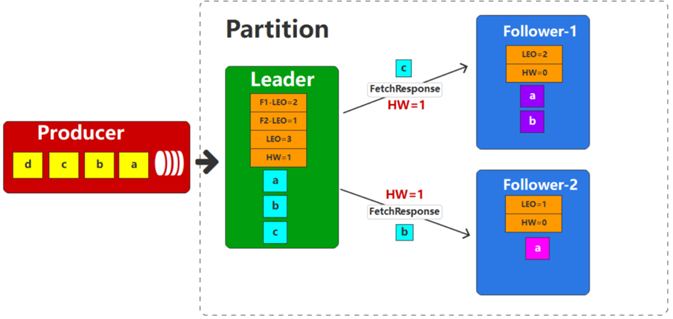
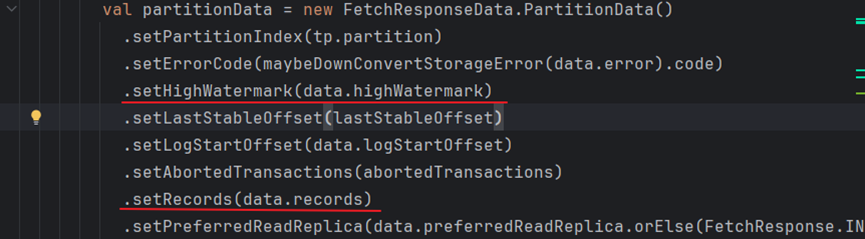
收到数据后,会将数据写入文件,并更新自身偏移量信息
// Follower-1 副本偏移量更新:
LEO=LEO+1=3
HW = Math.min[LeaderHW, LEO]=1
// Follower-2 副本偏移量更新:
LEO=LEO+1=2
HW = Math.min[LeaderHW, LEO]=1
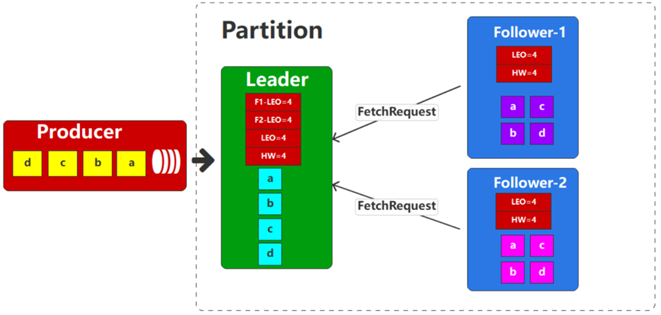
因为 会不断重复 Fetch 数据的过程,所以前面的操作会不断地重复。最终, 副本和 副本的数据和偏移量是保持一致的。
上面演示了副本列表 ISR 中 副本和 副本之间 HW 偏移量的变化过程,但特殊情况是例外的。比如当前副本列表 ISR 中只剩下了 一个副本的场合下,是不需要等待其他副本的,直接推高 HW 即可。
2.5.6.3.ISR (In-Sync ) 变化和传播
(1)在 Kafka 中,一个 Topic(主题)包含多个 (分区),Topic 是逻辑概念,而 是物理分组。一个 包含多个(副本),副本有两种类型 / , 之间是一个 副本对应多个 副本。注意:分区数可以大于节点数,但副本数不能大于节点数。因为副本需要分布在不同的节点上,才能达到备份的目的。
(2)Kafka 的分区副本中只有 副本具有数据写入的功能,而 副本需要不断向 发出申请,进行数据的同步。这里所有同步的副本会形成一个列表,我们称之为同步副本列表 (In-Sync ) ,也可以简称 ISR,除了 ISR 以外,还有已分配的副本列表 ( ),简称 AR。这里的 AR 其实不仅仅包含 ISR,还包含了没有同步的副本列表 (Out-of-Sync ),即从 ISR 中被踢出的副本(例如同步过程持续失败导致),简称 OSR。
(3)生产者 生产数据时,ACKS 应答机制如果设置为 all,那此时就需要保证同步副本列表 ISR 中的所有副本全部接收完毕后,Kafka 才会进行确认应答。数据存储时,只有 ISR 中的所有副本 LEO 数据都更新了,才有可能推高 HW 偏移量的值。这就可以看出,ISR 在 Kafka 集群的管理中是非常重要的。
(4)在 节点中,有一个副本管理器组件 (),除了读写副本、管理分区和副本的功能之外,还有一个重要的功能,那就是管理 ISR。这里的管理主要体现在两个方面:
2.6.消费消息 2.6.1.消费消息的基本步骤
(1)创建 Map 类型的配置对象,根据场景增加相应的配置属性:
参数名参数作用类型默认值推荐值
.
集群地址,格式为 :端口号,:端口号
必须
key.
对数据 Key 进行反序列化的类完整名称
必须
Kafka 提供的字符串反序列化类:mon..
value.
对数据 Value 进行反序列化的类完整名称
必须
Kafka 提供的字符串反序列化类:mon..
group.id
消费者组 ID,用于标识完整的消费场景,一个组中可以包含多个不同的消费者对象。
必须
auto..reset
当消费者组中没有初始偏移量或服务器上不再存在当前偏移量(例如,数据被删除)时,应该怎么办
可选
/ / none
group..id
消费者实例 ID,如果指定,那么在消费者组中使用此 ID 作为 前缀
可选
null
..
分区分配策略
可选
, ignor
, , , ignor
mit
启用偏移量自动提交
可选
true
true / false
mit..ms
自动提交周期
可选
根据业务可靠性要求调整
fetch.max.bytes
消费者获取服务器端一批消息最大的字节数。如果服务器端一批次的数据大于该值(50m)仍然可以拉取回来这批数据,因此,这不是一个绝对最大值。一批次的大小受.max.bytes ( )or max..bytes (topic )影响
可选
(50 m)
ic.num.
偏移量消费主题分区数
可选
50
(2)创建消费者对象:根据配置创建消费者对象 ,向 Kafka 订阅 () 主题消息,并向 Kafka 发送请求 (poll) 获取数据。
(3)获取数据:Kafka 会根据消费者发送的参数,返回数据对象 。返回的数据对象中包括指定的数据。
数据项数据含义
topic
主题名称
分区号
偏移量
数据时间戳
key
数据 key
value
数据 value
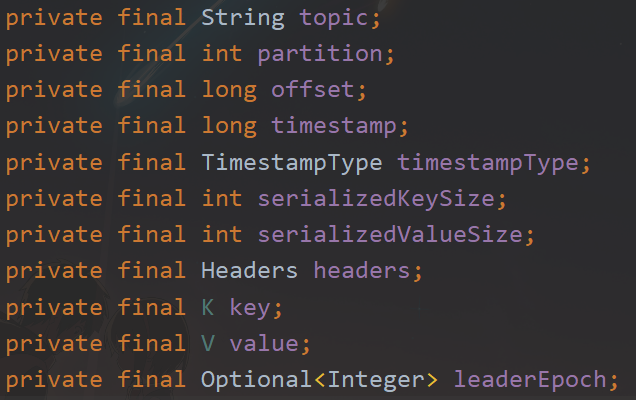
(4)关闭消费者:消费者消费完数据后,需要将对象关闭用以释放资源。一般情况下,消费者无需关闭。
2.6.2.消费消息的基本代码
package com.atguigu.kafka.consumer;
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.common.serialization.StringDeserializer;
import java.time.Duration;
import java.util.Collections;
import java.util.HashMap;
import java.util.Map;
public class KafkaConsumerOffsetTest {
    public static void main(String[] args) {
        //配置属性集合
        Map<String, Object> configMap = new HashMap<String, Object>();
        //配置属性:Kafka 集群地址
        configMap.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        //配置属性: Kafka 传输的数据为KV对,所以需要对获取的数据分别进行反序列化
        configMap.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        configMap.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        //配置属性: 消费者组
        configMap.put(ConsumerConfig.GROUP_ID_CONFIG, "atguigu");
        KafkaConsumer<String, String> consumer = new KafkaConsumer<>(configMap);
        //消费者订阅指定主题的数据
        consumer.subscribe(Collections.singletonList("test"));
        while (true) {
            //每隔 100 毫秒,抓取一次数据
            ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
            //打印抓取的数据
            for (ConsumerRecord<String, String> record : records) {
                System.out.println(record);
            }
        }
    }
}
2.6.3.消费消息的基本原理
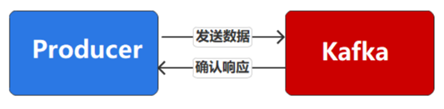
从数据处理的角度来讲,消费者和生产者的处理逻辑都相对比较简单。生产者的基本数据处理逻辑就是向 Kafka 发送数据,并获取 Kafka 的数据接收确认响应。
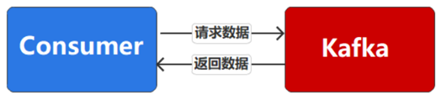
而消费者的基本数据处理逻辑就是向 Kafka 请求数据,并获取 Kafka 返回的数据。
逻辑确实很简单,但是 Kafka 为了能够构建高吞吐,高可靠性,高并发的分布式消息传输系统,所以在很多细节上进行了扩展和改善:比如生产者可以指定分区,可以异步和同步发送数据,可以进行幂等性操作和事务处理。对应的,消费者功能和处理细节也进行了扩展和改善。
2.6.3.1.消费者组 2.6.3.1.1.消费数据的方式:push & pull
(1)Kafka 的主题如果就一个分区的话,那么在硬件配置相同的情况下,消费者 消费主题数据的方式没有什么太大的差别。
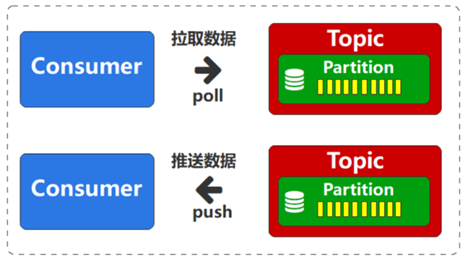
(2)不过,Kafka 为了能够构建高吞吐,高可靠性,高并发的分布式消息传输系统,它的主题是允许多个分区的,那么就会发现不同的消费数据的方式区别还是很大的。
2.6.3.1.2.消费者组 Group
(1)消费者可以根据自身的消费能力主动拉取 Kafka 的数据,但是毕竟自身的消费能力有限,如果主题分区的数据过多,那么消费的时间就会很长。对于 Kafka 来讲,数据就需要长时间的进行存储,那么对 Kafka 集群资源的压力就非常大。如果希望提高消费者的消费能力,并且减少 Kafka 集群的存储资源压力。所以有必要对消费者进行横向伸缩,从而提高消息消费速率。
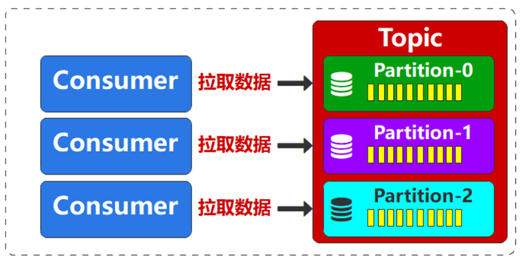
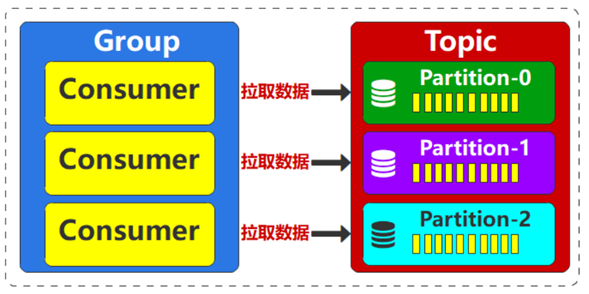
(2)不过这么做有一个问题,就是每一个消费者是独立,那么一个消费者就不能消费主题中的全部数据,简单来讲,就是对于某一个消费者个体来讲,主题中的部分数据是没有消费到的,也就会认为数据丢了,这个该如何解决呢?那如果我们将这多个消费者当成一个整体,是不是就可以了呢?这就是所谓的消费者组 ( Group)。在 Kafka 中,每个消费者都对应一个消费组,消费者可以是一个线程,一个进程,一个服务实例,如果 Kafka 想要消费消息,那么需要指定消费那个主题的消息以及自己的消费组 id ()。
2.6.3.2.调度(协调)器
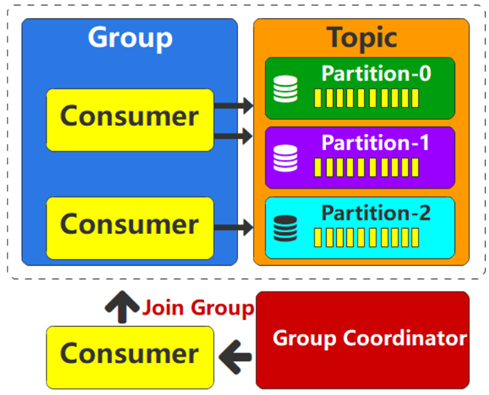
(1)消费者想要拉取数据,首先必须要加入到一个组中,成为消费组中的一员,同样道理,如果消费者出现了问题,也应该从消费者组中剥离。而这种加入组和退出组的处理,都应该由专门的管理组件进行处理,这个组件在 Kafka 中,我们称之为消费者组调度(协调)器 (Group )
(2)Group 是 上的一个组件,用于管理和调度消费者组的成员、状态、分区分配、偏移量等信息。每个 都有一个 Group 对象,负责管理多个消费者组,但每个消费者组只有一个 Group 。
2.6.3.3.消费者分配策略
(1)消费者想要拉取主题分区的数据,首先必须要加入到一个组中。
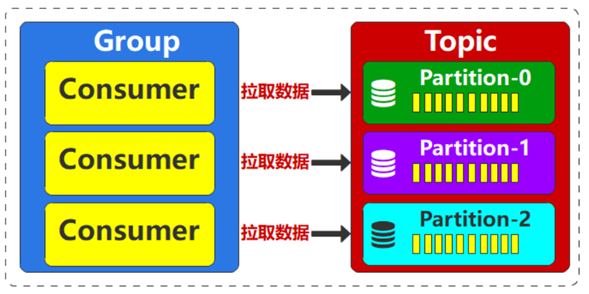
(2)但是一个组中有多个消费者的话,那么每一个消费者该如何消费呢,是不是像图中一样的消费策略呢?如果是的话,那假设消费者组中只有 2 个消费者或有 4 个消费者,和分区的数量不匹配,怎么办?所以这里,我们需要给大家介绍一下,Kafka 中基本的消费者组中的消费者和分区之间的分配规则:
(3)消费者中的每个消费者到底消费哪一个主题分区,这个分配策略其实是由消费者的 决定的,这个 我们称之为群主。群主是多个消费者中,第一个加入组中的消费者,其他消费者我们称之为 ,称呼上有点类似与分区的 和 。
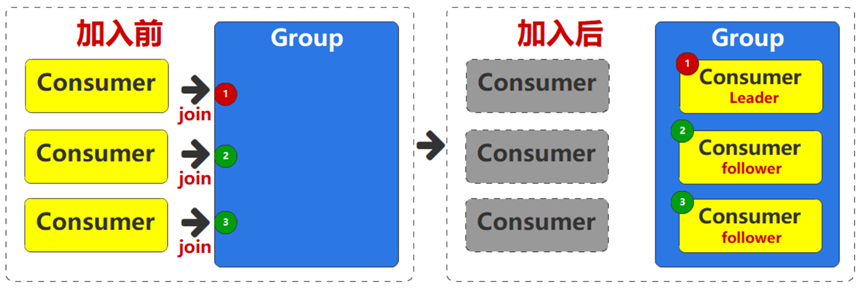
(4)当消费者加入群组的时候,会发送一个 请求。群主负责给每一个消费者分配分区。每个消费者只知道自己的分配信息,只有群主知道群组内所有消费者的分配信息。指定分配策略的基本流程如下:
(5)Kafka 提供的分区分配策略常用的有 4 个:
轮询策略中会将每个消费者按照 进行排序,所有消费者消费的主题分区根据主题名称进行排序。
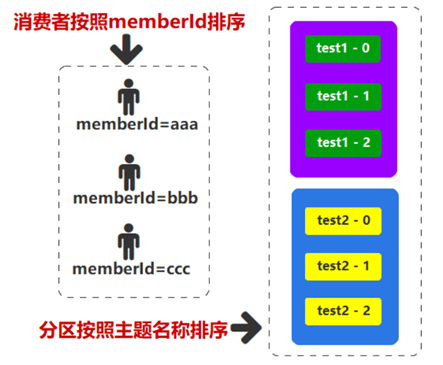
将主题分区轮询分配给对应的订阅用户,注意未订阅当前轮询主题的消费者会跳过。
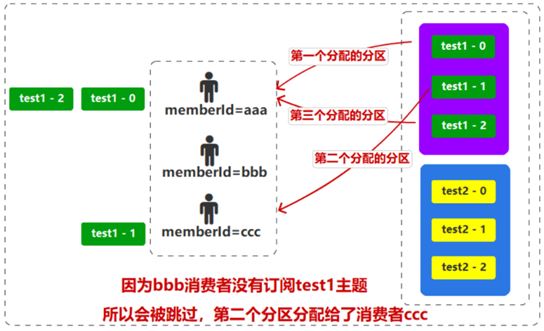
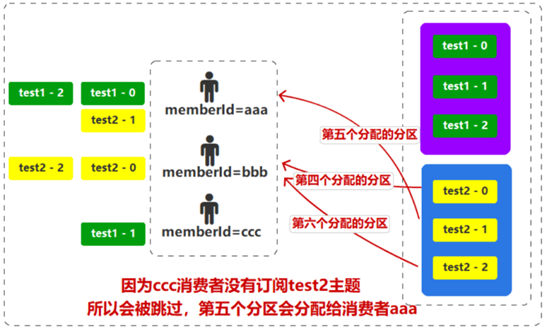
从图中可以看出,轮询分配策略是存在缺点的,并不是那么的均衡,如果 test1-2 分区能够分配给消费者 ccc 是不是就完美了。
所谓按顺序向前补齐就是:
假设【1,2,3,4,5】5个分区分给2个消费者:
5 / 2 = 2, 5 % 2 = 1 => 剩余的一个补在第一个中[2+1][2] => 结果为[1,2,3][4,5]
假设【1,2,3,4,5】5个分区分到3个消费者:
5 / 3 = 1, 5 % 3 = 2 => 剩余的两个补在第一个和第二个中[1+1][1+1][1] => 结果为[1,2][3,4][5]
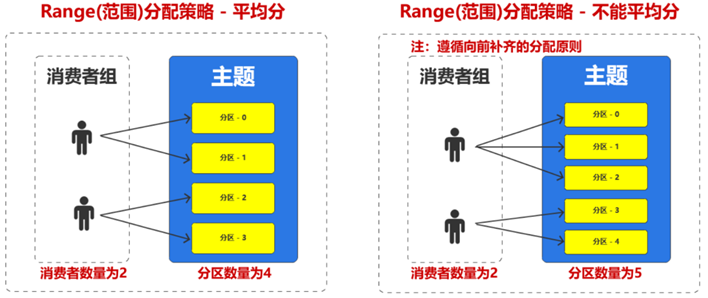
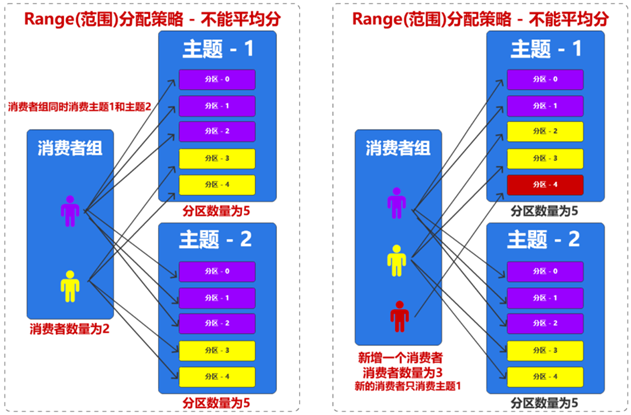
缺点:范围分配策略针对单个 Topic 的情况下显得比较均衡,但是假如 Topic 多的话, 排序靠前的可能会比 排序靠后的负载多很多。是不是也不够理想。
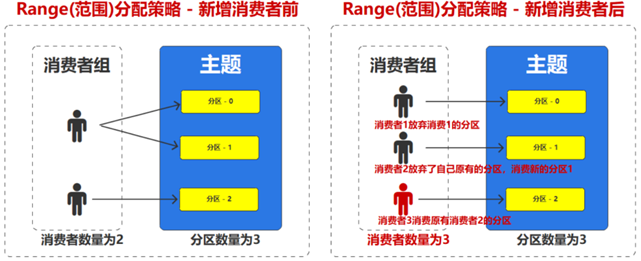
还有就是如果新增或移除消费者成员,那么会导致每个消费者都需要去建立新的分区节点的连接,更新本地的分区缓存,效率比较低。
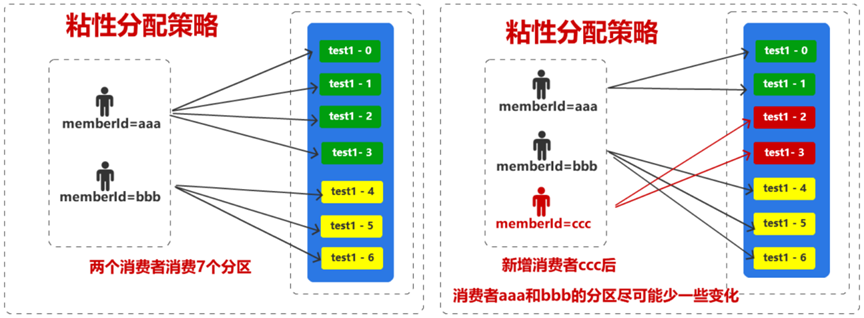
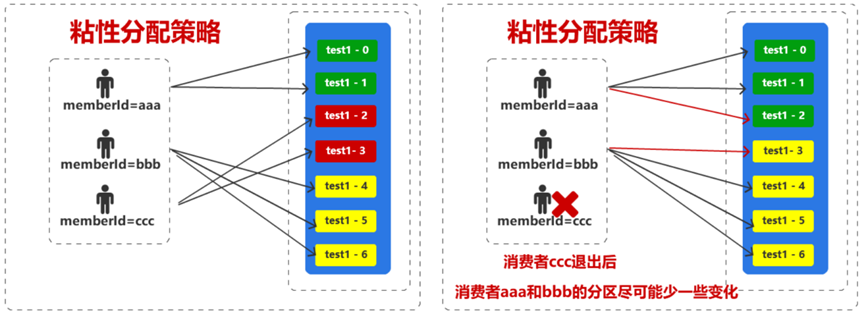
从图中可以看出,粘性分区分配策略分配的会更加均匀和高效一些。
Kafka 3.0+ 消费者默认的分区分配就是 、ignor
//设置分区分配策略
configMap.put(ConsumerConfig.PARTITION_ASSIGNMENT_STRATEGY_CONFIG, RoundRobinAssignor.class.getName());
2.6.3.4.偏移量
偏移量 是消费者消费数据的一个非常重要的属性。默认情况下,消费者如果不指定消费主题数据的偏移量,那么消费者启动消费时,无论当前主题之前存储了多少历史数据,消费者只能从连接成功后当前主题最新的数据偏移位置读取,而无法读取之前的任何数据,如果想要获取之前的数据,就需要设定配置参数或指定数据偏移量。
2.6.3.4.1.起始偏移量
在消费者的配置中,我们可以增加偏移量相关参数 auto..reset,用于从最开始获取主题数据,
configMap.put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, "earliest");
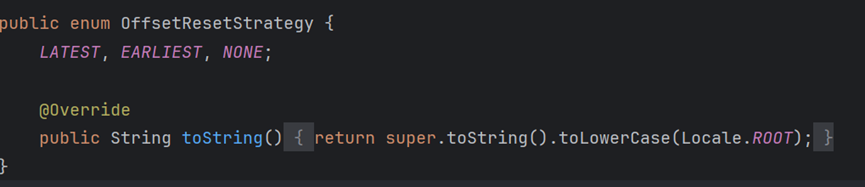
参数取值有 3 个:
2.6.3.4.2.指定偏移量消费
除了从最开始的偏移量或最后的偏移量读取数据以外,Kafka 还支持从指定的偏移量的位置开始消费数据。
package com.atguigu.kafka.consumer;
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.common.TopicPartition;
import org.apache.kafka.common.serialization.StringDeserializer;
import java.time.Duration;
import java.util.Collections;
import java.util.HashMap;
import java.util.Map;
import java.util.Set;
public class KafkaConsumerOffsetTest {
    public static void main(String[] args) {
        //配置属性集合
        Map<String, Object> configMap = new HashMap<String, Object>();
        //配置属性:Kafka 集群地址
        configMap.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        //配置属性: Kafka 传输的数据为KV对,所以需要对获取的数据分别进行反序列化
        configMap.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        configMap.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        //配置属性: 消费者组
        configMap.put(ConsumerConfig.GROUP_ID_CONFIG, "atguigu1");
        KafkaConsumer<String, String> consumer = new KafkaConsumer<>(configMap);
        //订阅主题
        String topic = "test";
        consumer.subscribe(Collections.singletonList(topic));
        //拉取数据,获取基本集群信息
        consumer.poll(Duration.ofMillis(100));
        //根据集群的基本信息配置需要消费的主题及偏移量
        final Set<TopicPartition> assignment = consumer.assignment();
        for (TopicPartition topicPartition : assignment) {
            if (topic.equals(topicPartition.topic()) ) {
                //偏移量设置为 2
                consumer.seek(topicPartition, 2);
            }
        }
        //消费者订阅指定主题的数据
        consumer.subscribe(Collections.singletonList("test"));
        while (true) {
            //每隔 100 毫秒,抓取一次数据
            ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
            //打印抓取的数据
            for (ConsumerRecord<String, String> record : records) {
                System.out.println(record);
            }
        }
    }
}
2.6.3.4.4.偏移量提交
(1)生产环境中,消费者可能因为某些原因或故障重新启动消费,那么如果不知道之前消费数据的位置,重启后再消费,就可能重复消费或漏消费。所以 Kafka 提供了保存消费者偏移量的功能,而这个功能需要由消费者进行提交操作。这样消费者重启后就可以根据之前提交的偏移量进行消费了。注意,一旦消费者提交了偏移量,那么 Kafka 会优先使用提交的偏移量进行消费。此时,auto..reset 参数是不起作用的。
(2)自动提交:所谓的自动提交就是消费者消费完数据后,无需告知 Kafka 当前消费数据的偏移量,而是由消费者客户端 API 周期性地将消费的偏移量提交到 Kafka 中。这个周期默认为 ,可以通过配置 mit..ms 进行修改。
//启用自动提交消费者偏移量,默认值为 true
configMap.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, true);
//设置自动提交偏移量的时间周期为 1000ms,默认为 5000ms
configMap.put(ConsumerConfig.AUTO_COMMIT_INTERVAL_MS_CONFIG, 1000);
(3)手动提交:基于时间周期的偏移量提交,是我们无法控制的,一旦参数设置的不合理,或单位时间内数据量消费的很多,却没有来及的自动提交,那么数据就会重复消费。所以 Kafka 也支持消费偏移量的手动提交,也就是说当消费者消费完数据后,自行通过 API 进行提交。不过为了考虑效率和安全,Kafka 同时提供了异步提交和同步提交两种方式供我们选择。注意需要禁用自动提交 auto..reset=false,才能开启手动提交。
configMap.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, false);
//...
while (true) {
    //每隔 100 毫秒,抓取一次数据
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
    //打印抓取的数据
    for (ConsumerRecord<String, String> record : records) {
        System.out.println(record);
    }
    //手动保存偏移量
    consumer.commitAsync();     //异步提交
    //consumer.commitSync();      //同步提交
}
2.6.3.5.消费者事务
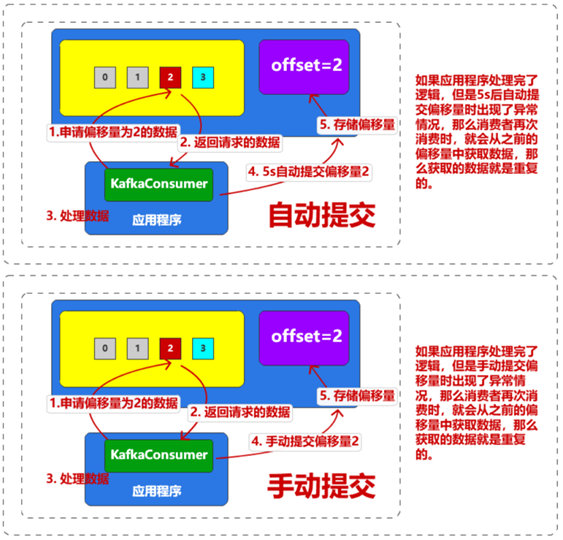
(1)无论偏移量使用自动提交还是,手动提交,特殊场景中数据都有可能会出现重复消费。
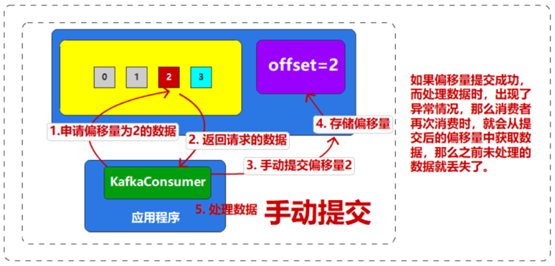
如果提前提交偏移量,再处理业务,又可能出现数据丢失的情况。
(2)对于单独的消费者来讲,事务保证会比较弱,尤其是无法保证提交的信息被精确消费,主要原因就是消费者可以通过偏移量访问信息,而不同的数据文件生命周期不同,同一事务的信息可能会因为重启导致被删除的情况。所以一般情况下,想要完成 Kafka 消费者端的事务处理,需要将数据消费过程和偏移量提交过程进行原子性绑定,也就是说数据处理完了,必须要保证偏移量正确提交,才可以做下一步的操作,如果偏移量提交失败,那么数据就恢复成处理之前的效果。
(3)对于生产者事务而言,消费者消费的数据也会受到限制。默认情况下,消费者只能消费到生产者提交的数据,也就是未提交完成的数据,消费者是看不到的。如果想要消费到未提交的数据,需要更高消费事务隔离级别。
//隔离级别:已提交读,读取已经提交事务成功的数据(默认)
paramMap.put(ConsumerConfig.ISOLATION_LEVEL_CONFIG, "read_committed");
//隔离级别:未提交读,读取已经提交事务成功和未提交事务成功的数据
paramMap.put(ConsumerConfig.ISOLATION_LEVEL_CONFIG, "read_uncommitted");
2.6.3.6.偏移量的保存
(1)由于消费者在消费消息的时候可能会由于各种原因而断开消费kafka java,当重新启动消费者时我们需要让它接着上次消费的位置 继续消费,因此消费者需要实时的记录自己以及消费的位置。
(2)Kafka 0.90 版本之前,这个信息是记录在 内的,在 0.90 之后的版本, 保存在 这个主题内。
每个 会定期将自己消费分区的 提交给 Kafka 内部主题 ,提交过去的时候,key 是+topic+分区号。value 就是当前 的值,Kafka 会定期清理主题里的消息,最后就保留最新的那条数据。
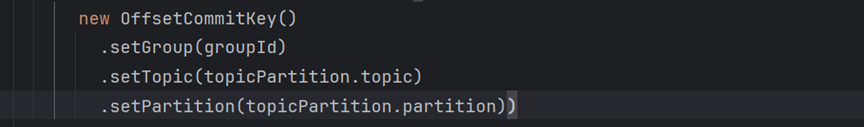
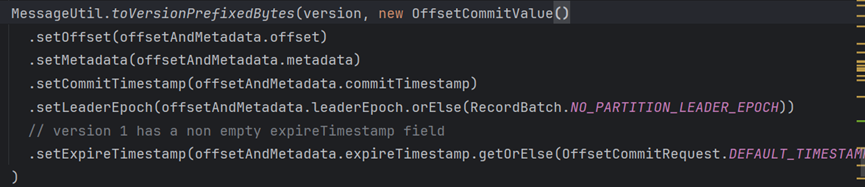
(3)因为主题 可能会接收高并发的请求,Kafka 默认给其分配 50 个分区(可以通过 ic.num. 设置),均匀分配到 Kafka 集群的多个 中。Kafka 采用 hash() % 主题的分区数来计算我们的偏移量提交到哪一个分区。因为偏移量也是保存到主题中的,所以保存的过程和生产者生产数据的过程基本相同。
2.6.3.7.消费数据
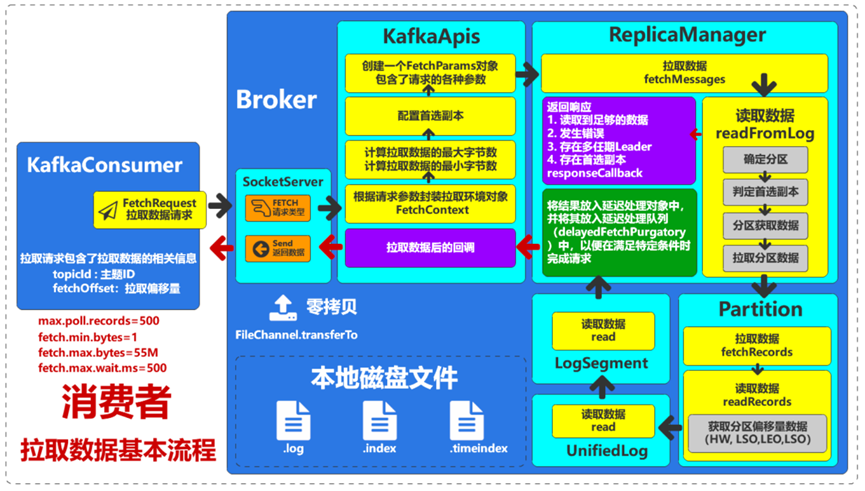
消费者消费数据时,一般情况下,只是设定了订阅的主题名称,那是如何消费到数据的呢?这里说一下服务端拉取数据的基本流程。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » kafka java Kafka——入门与基础

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码