双旋网络
kafka java Java的ApacheKafka实战

kafka java Java的ApacheKafka实战
1.背景介绍1. 背景介绍
Kafka 是一个开源的流处理平台,用于构建实时数据流管道和流处理应用程序。它可以处理高吞吐量的数据,并在分布式环境中提供可靠的数据传输。Kafka 通常用于日志追踪、实时数据分析、消息队列等应用场景。
Java 是 Kafka 的主要编程语言,许多开发者使用 Java 编写 Kafka 应用程序。在本文中,我们将探讨如何使用 Java 编程语言与 Kafka 实现实际项目。我们将涵盖 Kafka 的核心概念、算法原理、最佳实践以及实际应用场景。
2. 核心概念与联系
在本节中,我们将介绍 Kafka 的核心概念,包括生产者、消费者、主题和分区等。
2.1 生产者
生产者是将数据发送到 Kafka 集群的客户端应用程序。生产者负责将数据从应用程序发送到 Kafka 主题,并确保数据可靠地到达目的地。生产者可以使用 Kafka 提供的客户端库(如 Java 的 Kafka 客户端库)来实现这一功能。
2.2 消费者
消费者是从 Kafka 集群中读取数据的客户端应用程序。消费者从 Kafka 主题中读取数据,并将数据处理并存储到持久化存储中。消费者可以使用 Kafka 提供的客户端库(如 Java 的 Kafka 客户端库)来实现这一功能。
2.3 主题
主题是 Kafka 集群中的一个逻辑分区,用于存储生产者发送的数据。主题可以包含多个分区,每个分区可以包含多个消息。主题是 Kafka 中数据流的基本单位kafka java,生产者将数据发送到主题,消费者从主题中读取数据。
2.4 分区
分区是 Kafka 主题的基本单位,用于存储主题中的数据。每个分区可以包含多个消息,并且可以在 Kafka 集群中的多个节点上存储。分区可以提高 Kafka 的吞吐量和可用性,因为多个分区可以同时处理数据。
3. 核心算法原理和具体操作步骤以及数学模型公式详细讲解
在本节中,我们将详细讲解 Kafka 的核心算法原理,包括生产者和消费者的数据传输过程以及数据分区和负载均衡等。
3.1 生产者数据传输过程
生产者将数据发送到 Kafka 主题的过程可以分为以下步骤:
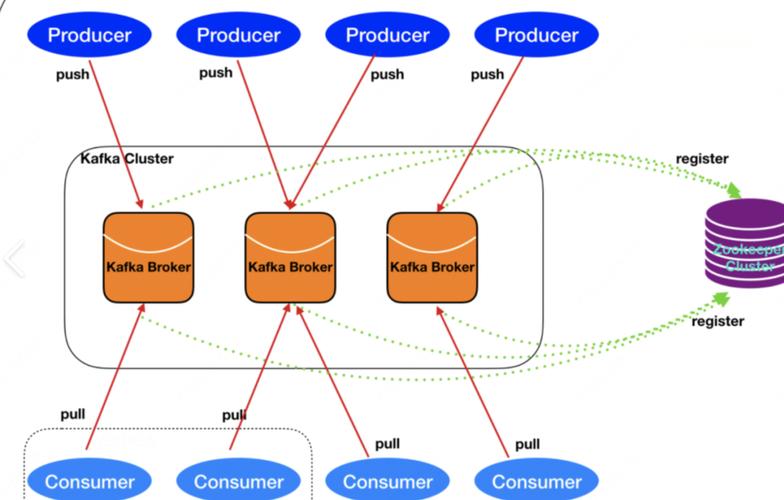
生产者将数据发送到本地缓存中。生产者将本地缓存中的数据分成多个分区。生产者将数据发送到 Kafka 集群中的各个分区。生产者确认数据已经成功发送到 Kafka 集群。3.2 消费者数据传输过程
消费者从 Kafka 主题读取数据的过程可以分为以下步骤:
消费者从 Kafka 主题中读取数据。消费者将数据发送到本地缓存中。消费者将数据处理并存储到持久化存储中。3.3 数据分区和负载均衡
Kafka 使用分区来实现数据分布和负载均衡。每个分区可以存储主题中的数据,并可以在 Kafka 集群中的多个节点上存储。通过将数据分成多个分区,Kafka 可以实现高吞吐量和可用性。
4. 具体最佳实践:代码实例和详细解释说明
在本节中,我们将通过一个具体的代码实例来展示如何使用 Java 编程语言与 Kafka 实现一个简单的数据流管道。
4.1 生产者示例
“` org..kafka…; org..kafka…; org..kafka…;
java.util.;
class { void main( args) { props = new ();props.put(“.”, “:9092”);props.put(“key.”, “mon..”);props.put(“value.”, “mon..”);
Producer producer = new KafkaProducer(props);
    for (int i = 0; i < 10; i++) {
        producer.send(new ProducerRecord("test-topic", Integer.toString(i), "message" + i));
    }
    producer.close();
}
}“`
4.2 消费者示例
“` org..kafka…; org..kafka…; org..kafka…;
java.util.; java.util.;
class { void main( args) { props = new ();props.put(“.”, “:9092”);props.put(“group.id”, “test-group”);props.put(“key.”, “mon..”);props.put(“value.”, “mon..”);
Consumer consumer = new KafkaConsumer(props);
    consumer.subscribe(Collections.singletonList("test-topic"));
    while (true) {
        ConsumerRecords records = consumer.poll(100);
        for (ConsumerRecord record : records) {
            System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value());
        }
    }
}
}“`在这个示例中,我们创建了一个生产者和一个消费者,生产者将数据发送到主题,消费者从主题中读取数据并打印到控制台。
5. 实际应用场景
Kafka 可以用于以下实际应用场景:
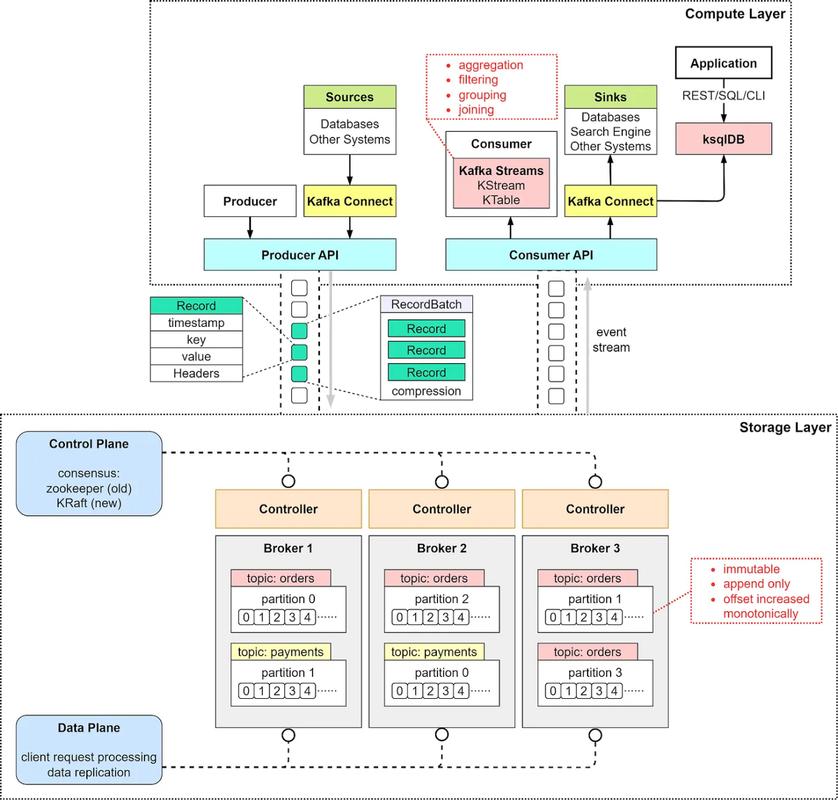
日志聚合和分析:Kafka 可以用于收集和处理来自多个来源的日志数据,并实现实时日志分析。实时数据流处理:Kafka 可以用于构建实时数据流处理系统,实现实时数据处理和分析。消息队列:Kafka 可以用于实现消息队列,实现异步消息传输和可靠消息处理。流处理应用:Kafka 可以用于实现流处理应用,如实时推荐系统、实时监控和报警等。6. 工具和资源推荐
在本节中,我们将推荐一些有用的 Kafka 工具和资源kafka java Java的ApacheKafka实战,可以帮助您更好地学习和使用 Kafka。
7. 总结:未来发展趋势与挑战
在本节中,我们将总结 Kafka 的未来发展趋势和挑战。
Kafka 已经成为一个广泛使用的流处理平台,它在日志聚合、实时数据流处理、消息队列等应用场景中表现出色。未来,Kafka 可能会继续发展,涉及到更多的应用场景和技术领域。
然而,Kafka 也面临着一些挑战。例如,Kafka 的性能和可用性需要不断优化,以满足更高的性能要求。同时,Kafka 需要更好地支持多语言和多平台,以便更广泛地应用。
8. 附录:常见问题与解答
在本节中kafka java,我们将回答一些常见的 Kafka 问题。
8.1 如何选择合适的分区数?
选择合适的分区数是非常重要的kafka java Java的ApacheKafka实战,因为分区数会影响 Kafka 的性能和可用性。一般来说,可以根据以下因素来选择合适的分区数:
数据吞吐量:如果需要更高的吞吐量,可以增加分区数。可用性:增加分区数可以提高 Kafka 的可用性,因为分区之间是相互独立的。存储空间:每个分区都需要一定的存储空间,因此需要考虑存储空间的限制。8.2 如何选择合适的复制因子?
复制因子是指每个分区的副本数。复制因子可以提高 Kafka 的可用性,因为副本之间是相互独立的。一般来说,可以根据以下因素来选择合适的复制因子:
可用性:增加复制因子可以提高 Kafka 的可用性kafka java,因为副本之间是相互独立的。性能:增加复制因子可能会影响 Kafka 的性能,因为需要同步多个副本。存储空间:每个副本都需要一定的存储空间,因此需要考虑存储空间的限制。8.3 如何优化 Kafka 性能?
优化 Kafka 性能是一个重要的任务,可以提高 Kafka 的吞吐量和可用性。以下是一些建议:
增加分区数:增加分区数可以提高 Kafka 的吞吐量和可用性。增加副本数:增加副本数可以提高 Kafka 的可用性,因为副本之间是相互独立的。优化配置参数:可以根据实际情况调整 Kafka 的配置参数,例如调整网络缓冲区大小、日志文件大小等。使用更快的磁盘:使用更快的磁盘可以提高 Kafka 的性能,因为磁盘 I/O 是 Kafka 性能的一个关键因素。9. 参考文献
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » kafka java Java的ApacheKafka实战

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码