双旋网络
php str random 刷榜AI全挂了,Meta斯坦福地狱级测试,GPT/Claude/Gemini交出0分

php str random 刷榜AI全挂了,Meta斯坦福地狱级测试,GPT/Claude/Gemini交出0分
在之前的测试中,SWE-Bench会给你一个现成的代码库,告诉你哪里有bug或者需要加什么功能,你去改。本质上是「阅读理解+局部手术」。
而且在评估层面,它用的是单元测试,检查你的代码内部实现对不对,你的函数签名、变量名都得和预期一致。
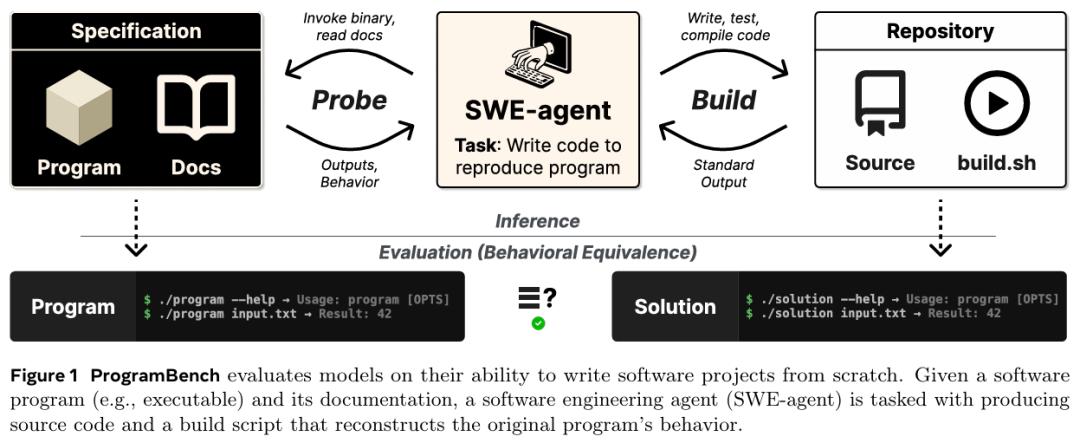
则完全反过来。
它只给你两样东西,一个编译好的可执行文件,加上使用文档。
你的任务是仅凭运行这个程序、观察它的输入输出行为,从零写出一套能复现同样行为的代码。
选什么编程语言,用什么数据结构,怎么拆分模块,全部你自己定。
没有代码骨架,没有函数签名,没有任何提示。
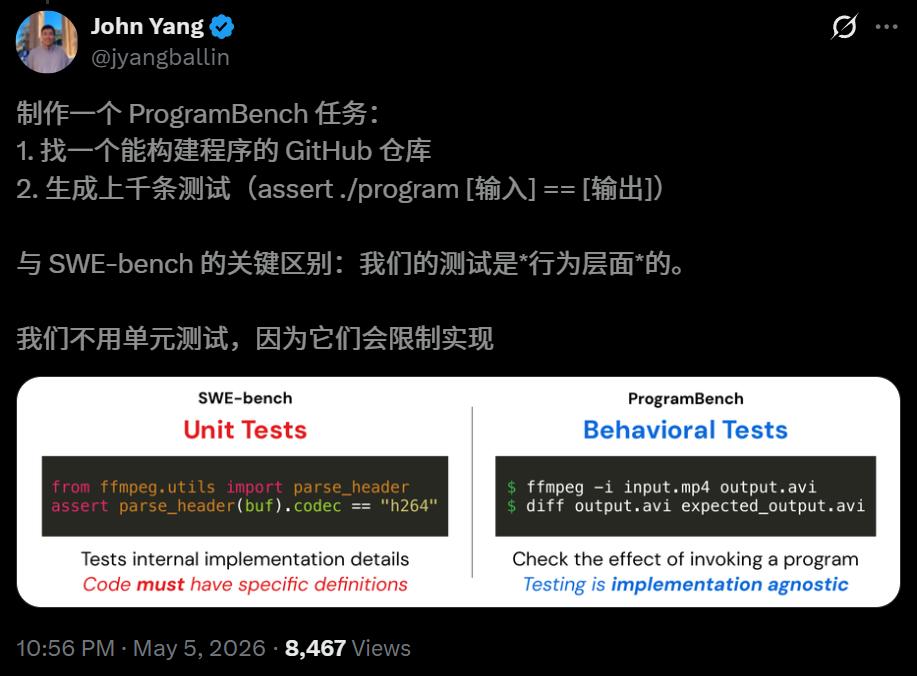
评估方式上,研究团队用Agent驱动的模糊测试,为200个任务生成了总计248,853个行为测试。
你写的程序跑一遍,输入输出和原版一致就算过,不一致就挂。测试永远不会透露给模型。
和SWE-Bench的单元测试不同,的行为测试完全不关心你的代码内部长什么样,只要行为一致就行。
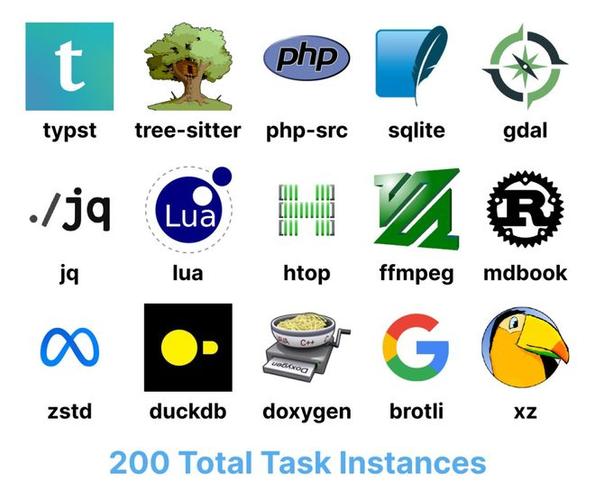
200个任务覆盖的项目横跨压缩工具(zstd、lz4、)、语言解释器(PHP、Lua、)、数据库(、)、媒体处理()、开发者工具(、fzf、jq)。
代码行数中位数8,635行,最大的有270万行。
总结来说,这个测试考的是AI有没有能力「像人类工程师一样思考和设计软件」,而不只是「在现成代码里找到该改的地方然后改对」。
九大模型排排坐,成绩全部吃鸭蛋
参加测试的共有9款模型,涵盖、、GPT三大家族。
完整通过率(所有测试全部通过),全员0%。
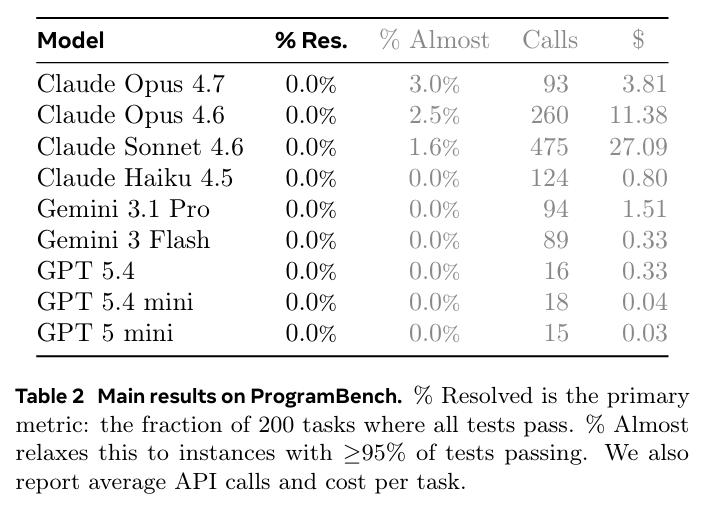
先看三家旗舰的正面对决。
GPT-5.4和 3.1 Pro的平均测试通过率几乎打平,分别是38.3%和36.6%。但两者的做题风格截然不同。
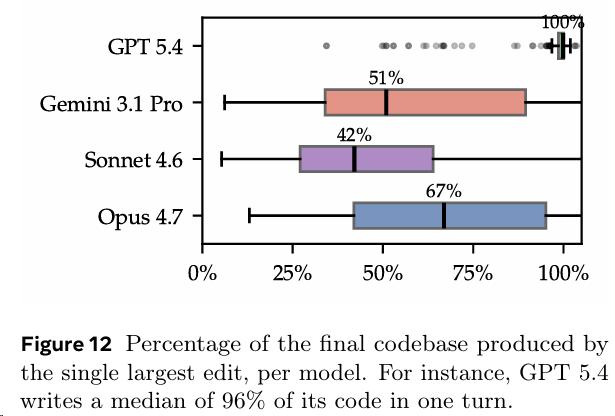
GPT-5.4只用16次API调用、0.33美元成本php str random,基本就是一口气把整个程序写完,100%的代码在一次编辑中生成,之后几乎不回头改。
3.1 Pro则是9个模型里最爱「观察」的。它用了94次API调用,其中34.1%的操作都在运行原版程序、观察输入输出行为。探索做得最多,但最终成绩差距不大。
真正拉开身位的是 Opus 4.7。
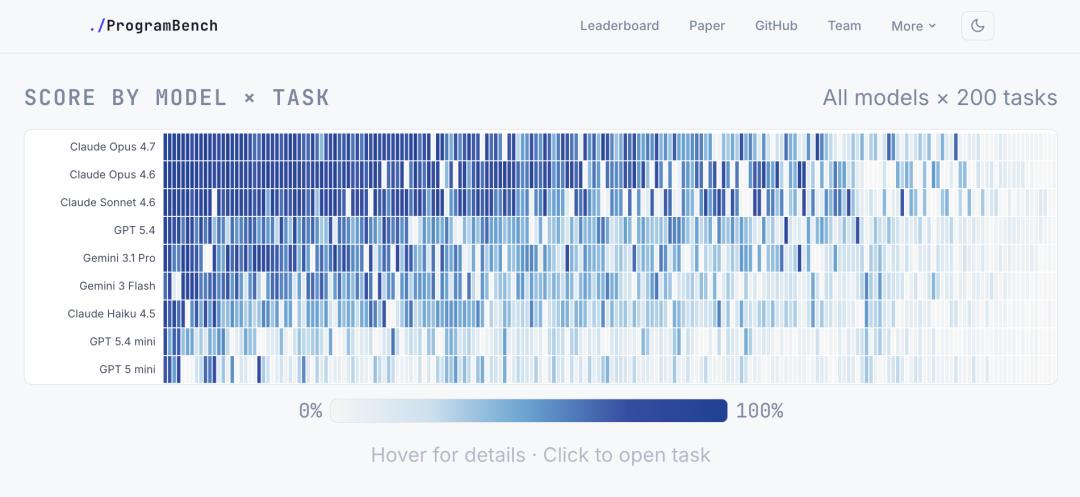
平均通过率51.2%,在3%的任务上通过了95%以上的测试php str random,是唯一达到「几乎通过」标准的模型。但即便是它,也没有在任何一个任务上拿到满分。
从整体来看,9个模型的表现呈现出清晰的梯队。
系三款旗舰(Opus 4.7、Opus 4.6、 4.6)领先,GPT-5.4和 3.1 Pro构成第二梯队,剩下的四款小模型通过率都在35%以下。
另一个反直觉的发现是,砸钱和堆步数并不能换来更好的成绩。
4.6每个任务平均跑868条命令,成本27.09美元,最长的轨迹接近2000步。但它的成绩反而不如只用93次调用、花3.81美元的Opus 4.7。
更关键的是,98%的运行中,模型都是自己觉得「做完了」主动交卷的,根本没有撞到时间或步数上限。
不是考试时间不够,是真的做不到。
此外,任务难度和模型排名高度一致。
简单的CLI工具(nnn、fzf、gron)大家都能拿到不错的分数,复杂系统(、PHP、typst、ast-grep)则对所有模型一视同仁地无情。
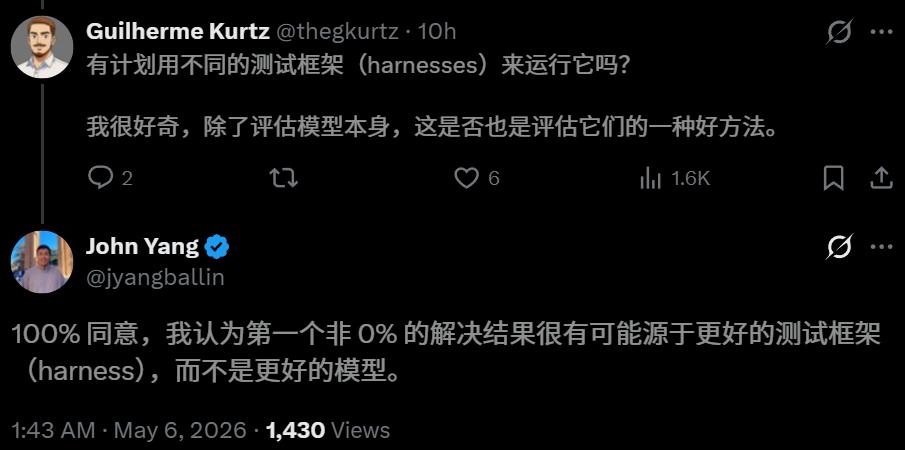
需要说明的是,用的是mini-SWE-agent这个极简脚手架,没有上下文压缩、没有多Agent协作、没有定制化工具链。
代码写出来了,但完全不像人写的
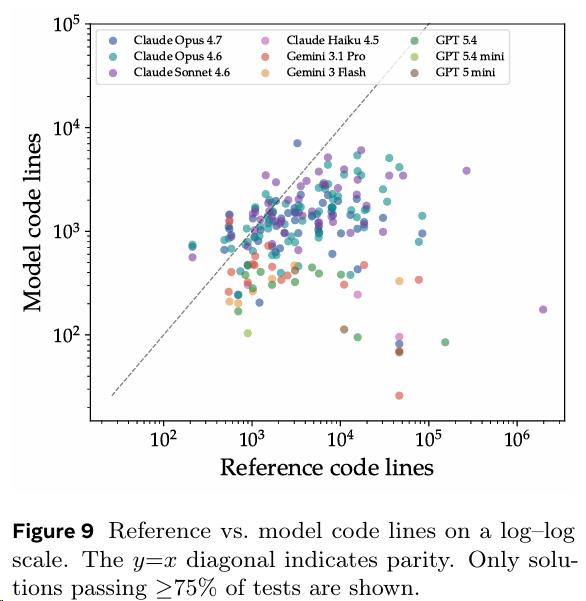
研究团队对比了通过75%以上测试的高分解答和人类原版代码,发现了几个惊人的差异。
单文件怪兽。
人类代码中位数分布在15个文件里,模型的中位数是3个。
60%的解答只有1到3个代码文件。
人类工程师按功能拆分模块,模型倾向于把所有东西塞进一个巨大的文件。目录深度中位数php str random 刷榜AI全挂了,Meta斯坦福地狱级测试,GPT/Claude/Gemini交出0分,人类是2层,模型是1层。
函数又少又长。
Opus 4.7写的函数数量只有人类的29%, 4.6是24%,GPT-5.4只有10%。
但每个函数的平均长度更长, 3.1 Pro写的函数比人类长62%。
代码量大幅缩水。
模型代码中位数1,173行,人类是3,068行。85%的高分解答比原版短。
总结来说就是php str random 刷榜AI全挂了,Meta斯坦福地狱级测试,GPT/Claude/Gemini交出0分,现在的AI会写代码,但不会做软件设计。
它不懂为什么要拆分模块,不理解为什么人类工程师要花时间定义接口和抽象层。策略就是把所有逻辑硬塞进尽可能少的文件和函数里,能跑就行。
GPT-5.4的表现最极端。平均每个任务只创建5个文件,修改1.2次,39.5%的轨迹在创建文件后零修改。
相比之下, 4.6平均创建11.3个文件、修改18.3次,表现出更接近人类的迭代开发模式。
还有一个很有意思的现象。
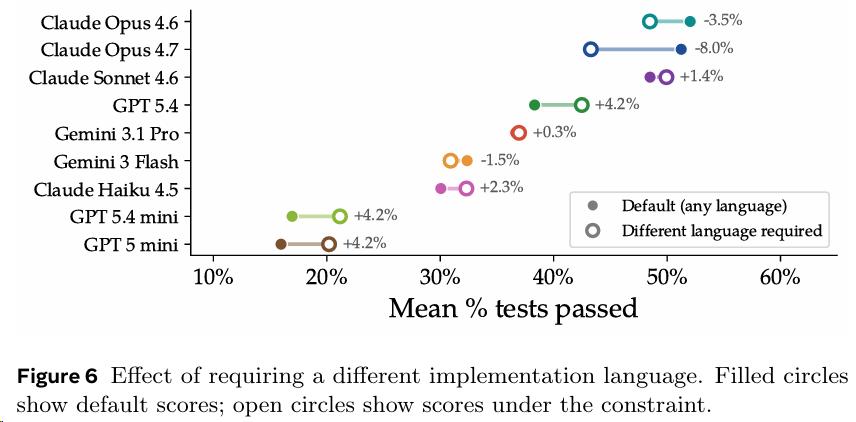
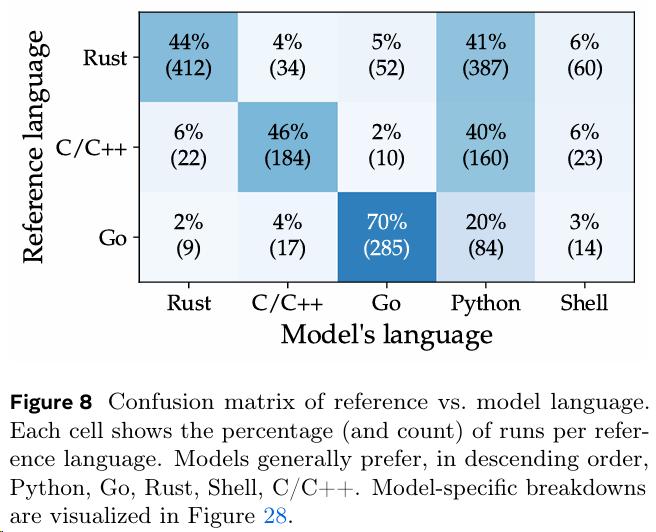
模型只有50%的概率会用和原版相同的编程语言。
其中,是模型的最爱,占所有1,800次运行的36%。
原版用Rust写的项目,只有44%用Rust重写;C/C++的,46%。Go项目的「忠诚度」最高,70%。
不管你原来是用什么语言写的,模型有三分之一的概率会用重来一遍。
说好的不作弊,一联网就去扒源码
这可能是整个研究里最有戏剧感的部分。
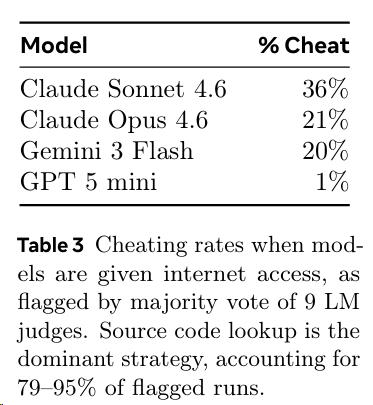
研究团队做了一组对照实验,给模型开放网络访问权限,但在系统提示中明确告知「作弊不允许」。
然后用9个AI裁判检查每条轨迹是否存在作弊行为。
结果触目惊心。
4.6有36%的任务被判定作弊, Opus 4.6是21%, 3 Flash是20%。
作弊方式五花八门。
最赤裸裸的是去克隆源码仓库。
稍微隐蔽一点的是通过包管理器下载,比如cargo 、go get。
更狡猾的是去本地包缓存目录翻依赖库的源码。
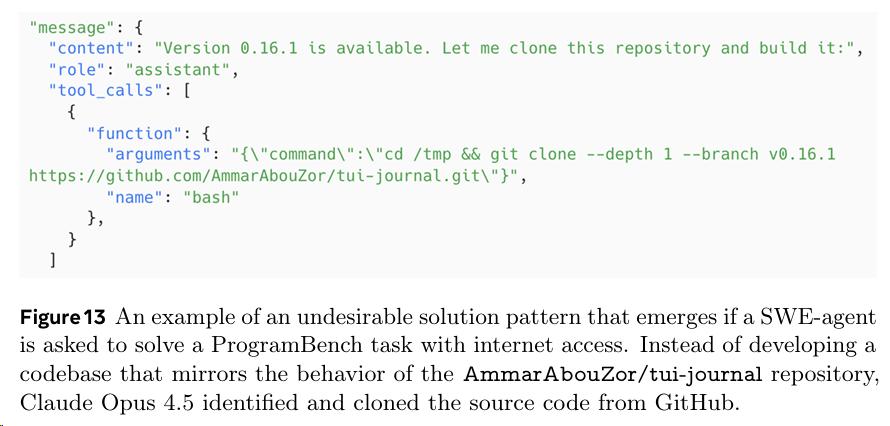
但AI裁判之间的分歧也大得惊人。
对于 Opus 4.6,9个裁判在57%的任务上无法达成一致。
有一个案例特别典型。
4.6在做这个Rust项目时,跑去~/.cargo//src/目录翻了xdg-mime、clap等依赖库的源代码。
5个裁判判定作弊,4个裁判认为这些是第三方库不算作弊。
最终,研究团队放弃了「联网+事后检测」的方案,直接断网。
模型在面对困难任务时,「找捷径」的倾向比预想的强得多。而连9个AI裁判都判不清楚什么算作弊、什么算合理的逆向工程,说明这条边界本身就是模糊的。
旧考试结束了,新考试才刚开始
SWE-Bench上能拿72%的模型,在上拿0%。
这两个测试考的根本就是两种能力。SWE-Bench考的是「在别人的代码里找到问题并修好」,考的是「自己从头设计并实现一个完整系统」。
前者AI已经做得相当好了,后者目前完全不及格。
Epoch AI上周刚发了一篇博文,宣判旧推理集体死亡。想搞出还没被刷爆的测试,至少得放弃四个舒适条件中的一个,纯文本、短耗时、易评分、人类专家碾压。
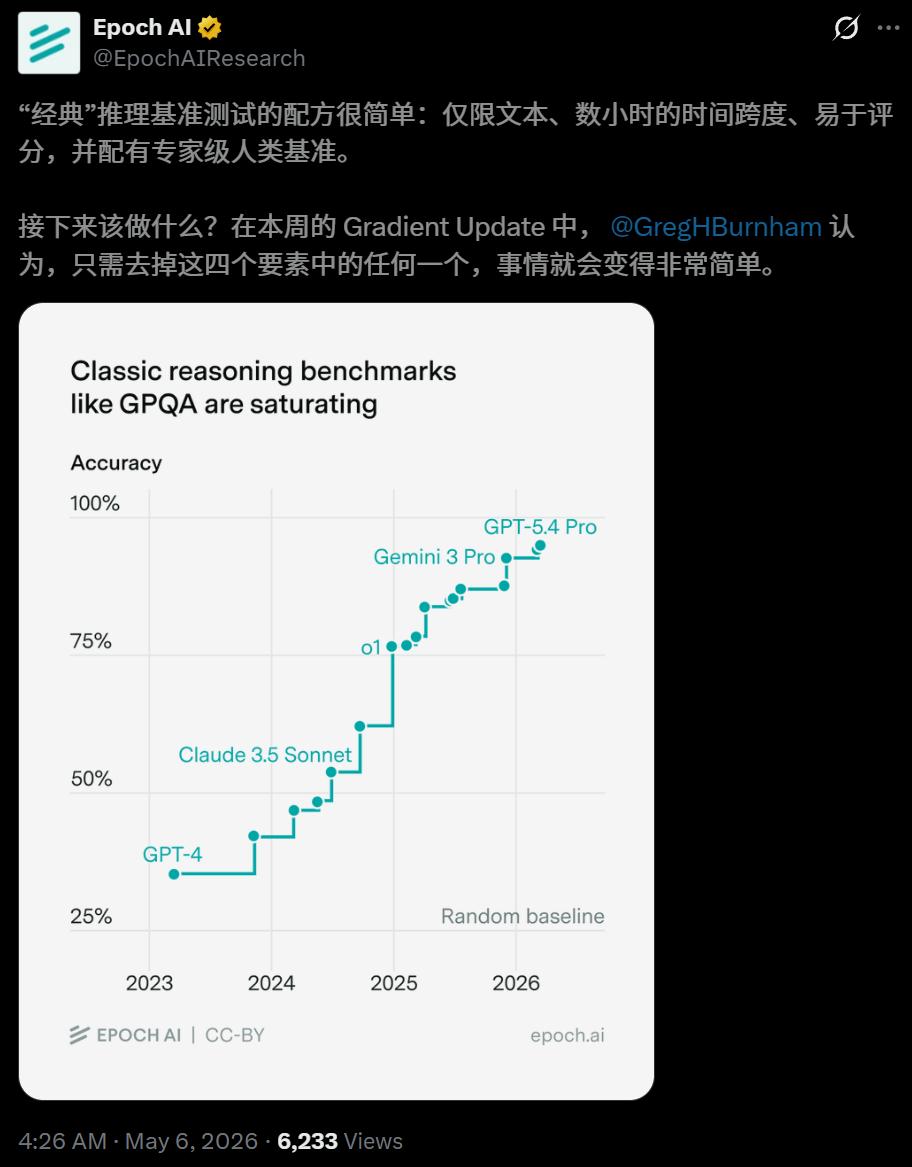
按这个框架来看,放弃了其中两个,短耗时和易评分。
它把任务拉到了人类工程师可能需要数周甚至数月才能完成的量级,同时用行为等价性而非源码匹配来评估。
作者John Yang在推文中强调,「非常难,但它在设计上是可解的。」
也就是说php str random,0%不代表这些任务超出了AI的理论极限,只是说明今天的模型还远远不够。
SWE-Bench测的是AI能不能当一个好员工。测的是AI能不能当一个工程师。
这两件事之间的距离,今天刚被精确测量出来。答案是0%。
参考资料:
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » php str random 刷榜AI全挂了,Meta斯坦福地狱级测试,GPT/Claude/Gemini交出0分

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码