双旋网络
php require_once 10分钟入门Flink—了解Flink

php require_once 10分钟入门Flink—了解Flink
1、友情提示
前期入门Flink时,可以直接编写通过idea编写Flink程序,然后直接运行main方法,无需搭建环境。我碰到许多初次接触Flink的同学,被各种环境搭建、提交作业、复杂概念给劝退了。前期最好的入门方式就是直接上手写代码,main方法跑demo,快速了解概念,等入门之后再去实践集群环境、各种作业提交、各种复杂概念。接下来正式进入主题。
2、大白话
说白了,Flink就是个实时处理数据任务的框架,这个框架帮助开发者执行数据处理的任务,让开发者无需关心高可用、性能等问题。如果你有一些数据任务需要执行,比如数据监控、数据分析、数据同步,那就可以考虑使用Flink。所谓流计算就是对源源不断的数据进行计算,中间的计算结果存放在内存或者外部存储,这就是有状态的流计算。
3、示例代码
通过2段简单的代码,也能清晰的看到Flink已经做到了流批统一,同样的功能,使用同样的API和算子,大大减少开发者的工作量。
本文示例采用的Flink版本是15.4php require_once,代码地址:
3.1、词频统计-批数据
// 1. 创建执行环境
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
// 2. 读取数据源
DataStream textStream = env.fromCollection(Arrays.asList(
        "java,c++,php,java,spring",
        "hadoop,scala",
        "c++,jvm,html,php"
));
// 3. 数据转换
DataStream<Tuple2> wordCountStream = textStream
        // 对数据源的单词进行拆分,每个单词记为1,然后通过out.collect将数据发射到下游算子
        .flatMap(new FlatMapFunction<String, Tuple2>() {
                     @Override
                     public void flatMap(String value, Collector<Tuple2> out) throws Exception {
                         for (String word : value.split(",")) {
                             out.collect(new Tuple2(word, 1));
                         }
                     }
                 }
        )
        // 对单词进行分组
        .keyBy(value -> value.f0)
        // 对某个组里的单词的数量进行滚动相加统计
        .reduce((a, b) -> new Tuple2(a.f0, a.f1 + b.f1));
// 4. 数据输出。字节输出到控制台
wordCountStream.print("WordCountBatch========").setParallelism(1);
// 5. 启动任务
env.execute(WordCountBatch.class.getSimpleName());
3.2、词频统计-流数据
// 1. 创建执行环境
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
// 2. 读取数据源
DataStream textStream = env.socketTextStream("localhost", 9999, "n");
// 3. 数据转换
DataStream<Tuple2> wordCountStream = textStream
        // 对数据源的单词进行拆分,每个单词记为1,然后通过out.collect将数据发射到下游算子
        .flatMap(new FlatMapFunction<String, Tuple2>() {
                     @Override
                     public void flatMap(String value, Collector<Tuple2> out) throws Exception {
                         for (String word : value.split("\s")) {
                             out.collect(new Tuple2(word, 1));
                         }
                     }
                 }
        )
        // 对单词进行分组
        .keyBy(value -> value.f0)
        // 对某个组里的单词的数量进行滚动相加统计
        .reduce((a, b) -> new Tuple2(a.f0, a.f1 + b.f1));
// 4. 数据输出。字节输出到控制台
wordCountStream.print("WordCountStream=======").setParallelism(1);
// 5. 启动任务
env.execute(WordCountStream.class.getSimpleName());
4、什么是Flink
Flink是一个框架和分布式处理引擎,用于对无边界和有边界的数据流进行有状态的计算。Flink是原生的流处理系统,但也提供了批处理API,用于基于流式计算引擎处理批量数据的计算能力php require_once,真正实现了批流统一。
Flink支持有状态的计算。在流式计算过程中将算子的中间结果保存在内存或者文件系统中,等下一个事件进入算子后可以从之前的状态中获取中间结果,以便计算当前的结果,从而无需每次都基于全部的原始数据来统计结果,极大地提升了系统性能。每一个具有一定复杂度的流计算应用都是有状态的,任何运行基本业务逻辑的流处理应用都需要在一定时间内存储所接受的事件或者中间结果。
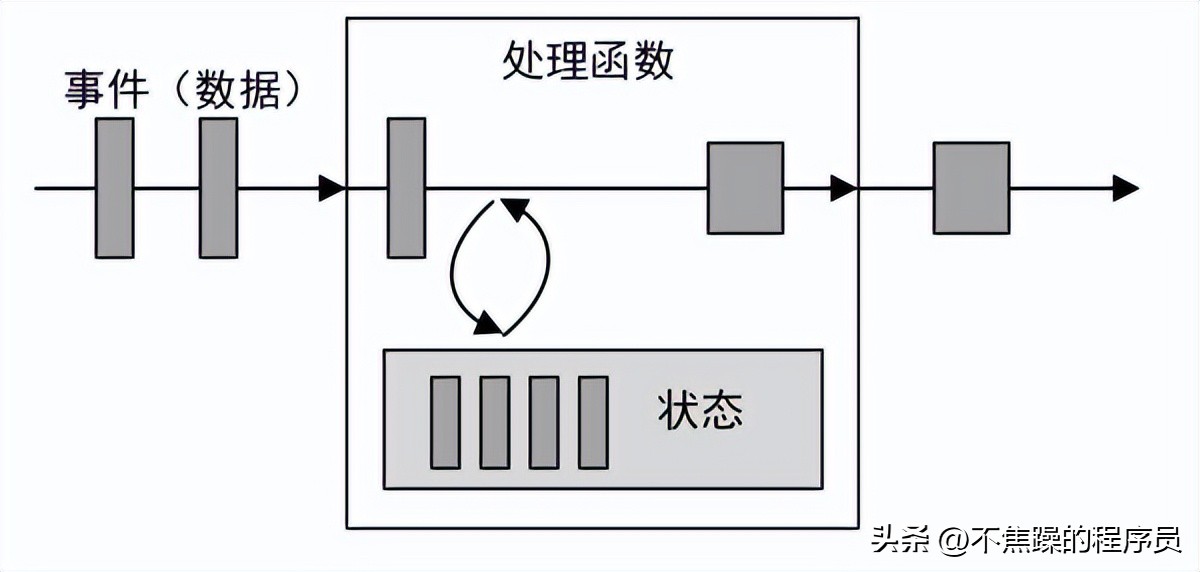
Flink支持事件时间。Flink除了支持处理时间外,还支持事件时间(Event Time),根据事件本身自带的时间戳(事件的产生时间)进行结果的计算。这种基于事件驱动的机制使得事件即使乱序到达,Flink也能够计算出精确的结果,保证了结果的准确性和一致性。
Flink支持高可用性。Flink可以实现快速故障恢复、动态扩容、7×24小时运行流式应用等作业。Flink还支持在不丢失应用状态的前提下更新作业的程序代码。Flink可以将任务执行的快照保存在存储介质上,当需要停机运维等操作时,下次启动可以直接从事先保存的快照恢复原有的计算状态,使得任务继续按照停机之前的状态运行。
Flink吞吐量高。较高的吞吐量可以提高资源利用率php require_once 10分钟入门Flink—了解Flink,减小系统开销。
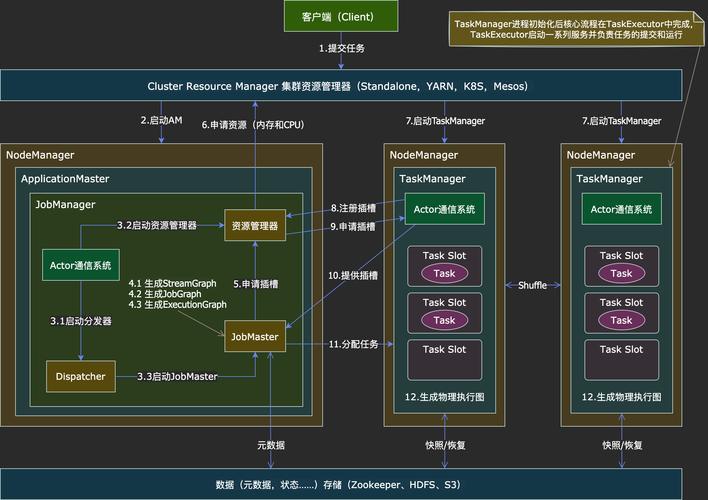
Flink容错性好。Flink的容错机制是基于分布式快照实现的,通过机制保存流处理作业某些时刻的状态,当任务异常结束时,默认从最近一次保存的完整快照处恢复任务。
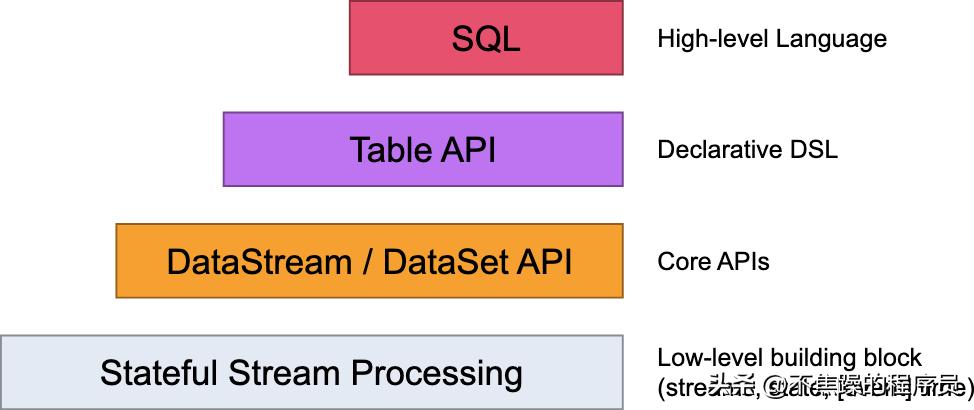
Flink提供了不同层级的API。Flink为流处理和批处理提供了不同层级的API,每一种API在简洁性和表达力上有着不同的侧重,并且针对不同的应用场景,不同层级的API降低了系统耦合度。
5、应用场景
事件驱动:根据到来的事件流触发计算、状态更新或其他外部动作。主要应用实例有反欺诈、异常检测、基于规则的报警、业务流程监控等。
数据分析:从原始数据中提取有价值的信息和指标,这些信息和指标数据可以写入外部数据库系统或以内部状态的形式维护。
数据管道:数据管道和ETL(–Load,提取-转换-加载)作业的用途相似,都可以转换、丰富数据,并将其从某个存储系统移动到另一个。与传统的ETL不同的是,传统的ETL是周期性的,而Flink是以持续流模式运行的。
6、主要组件
存储层:Flink本身并没有提供分布式文件系统,因此Flink的分析大多依赖外部存储。
调度层:Flink自带一个简易的资源调度器,称为独立调度器()。若集群中没有任何资源管理器,则可以使用自带的独立调度器。当然,Flink也支持在其他的集群管理器上运行,包括 YARN、 Mesos等。
计算层:Flink的核心是一个对由很多计算任务组成的、运行在多个工作机器或者一个计算集群上的应用进行调度、分发以及监控的计算引擎,为API工具层提供基础服务。
工具层:在Flink 的基础上,Flink提供了面向流处理( API)和批处理()的不同计算接口,并在此接口上抽象出了不同的应用类型组件库,例如基于流处理的CEP(复杂事件处理库)、Table&SQL(结构化表处理库)和基于批处理的Gelly(图计算库)、(机器学习库)、Table&SQL(结构化表处理库)。
7、Flink编程模型
Flink的编程套路是固定的,他其实就是帮助开发者去执行一些列任务,开发者无需关注性能、高可用等棘手问题。
有界数据集:定义一个数据流的开始,也定义数据流的结束,就会产生有界数据集。
批处理:有界数据集的处理通常称为批处理
无界数据集:定义一个数据流的开始,但没有定义数据流的结束,就会产生无界数据集。无界数据集会无休止地产生新数据,是没有边界的。
流处理:对无界数据集的处理被称为流处理。
有界和无界转换:有界数据集与无界数据集其实是一个相对的概念。如果每间隔一分钟、一小时、一天对数据进行一次计算php require_once,那么认为这一段时间的数据相对是有界的。有界的流数据又可以一条一条地按照顺序发送给计算引擎进行处理,在这种情况下可以认为数据是相对无界的。有界数据集与无界数据集可以相互转换。Flink正是使用这种方式将有界数据集与无界数据集进行统一处理,从而将批处理和流处理统一在一套流式引擎中,能够同时实现批处理与流处理任务。
8、Flink程序结构
构成:一个Flink应用程序由3部分构成,分别为、和Sink。
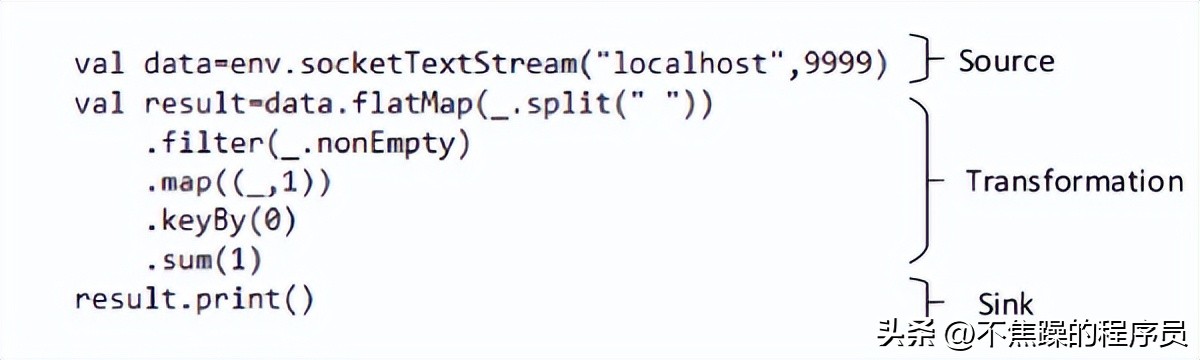
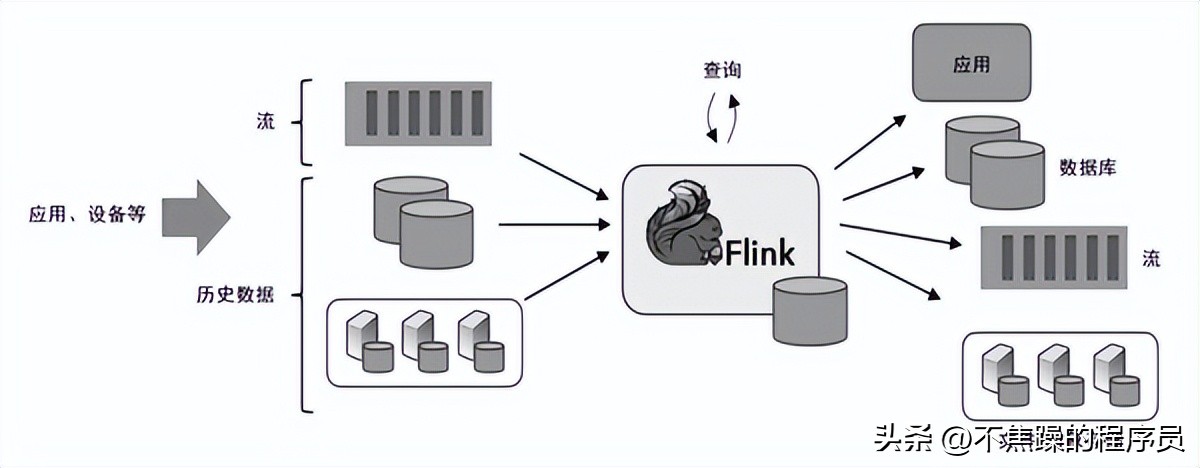
编程固定套路:
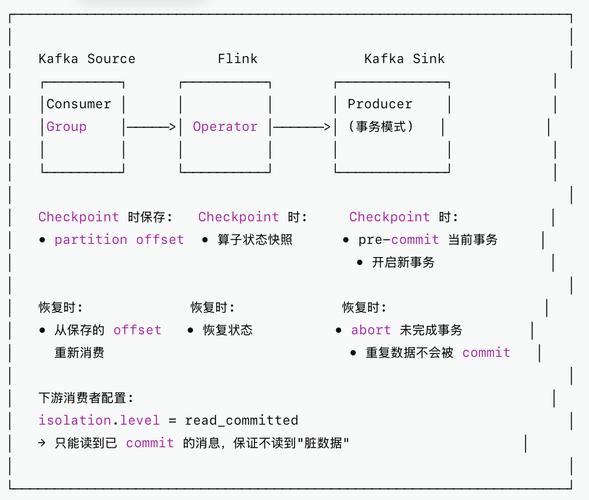
创建执行环境读取源数据转换数据输出转换结果触发任务执行9、补充概念
9.1、什么是算子
Flink提供了丰富的用于数据处理的函数,这些函数称为算子。说白了就是Flink提供了一系列处理数据的函数给你调用。至于函数内部如何处理交换数据php require_once 10分钟入门Flink—了解Flink,使用者无需关心。
9.2、原生流处理和微批次区别
原生流处理:
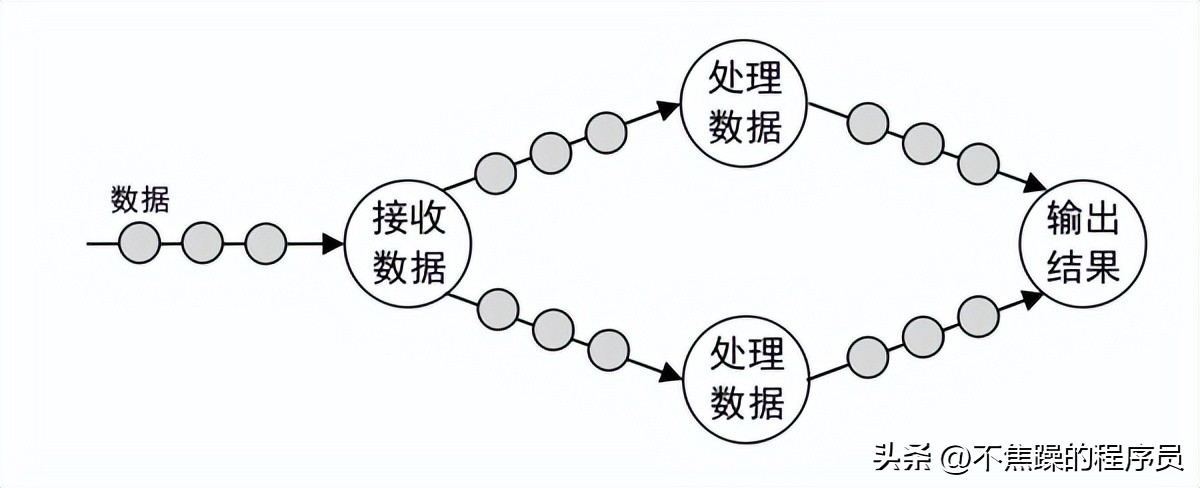
微批次处理:
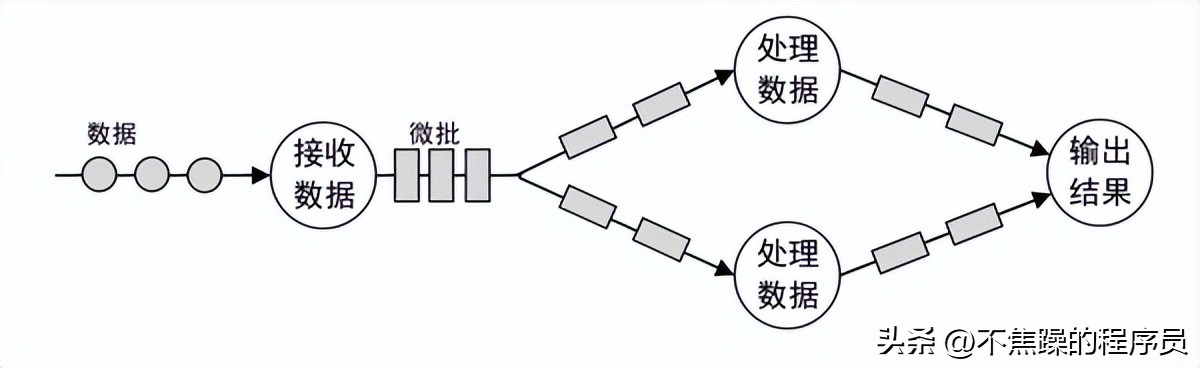
9.3、处理次数
处理次数分为:At-Most-Once、At-Least-Once、-Once。
At-Most-Once:每条数据最多被处理一次,会有丢失数据的可能。
At-Least-Once:每条数据至少被处理一次,保证数据不会丢失,但数据可能会被重复处理。
-Once:每条数据仅被处理一次,不会丢失数据,也不会重复处理。
Storm实现了At-Least-Once,可以对数据至少处理一次,但不能保证仅处理一次,这样就会导致数据重复处理的问题,因此针对计数类的需求可能会产生一些误差;
Spark 和Flink都实现了-Once,可以保证对数据仅处理一次,即每个记录将被精确处理一次,数据不会丢失,并且不会重复处理。
10、结尾
本文首先以粗浅的概念和大白话讲了什么是Flink以及他的使用场景,然后给出了1个简单demo。再到后面给出了一些大的概念框架。希望对你有帮助。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » php require_once 10分钟入门Flink—了解Flink

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码