双旋网络
十种SQL的语法

十种SQL的语法
一、ORDER BY FIELD()自定义排序逻辑
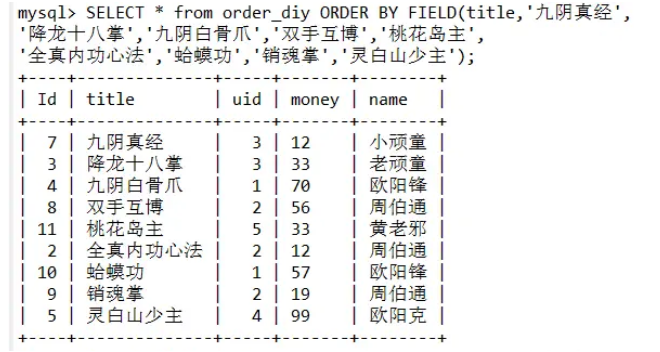
ORDER BY FIELD(str,str1,…) 自定义排序sql如下:
SELECT * from order_diy ORDER BY FIELD(title,'九阴真经', '降龙十八掌','九阴白骨爪','双手互博','桃花岛主','全真内功心法','蛤蟆功','销魂掌','灵白山少主');
二、CASE表达式
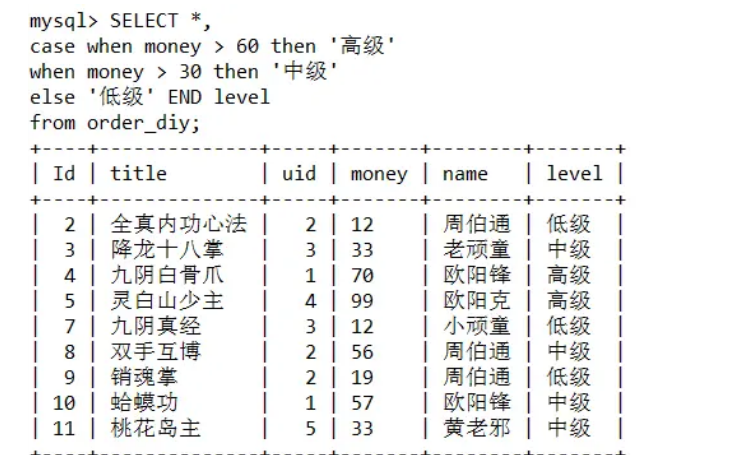
假如我们想在 表加一列 level 列,根据money 判断大于60就是高级,大于30就是中级,其余显示低级,sql 如下:
SELECT *,
case when money > 60 then '高级'
when money > 30 then '中级'
else '低级' END level
from order_diy;
三、用法
可知 后面是跟着一个子查询语句十种SQL的语法,它的作用是根据主查询的数据,每一行都放到子查询中做条件验证,根据验证结果(TRUE 或者 FALSE),TRUE的话该行数据就会保留,下面用 emp 表和 dept 表进行举例,表结构以及数据展示:计入我们现在想找到 emp 表中 与 dept表 中 对应不上员工数据,sql 如下:
SELECT * from emp e where exists (
SELECT * from dept p where e.dept_id = p.dept_id
and e.dept_name != p.dept_name
)
四、GROUP (expr)组连接函数
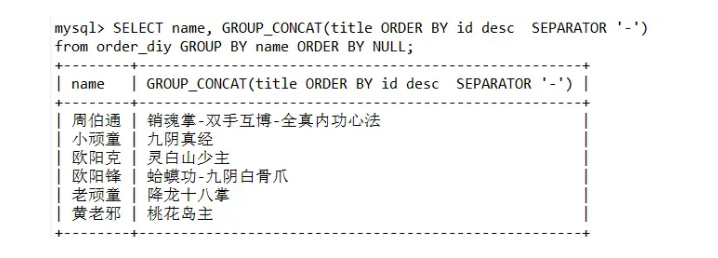
(expr) 组连接函数可以返回分组后指定字段的字符串连接形式,并且可以指定排序逻辑,以及连接字符串,默认为英文逗号连接。这里继续用 表举例:sql 如下:
SELECT name, GROUP_CONCAT(title ORDER BY id desc  SEPARATOR '-')
from order_diy GROUP BY name ORDER BY NULL;
五、自连接查询
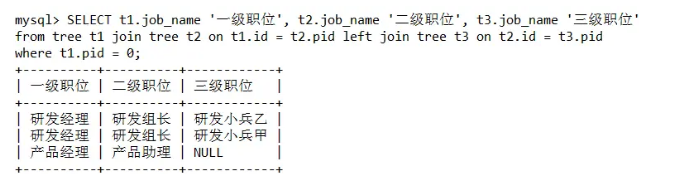
tree 表中通过 pid 字段与 id 字段进行父子关联,假如现在有一个需求,我们想按照父子层级将 tree 表数据转换成 一级职位 二级职位 三级职位 三个列名进行展示,sql 如下:
SELECT t1.job_name '一级职位', t2.job_name '二级职位', t3.job_name '三级职位'
from tree t1 join tree t2 on t1.id = t2.pid left join tree t3 on t2.id = t3.pid
where t1.pid = 0;
六、更新emp表和dept表关联数据
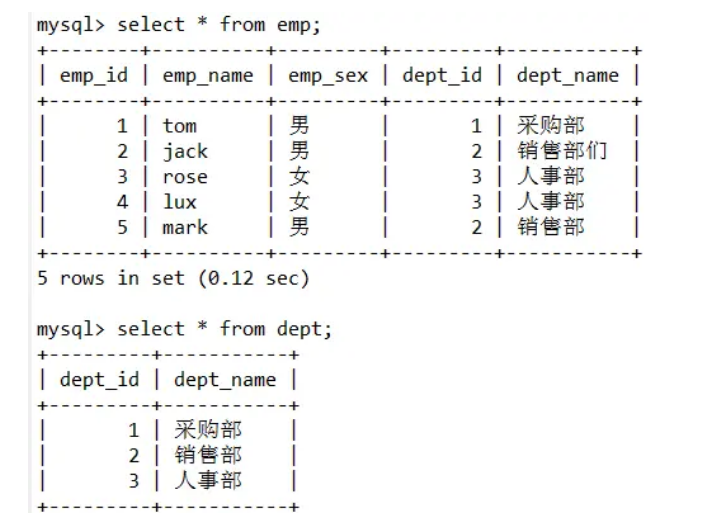
可以看到上述 emp 表中 jack 的部门名称与 dept 表实际不符合,现在我们想将 jack 的部门名称更新成 dept 表的正确数据,sql 如下:
update emp, dept set emp.dept_name = dept.dept_name
where emp.dept_id = dept.dept_id;
七、ORDER BY空值NULL排序
ORDER BY 字句中可以跟我们要排序的字段名称,但是当字段中存在 null 值时,会对我们的排序结果造成影响。我们可以通过 ORDER BY IF((title), 1, 0) 语法将 null 值转换成0或1,来达到将 null 值放到前面还是后面进行排序的效果。这里继续用 表举例十种SQL的语法,sql 如下:
SELECT * FROM order_diy ORDER BY IF(ISNULL(title), 0, 1), money;
八、with 分组统计数据的基础上再进行统计汇总
MySql 中可以使用 with 在分组统计数据的基础上再进行统计汇总,即用来得到 group by 的汇总信息。这里继续用 表举例,sql 如下:
SELECT name, SUM(money) as money
FROM order_diy GROUP BY name WITH ROLLUP;
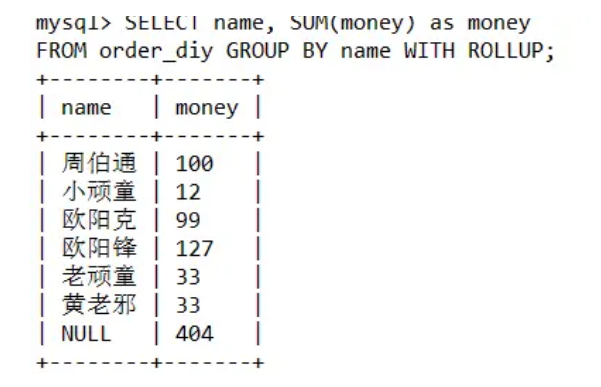
可以看到通过 GROUP BY name WITH 语句,查询结果最后一列显示了分组统计的汇总结果。但是 name 字段最后显示为 null,我们可以通过 (val1, val2, …) 函数,这个函数会返回参数列表中的第一个非空参数。
九、with as 提取临时表别名
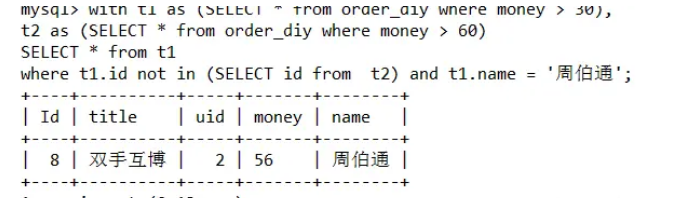
如果一整句查询中多个子查询都需要使用同一个子查询的结果,那么就可以用 with assql语句as的用法,将共用的子查询提取出来,加个别名。后面查询语句可以直接用,对于大量复杂的SQL语句起到了很好的优化作用。这里继续用 表举例,这里使用 with as 给出 sql 如下:
-- 使用 with as
with t1 as (SELECT * from order_diy where money > 30),
t2 as (SELECT * from order_diy where money > 60)
SELECT * from t1
where t1.id not in (SELECT id from  t2) and t1.name = '周伯通';
十、存在就更新,不存在就插入
MySql 中通过on key 语法来实现存在就更新,不存在就插入的逻辑。插入或者更新时sql语句as的用法,它会根据表中主键索引或者唯一索引进行判断sql语句as的用法,如果主键索引或者唯一索引有冲突,就会执行on key 后面的赋值语句。 这里通过 news 表举例,表结构和说数据展示,其中 字段有唯一索引:
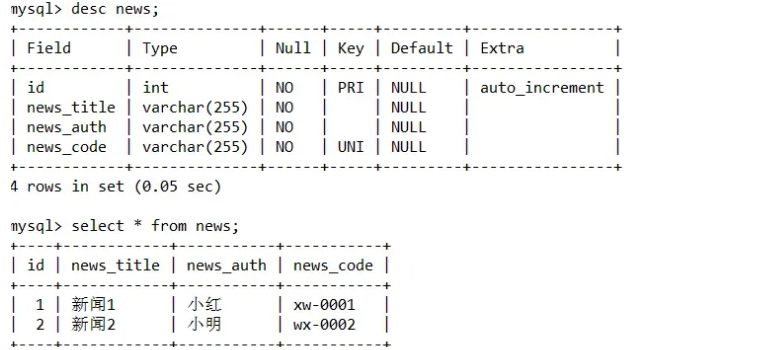
添加sql:
-- 第一次执行添加语句
INSERT INTO `news` (`news_title`, `news_auth`, `news_code`)
VALUES ('新闻3', '小花', 'wx-0003')
on duplicate key update news_title = '新闻3';
-- 第二次执行修改语句
INSERT INTO `news` (`news_title`, `news_auth`, `news_code`)
VALUES ('新闻4', '小花', 'wx-0003')
on duplicate key update news_title = '新闻4';
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » 十种SQL的语法

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码