双旋网络
从一条SQL的执行顺序,理解SQL如何写才能高效

从一条SQL的执行顺序,理解SQL如何写才能高效
SQL的性能不在于语法多复杂,而在于是否符合数据库的执行逻辑。一条SQL在数据库内部的执行顺序,决定了我们如何写出高效的查询。
SQL的“秘密执行顺序”
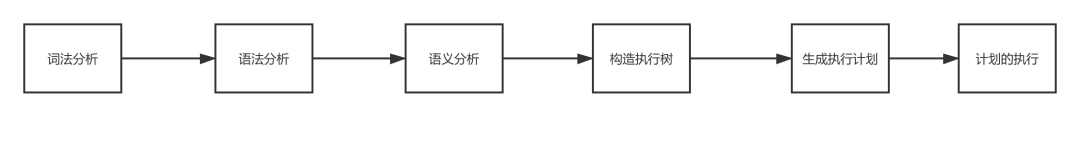
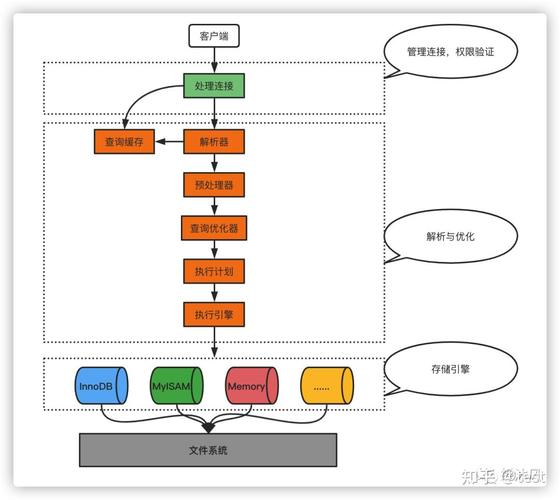
这是SQL语句在数据库内部的真实执行顺序从一条SQL的执行顺序,理解SQL如何写才能高效,也是优化的核心逻辑:
1. FROM 与 JOIN     -- 确定数据来源
2. WHERE            -- 初步筛选
3. GROUP BY         -- 分组聚合
4. HAVING           -- 对分组后筛选
5. SELECT           -- 选择字段
6. DISTINCT         -- 去重
7. ORDER BY         -- 排序
8. LIMIT/OFFSET -- 限制结果记住这个顺序sqlserver执行sql语句,你的SQL优化就成功了一半。
优化实战:让SQL按“正确顺序”工作案例1:WHERE要尽早过滤
低效写法:
SELECT user_id, COUNT(*)
FROM orders
GROUP BY user_id
HAVING user_id IN (SELECT id FROM users WHERE status = 'active');
-- 先对所有订单分组,再用子查询过滤
高效写法:
SELECT o.user_id, COUNT(*)
FROM orders o
JOIN users u ON o.user_id = u.id AND u.status = 'active'
GROUP BY o.user_id;
-- 先过滤活跃用户,再分组统计原理:在FROM/JOIN阶段就过滤数据sqlserver执行sql语句,减少后续处理的数据量。
案例2:避免在WHERE中对字段进行计算
低效写法:
SELECT * FROM orders
WHERE YEAR(create_time) = 2024 AND MONTH(create_time) = 1;
-- 每行都要计算YEAR()和MONTH(),无法使用索引
高效写法:
SELECT * FROM orders
WHERE create_time >= '2024-01-01'
AND create_time < '2024-02-01';
-- 直接使用索引范围查询
案例3:JOIN的顺序优化
低效写法:
SELECT *
FROM large_table l
JOIN small_table s ON l.id = s.large_id
WHERE l.category = 'A';
-- 先对300万行的大表做JOIN
高效写法:
SELECT *
FROM (SELECT * FROM large_table WHERE category = 'A') l
JOIN small_table s ON l.id = s.large_id;
-- 先用WHERE将大表从300万行过滤到1万行
案例4:只取需要的列
低效写法:
SELECT * FROM users
WHERE age > 20
ORDER BY create_time DESC
LIMIT 100;
-- 读取所有字段,包括不必要的大文本字段
高效写法:
SELECT id, name, age, create_time
FROM users
WHERE age > 20
ORDER BY create_time DESC
LIMIT 100;
-- 只读取实际需要的字段
关键优化原则1. 索引生效的黄金法则2. 减少中间数据集
-- 错误:产生大量中间数据
SELECT * FROM (
    SELECT * FROM logs WHERE level = 'ERROR'
) t ORDER BY time DESC LIMIT 10;
-- 正确:尽早应用LIMIT
SELECT * FROM logs
WHERE level = 'ERROR'
ORDER BY time DESC
LIMIT 10;
3. 是你的最佳工具
每个优化都要用验证:
EXPLAIN
SELECT u.name, COUNT(o.id)
FROM users u
JOIN orders o ON u.id = o.user_id
WHERE u.created_at > '2024-01-01'
GROUP BY u.id
HAVING COUNT(o.id) > 5;
关注:
实战:一条SQL的完整优化
原始查询(执行慢):
SELECT DISTINCT u.*,
       (SELECT COUNT(*) FROM orders o WHERE o.user_id = u.id) as order_count
FROM users u
LEFT JOIN orders o ON u.id = o.user_id
WHERE u.status = 'active'
  AND o.amount > 1000
ORDER BY u.create_time DESC;
优化步骤:
1.移除不必要的
SELECT u.*,
       COUNT(o.id) as order_count
FROM users u
JOIN orders o ON u.id = o.user_id
WHERE u.status = 'active'
  AND o.amount > 1000
GROUP BY u.id
ORDER BY u.create_time DESC;
2.添加合适索引
CREATE INDEX idx_users_status ON users(status);
CREATE INDEX idx_orders_user_amount ON orders(user_id, amount);
3.使用覆盖索引进一步优化
SELECT u.id, u.name, u.email, u.create_time,
       COUNT(o.id) as order_count
FROM users u
JOIN orders o ON u.id = o.user_id
WHERE u.status = 'active'
  AND o.amount > 1000
GROUP BY u.id
ORDER BY u.create_time DESC;
总结:高效SQL的四个层次基础层:正确使用WHERE提前过滤索引层:确保查询能用上合适的索引结构层:优化JOIN顺序和子查询存储层:考虑分库分表、读写分离
记住:数据库是按照固定顺序执行SQL的,你的任务就是让这个执行过程尽可能高效。 每次写SQL时sqlserver执行sql语句,心里默念执行顺序,思考如何让每一步处理的数据量最小化从一条SQL的执行顺序,理解SQL如何写才能高效,这就是SQL优化的核心秘诀。
好的SQL不是复杂的SQL,而是符合数据库思维的SQL。
公告:
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » 从一条SQL的执行顺序,理解SQL如何写才能高效
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » 从一条SQL的执行顺序,理解SQL如何写才能高效

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码