双旋网络
PHP字符串截取:substr、mb_substr及多字节处理详解

PHP字符串截取:substr、mb_substr及多字节处理详解
PHP字符串截取:、及多字节处理详解
在PHP开发中,字符串处理是基础且高频的操作。针对单字节字符(如ASCII)的截取需求,()函数足够高效;但当处理中文、日文等多字节字符时,直接使用()可能导致乱码或截取不完整。本文将详细对比()与()的差异,结合多字节字符串处理函数(如()、()),提供实际场景下的解决方案,并给出性能优化建议。
一、基础函数:()的适用场景与局限1.1 ()的核心功能
( $, int $, ?int $)是PHP内置的字符串截取函数,支持从指定位置开始截取固定长度的子串。例如:
$str = "Hello World";echo substr($str, 6, 5); // 输出 "World"
1.2 单字节场景下的高效性
在纯英文或ASCII字符环境下php substr 截取中文,()的性能极高,因为其底层直接操作字节流,无需考虑字符编码。例如处理日志文件路径、URL参数等场景时,()是首选。
1.3 多字节字符的致命问题
当字符串包含中文、日文等多字节字符时,()会按字节截取,导致字符被截断。例如:
$str = "你好,世界!";echo substr($str, 0, 3); // 可能输出乱码(如"你"的3字节被截断)
原因:UTF-8编码下,一个中文字符占3字节,若截取位置非3的倍数,会导致字符不完整。
二、多字节解决方案:()详解2.1 ()的核心参数
( $, int $start, ?int $, ? $)是PHP多字节字符串扩展提供的函数PHP字符串截取:substr、mb_substr及多字节处理详解,需确保扩展已启用。其关键参数:
2.2 中英文混合处理示例
$str = "Hello,你好!";echo mb_substr($str, 0, 5, 'UTF-8'); // 输出 "Hello,你"
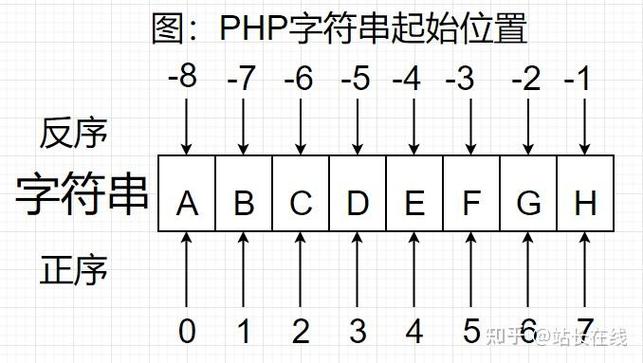
说明:从第0个字符开始截取5个字符PHP字符串截取:substr、mb_substr及多字节处理详解,中英文混合场景下仍能正确处理。
2.3 性能对比与优化建议三、多字节字符串处理函数族3.1 ():获取字符长度
$str = "你好,世界!";echo mb_strlen($str, 'UTF-8'); // 输出6(6个字符)
对比:()返回字节数(此处为18字节),而()返回字符数。
3.2 ():按字节安全截取
若需按字节截取但避免乱码,可使用():
$str = "你好,世界!";echo mb_strcut($str, 0, 6, 'UTF-8'); // 输出 "你好,"(截取6字节,但保证字符完整)
适用场景:需限制字节数(如数据库字段长度)且允许字符截断时。
3.3 编码检测与转换
处理外部输入时,建议显式检测编码:
$str = "混合编码字符串";$encoding = mb_detect_encoding($str, ['UTF-8', 'GB2312', 'BIG5'], true);if ($encoding !== 'UTF-8') {$str = mb_convert_encoding($str, 'UTF-8', $encoding);}
四、实际场景解决方案4.1 用户昵称截取(前端显示)
需求:将用户昵称截取为5个字符,末尾添加”…”。
function truncateNickname($nickname) {$maxLen = 5;if (mb_strlen($nickname, 'UTF-8') > $maxLen) {return mb_substr($nickname, 0, $maxLen, 'UTF-8') . '...';}return $nickname;}echo truncateNickname("百度开发者"); // 输出 "百度开..."
4.2 搜索关键词高亮
需求:将搜索词在结果中高亮显示php substr 截取中文,需保证字符截取不破坏原词。
function highlightKeyword($text, $keyword) {$keywordLen = mb_strlen($keyword, 'UTF-8');$pos = mb_strpos($text, $keyword, 0, 'UTF-8');if ($pos !== false) {$prefix = mb_substr($text, 0, $pos, 'UTF-8');$suffix = mb_substr($text, $pos + $keywordLen, null, 'UTF-8');return $prefix . '' . $keyword . '' . $suffix;}return $text;}
五、最佳实践与注意事项5.1 统一编码环境5.2 错误处理5.3 性能测试建议六、扩展:正则表达式与多字节处理
若需复杂模式匹配php substr 截取中文,可结合()系列函数:
$str = "价格:¥100";if (mb_ereg('价格:¥([0-9]+)', $str, $matches)) {echo $matches[1]; // 输出100}
优势:()支持多字节字符的正则匹配,避免()在中文场景下的误判。
总结函数适用场景性能字符安全
()
单字节字符(ASCII)
()
多字节字符(UTF-8等)
()
按字节截取且需字符完整
建议:
默认使用UTF-8编码处理所有文本。中英文混合场景优先选择()。对性能敏感的场景,考虑预处理或缓存结果。
通过合理选择字符串处理函数,可有效避免乱码问题,提升代码的健壮性与可维护性。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » PHP字符串截取:substr、mb_substr及多字节处理详解

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码