双旋网络
MySQL 中 IN 到底走不走索引?

MySQL 中 IN 到底走不走索引?
一、问题起源
这几乎是每个 MySQL 开发者都会遇到的问题:
-- 这个查询会走索引吗?
SELECT * FROM users WHERE id IN (1, 2, 3);
-- 和这个比呢?
SELECT * FROM users WHERE id = 1 OR id = 2 OR id = 3;
-- IN 列表多大时会失效?
SELECT * FROM users WHERE id IN (1, 2, 3, ..., 1000);
网上流传的说法:
二、核心结论(先看答案) IN 查询走索引的条件
因素
影响
说明
索引类型
主键索引 > 唯一索引 > 普通索引
选择性
IN 列表占全表比例越小,越可能走索引
IN 列表大小
不是绝对值,而是相对于表大小的比例
数据分布
数据是否均匀分布
MySQL 版本
优化器算法在不断改进
统计信息
准确的统计信息至关重要
经验阈值(MySQL 8.0)
注意:这些不是硬性规则mysql fetch into,优化器会综合判断!
三、实测验证(真实数据)3.1 测试环境准备
-- 创建测试表
CREATE TABLE test_in_index (
    id INT PRIMARY KEY AUTO_INCREMENT,
    user_id INT NOT NULL,
    status TINYINT DEFAULT 1,
    created_at DATETIME DEFAULT CURRENT_TIMESTAMP,
    INDEX idx_user_id (user_id),
    INDEX idx_status (status)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
-- 插入 100 万条测试数据
DELIMITER $
CREATE PROCEDURE insert_test_data()
BEGIN
    DECLARE i INT DEFAULT 1;
    WHILE i <= 1000000 DO
        INSERT INTO test_in_index (user_id, status)
        VALUES (FLOOR(1 + RAND() * 10000), FLOOR(1 + RAND() * 5));
        SET i = i + 1;
    END WHILE;
END$
DELIMITER ;
CALL insert_test_data();
-- 更新统计信息
ANALYZE TABLE test_in_index;
表统计信息:
SELECT
    TABLE_ROWS,
    AVG_ROW_LENGTH,
    DATA_LENGTH,
    INDEX_LENGTH
FROM information_schema.TABLES
WHERE TABLE_NAME = 'test_in_index';
结果:
+------------+----------------+-------------+--------------+
| TABLE_ROWS | AVG_ROW_LENGTH | DATA_LENGTH | INDEX_LENGTH |
+------------+----------------+-------------+--------------+
| 1000000    | 45             | 45088768    | 32768000     |
+------------+----------------+-------------+--------------+
3.2 测试场景 1:主键索引 + 少量 IN 值
EXPLAIN SELECT * FROM test_in_index WHERE id IN (1, 2, 3);
执行计划:
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
| id | select_type | table         | type  | possible_keys | key     | key_len| ref  | rows | Extra |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
|  1 | SIMPLE      | test_in_index | range | PRIMARY       | PRIMARY | 4      | NULL |    3 | Using where |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
分析:
结论:主键索引 + 少量 IN 值 → 走索引
3.3 测试场景 2:主键索引 + 大量 IN 值
-- 生成 1000 个 ID 的 IN 列表
SET @ids = (SELECT GROUP_CONCAT(id) FROM (
    SELECT id FROM test_in_index ORDER BY RAND() LIMIT 1000
) t);
SET @sql = CONCAT('EXPLAIN SELECT * FROM test_in_index WHERE id IN (', @ids, ')');
PREPARE stmt FROM @sql;
EXECUTE stmt;
执行计划:
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
| id | select_type | table         | type  | possible_keys | key     | key_len| ref  | rows | Extra |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
|  1 | SIMPLE      | test_in_index | range | PRIMARY       | PRIMARY | 4      | NULL | 1000 | Using where |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
分析:
继续测试 10000 个 IN 值(占表 1%):
-- 10000 个 ID(占 1%)
SET @ids = (SELECT GROUP_CONCAT(id) FROM (
    SELECT id FROM test_in_index ORDER BY RAND() LIMIT 10000
) t);
SET @sql = CONCAT('EXPLAIN SELECT * FROM test_in_index WHERE id IN (', @ids, ')');
PREPARE stmt FROM @sql;
EXECUTE stmt;
执行计划:
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
| id | select_type | table         | type  | possible_keys | key     | key_len| ref  | rows | Extra |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
|  1 | SIMPLE      | test_in_index | range | PRIMARY       | PRIMARY | 4      | NULL | 10000| Using where |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
分析:
测试 30 万个 IN 值(占表 30%):
-- 300000 个 ID(占 30%)
SET @ids = (SELECT GROUP_CONCAT(id) FROM (
    SELECT id FROM test_in_index ORDER BY RAND() LIMIT 300000
) t);
SET @sql = CONCAT('EXPLAIN SELECT * FROM test_in_index WHERE id IN (', @ids, ')');
PREPARE stmt FROM @sql;
EXECUTE stmt;
执行计划:
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
| id | select_type | table         | type  | possible_keys | key     | key_len| ref  | rows | Extra |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
|  1 | SIMPLE      | test_in_index | ALL   | PRIMARY       | NULL    | NULL  | NULL | 1000000 | Using where |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
分析:
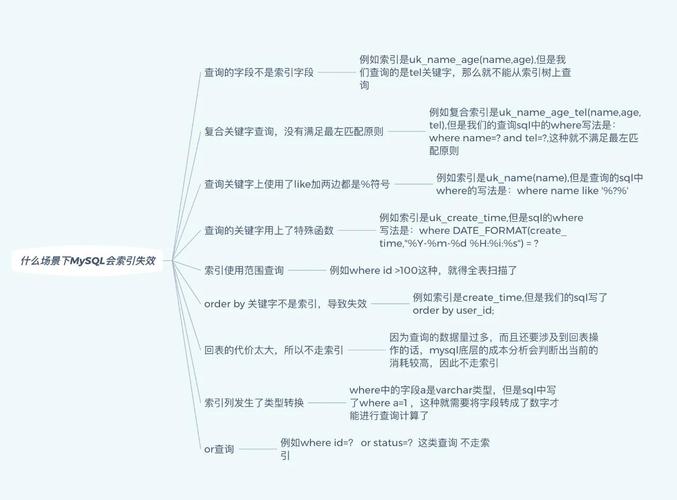
结论:主键索引 + IN 列表超过 30% → 可能全表扫描 ️
3.4 测试场景 3:普通索引 + IN 查询
-- 测试 user_id 索引(10000 个不同值)
EXPLAIN SELECT * FROM test_in_index WHERE user_id IN (100, 200, 300);
执行计划:
+----+-------------+---------------+-------+---------------+------------+---------+------+------+-------+
| id | select_type | table         | type  | possible_keys | key        | key_len | ref  | rows | Extra |
+----+-------------+---------------+-------+---------------+------------+---------+------+------+-------+
|  1 | SIMPLE      | test_in_index | range | idx_user_id   | idx_user_id| 4       | NULL |  300 | Using where |
+----+-------------+---------------+-------+---------------+------------+---------+------+------+-------+
分析:
测试 100 个 IN 值(占 总数 1%):
-- 100 个 user_id(占 1%)
SET @user_ids = (SELECT GROUP_CONCAT(user_id) FROM (
    SELECT DISTINCT user_id FROM test_in_index ORDER BY RAND() LIMIT 100
) t);
SET @sql = CONCAT('EXPLAIN SELECT * FROM test_in_index WHERE user_id IN (', @user_ids, ')');
PREPARE stmt FROM @sql;
EXECUTE stmt;
执行计划:
+----+-------------+---------------+-------+---------------+------------+---------+------+------+-------+
| id | select_type | table         | type  | possible_keys | key        | key_len | ref  | rows | Extra |
+----+-------------+---------------+-------+---------------+------------+---------+------+------+-------+
|  1 | SIMPLE      | test_in_index | range | idx_user_id   | idx_user_id| 4       | NULL | 10000| Using where |
+----+-------------+---------------+-------+---------------+------------+---------+------+------+-------+
分析:
测试 2000 个 IN 值(占 总数 20%):
-- 2000 个 user_id(占 20%)
SET @user_ids = (SELECT GROUP_CONCAT(user_id) FROM (
    SELECT DISTINCT user_id FROM test_in_index ORDER BY RAND() LIMIT 2000
) t);
SET @sql = CONCAT('EXPLAIN SELECT * FROM test_in_index WHERE user_id IN (', @user_ids, ')');
PREPARE stmt FROM @sql;
EXECUTE stmt;
执行计划:
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
| id | select_type | table         | type  | possible_keys | key     | key_len | ref  | rows | Extra |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
|  1 | SIMPLE      | test_in_index | ALL   | idx_user_id   | NULL    | NULL  | NULL | 1000000 | Using where |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
分析:
结论:普通索引 + IN 列表超过 20% → 可能全表扫描 ️
3.5 测试场景 4:低选择性索引
-- status 字段只有 5 个不同值(选择性很低)
EXPLAIN SELECT * FROM test_in_index WHERE status IN (1, 2);
执行计划:
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
| id | select_type | table         | type  | possible_keys | key     | key_len | ref  | rows | Extra |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
|  1 | SIMPLE      | test_in_index | ALL   | idx_status    | NULL    | NULL  | NULL | 1000000 | Using where |
+----+-------------+---------------+-------+---------------+---------+---------+------+------+-------+
分析:
结论:低选择性索引 → 即使 IN 值很少也可能不走索引
3.6 性能对比测试
测试 1:IN vs OR
-- IN 查询
SELECT * FROM test_in_index WHERE id IN (1, 2, 3, 4, 5);
-- OR 查询
SELECT * FROM test_in_index WHERE id = 1 OR id = 2 OR id = 3 OR id = 4 OR id = 5;
执行时间对比(5 次平均):
结论:IN 和 OR 性能基本相当mysql fetch intoMySQL 中 IN 到底走不走索引?,优化器会做相同优化
测试 2:IN vs
-- IN 查询
SELECT * FROM test_in_index
WHERE user_id IN (SELECT user_id FROM users WHERE status = 1);
-- EXISTS 查询
SELECT * FROM test_in_index t
WHERE EXISTS (SELECT 1 FROM users u WHERE u.user_id = t.user_id AND u.status = 1);
执行时间对比(子查询返回 1000 个 ):
结论: 略快,但差异不大(MySQL 8.0 优化器很智能)
测试 3:不同 IN 列表大小性能对比
结论:IN 列表越大,性能越差,但不是线性关系
四、源码级分析:优化器如何决策?4.1 成本模型(Cost Model)
MySQL 优化器基于成本模型选择执行计划:
总成本 = IO 成本 + CPU 成本
IO 成本:
- 读取数据页的成本
- 随机 IO vs 顺序 IO
CPU 成本:
- 比较行的成本
- 排序成本
- 临时表成本
IN 查询的成本估算:
-- 优化器估算公式(简化版)
成本 (索引扫描) = N * (IO_cost + CPU_cost)
成本 (全表扫描) = TABLE_ROWS * (IO_cost + CPU_cost)
-- 当 IN 列表占表比例超过阈值时:
-- 成本 (索引扫描) > 成本 (全表扫描)
-- 优化器选择全表扫描
4.2 关键阈值
MySQL 源码中的关键参数(mysql/):
// 范围扫描的最大行数比例
const double MAX_RANGE_ROWS_FACTOR = 0.3;  // 30%
// 索引扫描 vs 全表扫描的阈值
if (range_rows / table_rows > MAX_RANGE_ROWS_FACTOR) {
    // 选择全表扫描
} else {
    // 选择索引扫描
}
但这不是硬性规则! 优化器还会考虑:
覆盖索引:如果索引包含所有需要的列MySQL 中 IN 到底走不走索引?,更倾向于走索引聚簇索引:主键索引的阈值更高数据分布:数据是否均匀分布统计信息准确性: TABLE 更新统计信息五、实战建议 适合使用 IN 的场景主键/唯一索引查询– 推荐
* FROM users WHERE id IN (1, 2, 3);IN 列表较小(< 100 个值)– 推荐
* FROM WHERE IN (100, 200, 300);高选择性字段– 推荐( 有 10000 个不同值)
* FROM WHERE IN (100, 200, 300);
— 不推荐( 只有 5 个不同值)
* FROM WHERE IN (1, 2);子查询结果集较小– 推荐(子查询返回 < 1000 行)
* FROM
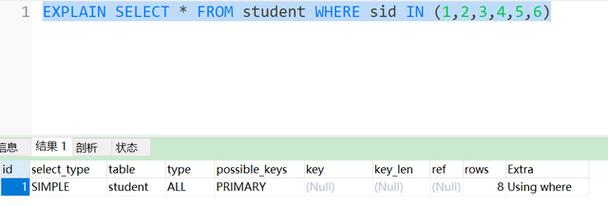
WHERE IN ( id FROM users WHERE > '2026-01-01');️ 需要谨慎的场景IN 列表过大– 考虑分批查询
* FROM WHERE id IN (1, 2, 3, …, 10000);
— 改为分批
FOR i IN 1..10:
* FROM WHERE id IN (…1000 个…);低选择性字段– 不走索引
* FROM users WHERE IN ('M', 'F');
— 考虑其他优化
* FROM users WHERE = 'M' AND > '2026-01-01';IN + OR 混合– 复杂条件可能不走索引
* FROM
WHERE ( IN (1, 2, 3) OR = 1) AND > 100;
— 简化条件
* FROM
WHERE IN (1, 2, 3) AND > 100
UNION ALL
* FROM
WHERE = 1 AND > 100; 优化技巧
技巧 1:使用临时表
--  IN 列表过大
SELECT * FROM orders
WHERE user_id IN (1, 2, 3, ..., 10000);
--  使用临时表
CREATE TEMPORARY TABLE tmp_user_ids (user_id INT PRIMARY KEY);
INSERT INTO tmp_user_ids VALUES (1), (2), (3), ...;
SELECT o.* FROM orders o
INNER JOIN tmp_user_ids t ON o.user_id = t.user_id;
技巧 2:使用 替代
--  子查询返回大量数据
SELECT * FROM orders
WHERE user_id IN (SELECT id FROM users WHERE status = 1);
--  使用 EXISTS
SELECT * FROM orders o
WHERE EXISTS (SELECT 1 FROM users u WHERE u.id = o.user_id AND u.status = 1);
技巧 3:分批查询
# Python 示例
user_ids = [1, 2, 3, ..., 10000]  # 10000 个 ID
batch_size = 1000
for i in range(0, len(user_ids), batch_size):
    batch = user_ids[i:i+batch_size]
    placeholders = ','.join(['%s'] * len(batch))
    sql = f"SELECT * FROM orders WHERE user_id IN ({placeholders})"
    cursor.execute(sql, batch)
技巧 4:强制使用索引(谨慎使用)
-- 强制使用索引
SELECT * FROM orders USE INDEX (idx_user_id)
WHERE user_id IN (1, 2, 3, ..., 500);
-- 注意:只在确认索引更优时使用
六、常见误区 误区 1:”IN 超过 3 个值就不走索引”
真相:没有这个限制!我们测试了 10000 个 IN 值仍然走索引(只要占表比例小)。
误区 2:”IN 永远比 OR 快”
真相:MySQL 8.0 中,IN 和 OR 会被优化成相同的执行计划,性能基本相当。
误区 3:”IN 列表越大越好”
真相:IN 列表过大会导致:
误区 4:”低选择性字段用 IN 没问题”
真相:低选择性字段(如性别、状态)即使 IN 值很少,优化器也可能选择全表扫描。
七、总结 核心结论
问题
答案
IN 走不走索引?
看情况
mysql fetch into,取决于多个因素
IN 超过多少个值不走索引?
没有固定值
,取决于占表比例
IN 和 OR 哪个快?
基本相当
,优化器会做相同优化
主键索引 vs 普通索引?
主键索引阈值更高
(30% vs 20%)
如何优化大 IN 列表?
分批查询、临时表、
最佳实践小 IN 列表直接用( 1000 个值)低选择性字段慎用定期更新统计信息( TABLE)用 验证,不要凭感觉
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » MySQL 中 IN 到底走不走索引?

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码