双旋网络
分享10个高级sql写法

分享10个高级sql写法
本文主要介绍博主在以往开发过程中,对于不同业务所对应的 sql 写法进行归纳总结而来。进而分享给大家。
一、ORDER BY FIELD() 自定义排序逻辑
MySql 中的排序 ORDER BY 除了可以用 ASC 和 DESC,还可以通过 ORDER BY FIELD(str,str1,…) 自定义字符串/数字来实现排序。这里用 表举例,结构以及表数据展示:
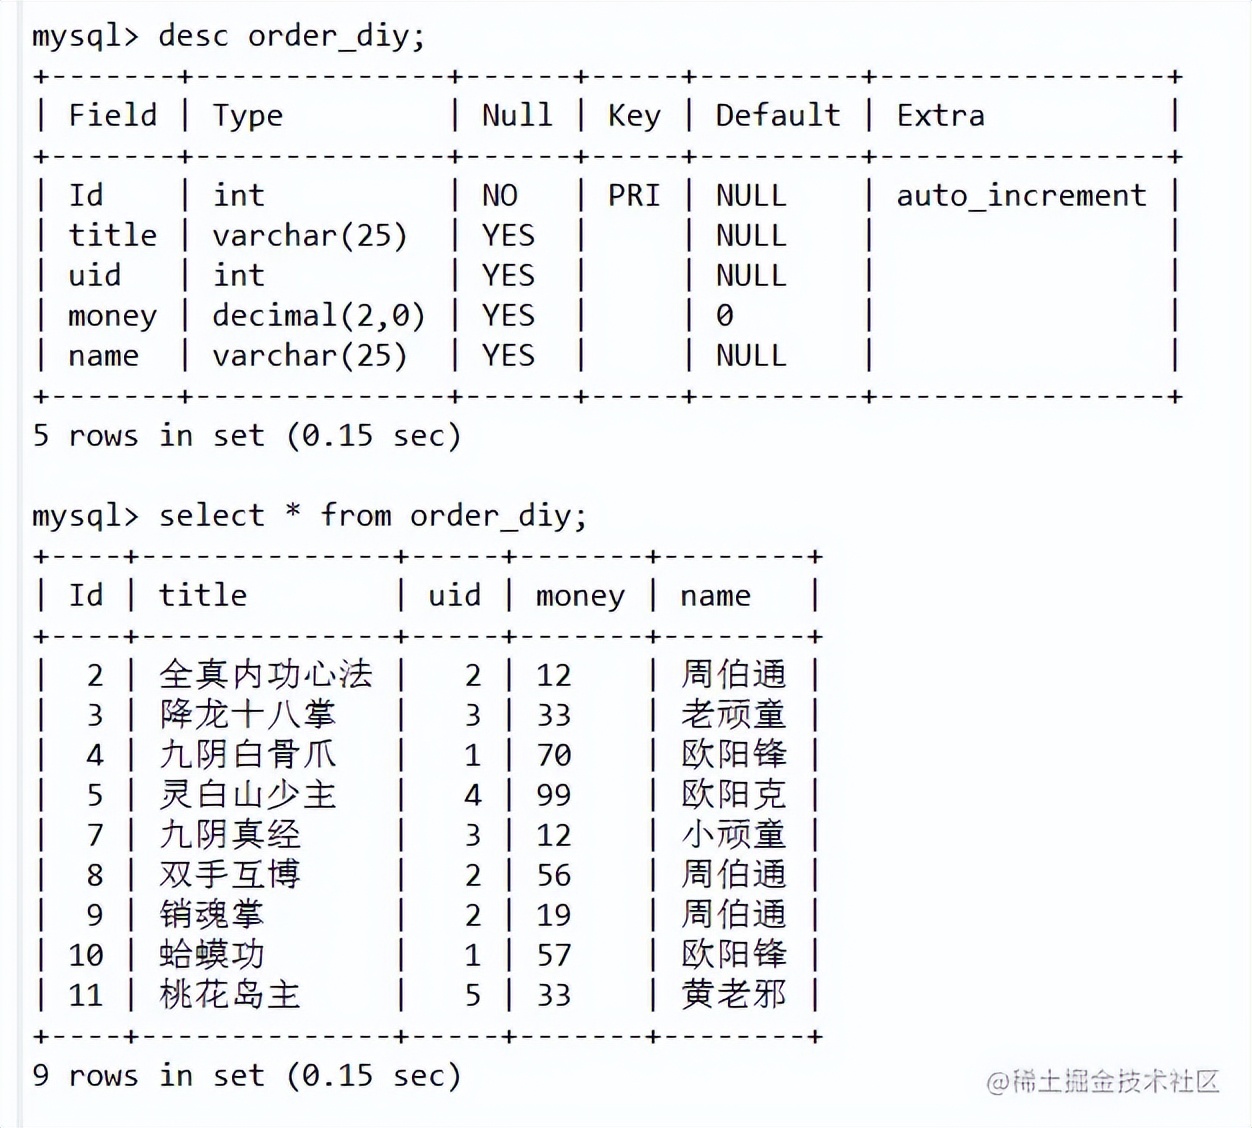
ORDER BY FIELD(str,str1,…) 自定义排序sql如下:
sql复制代码SELECT * from order_diy ORDER BY FIELD(title,'九阴真经',
'降龙十八掌','九阴白骨爪','双手互博','桃花岛主',
'全真内功心法','蛤蟆功','销魂掌','灵白山少主');
查询结果如下:
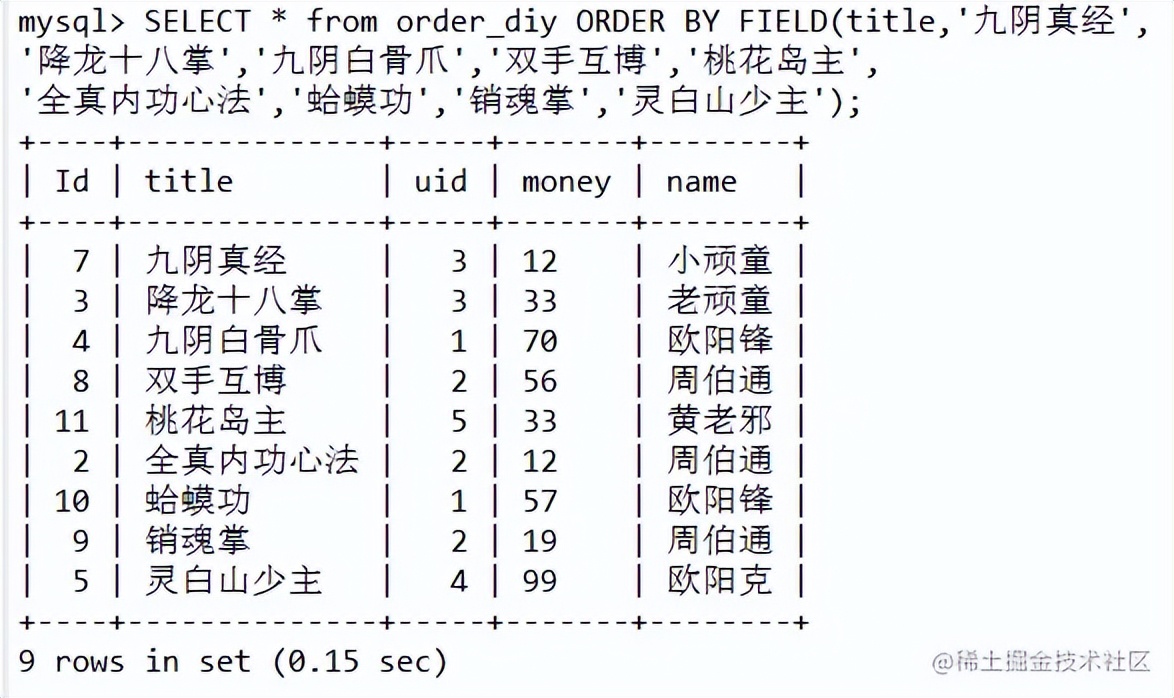
如上,我们设置自定义排序字段为 title 字段,然后将我们自定义的排序结果跟在 title 后面。
二、CASE 表达式
case when then else end表达式功能非常强大可以帮助我们解决 if else 这种问题,这里继续用 表举例,假如我们想在 表加一列 level 列,根据money 判断大于60就是高级,大于30就是中级,其余显示低级,sql 如下:
sql复制代码SELECT *,
case when money > 60 then '高级'
when money > 30 then '中级'
else '低级' END level
from order_diy;
查询结果:
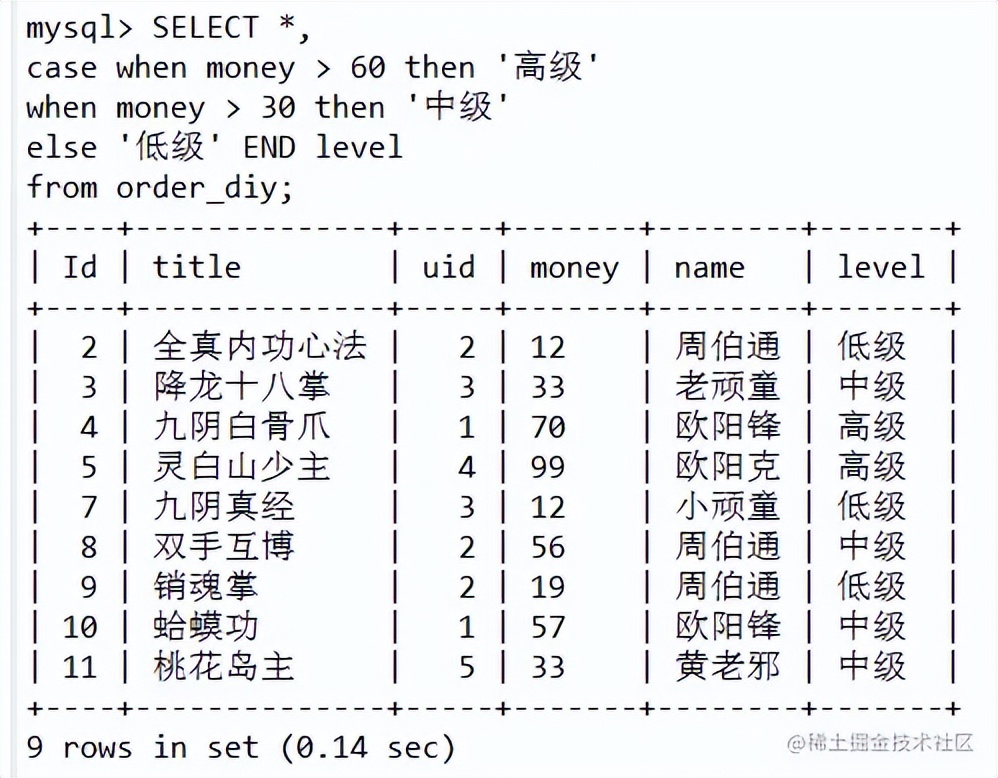
需要注意的就是 case when then 语句不匹配如果没有写 else end 会返回 null,影响数据展示。
三、 用法
我猜大家在日常开发中,应该都对关键词 用的比较少,估计使用 in 查询偏多。这里给大家介绍一下 用法,引用官网文档:
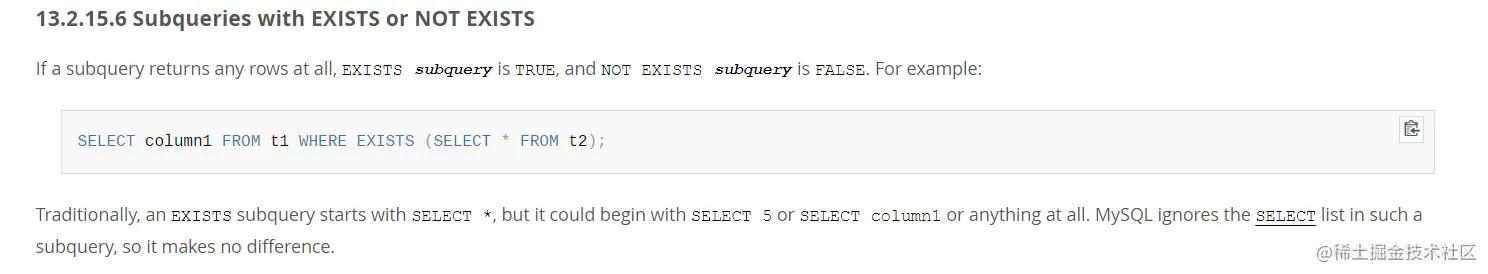
可知 后面是跟着一个子查询语句,它的作用是根据主查询的数据,每一行都放到子查询中做条件验证,根据验证结果(TRUE 或者 FALSE),TRUE的话该行数据就会保留,下面用 emp 表和 dept 表进行举例,表结构以及数据展示:
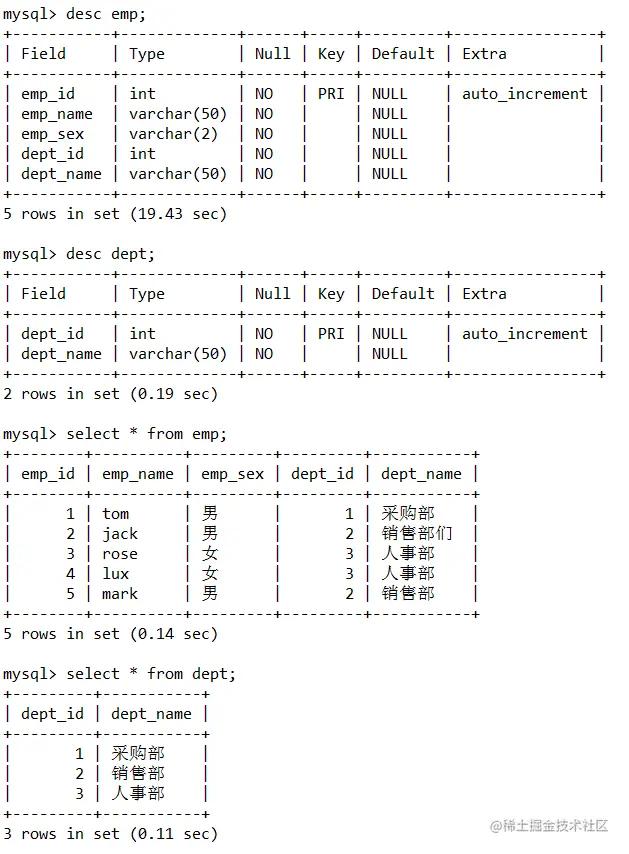
计入我们现在想找到 emp 表中 与 dept表 中 对应不上员工数据,sql 如下:
sql复制代码SELECT * from emp e where exists (
SELECT * from dept p where e.dept_id = p.dept_id
and e.dept_name != p.dept_name
)
查询结果:
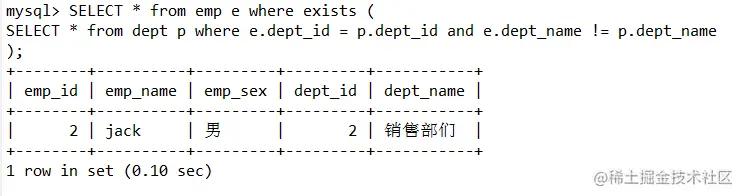
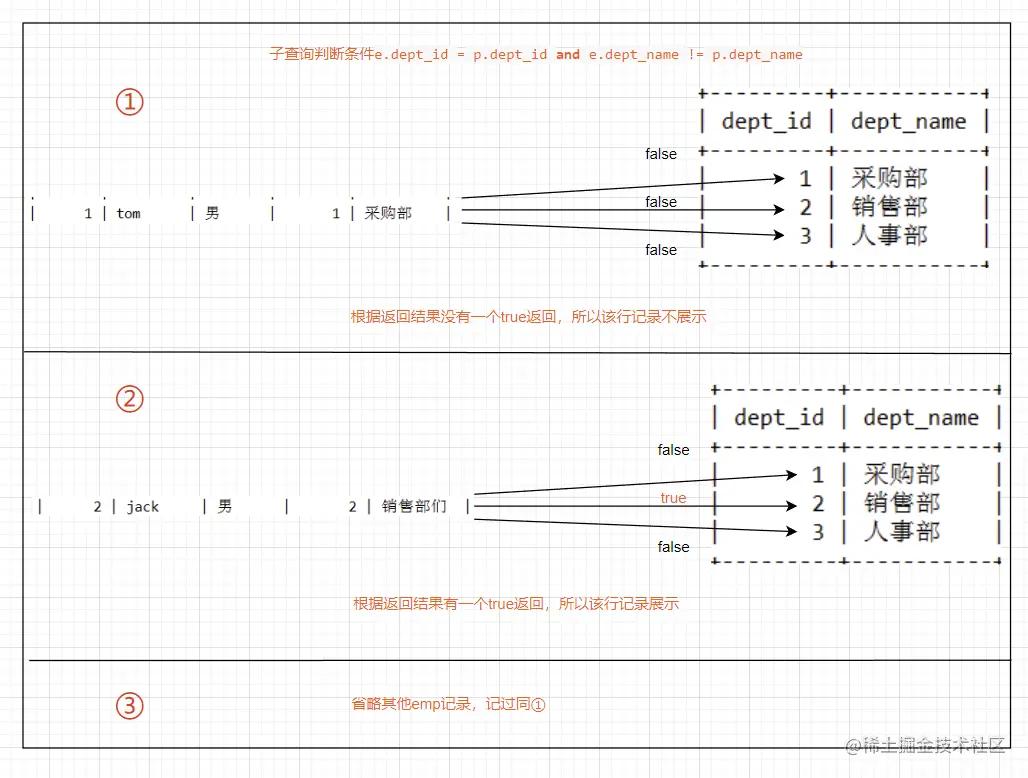
我们通过 语法将外层 emp 表全部数据 放到子查询中与一一与 dept 表全部数据进行比较,只要有一行记录返回true。画个图展示主查询所有记录与子查询交互如下:
四、(expr) 组连接函数
(expr) 组连接函数可以返回分组后指定字段的字符串连接形式,并且可以指定排序逻辑,以及连接字符串,默认为英文逗号连接。这里继续用 表举例:sql 如下:
sql复制代码SELECT name, GROUP_CONCAT(title ORDER BY id desc  SEPARATOR '-')
from order_diy GROUP BY name ORDER BY NULL;
查询结果:
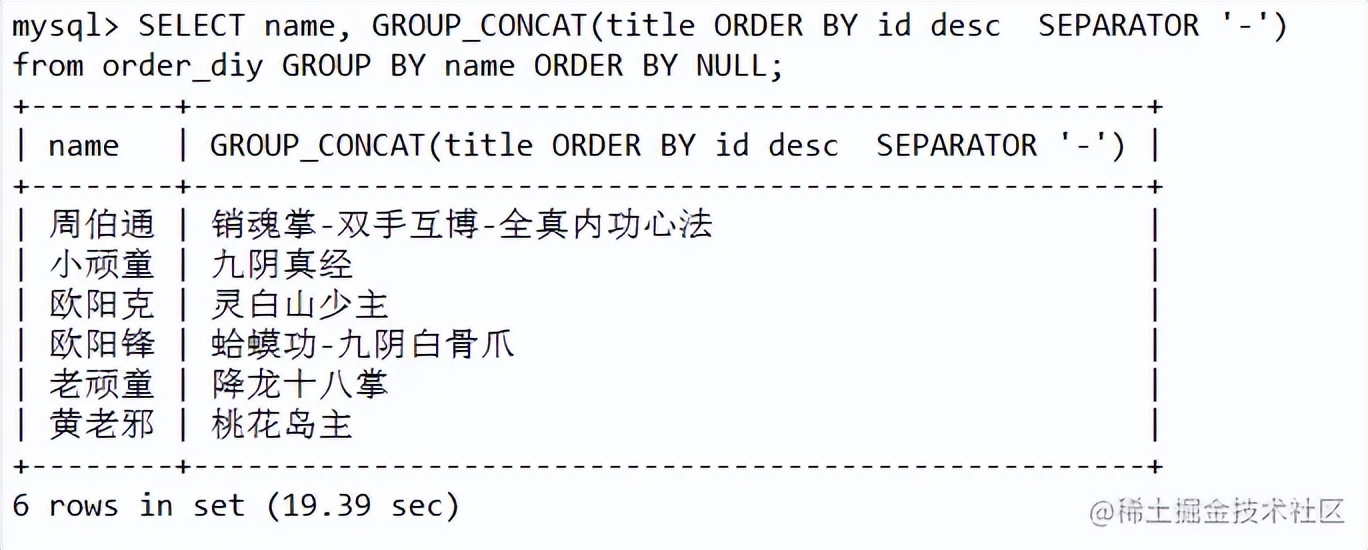
如上我们通过 (title ORDER BY id desc '-') 语句,指定分组连接 title 字段并按照 id 排序,设置连接字符串为 -。
五、自连接查询
自连接查询是 sql 语法里常用的一种写法,掌握了自连接的用法我们可以在 sql 层面轻松解决很多问题。这里用 tree 表举例,结构以及表数据展示:
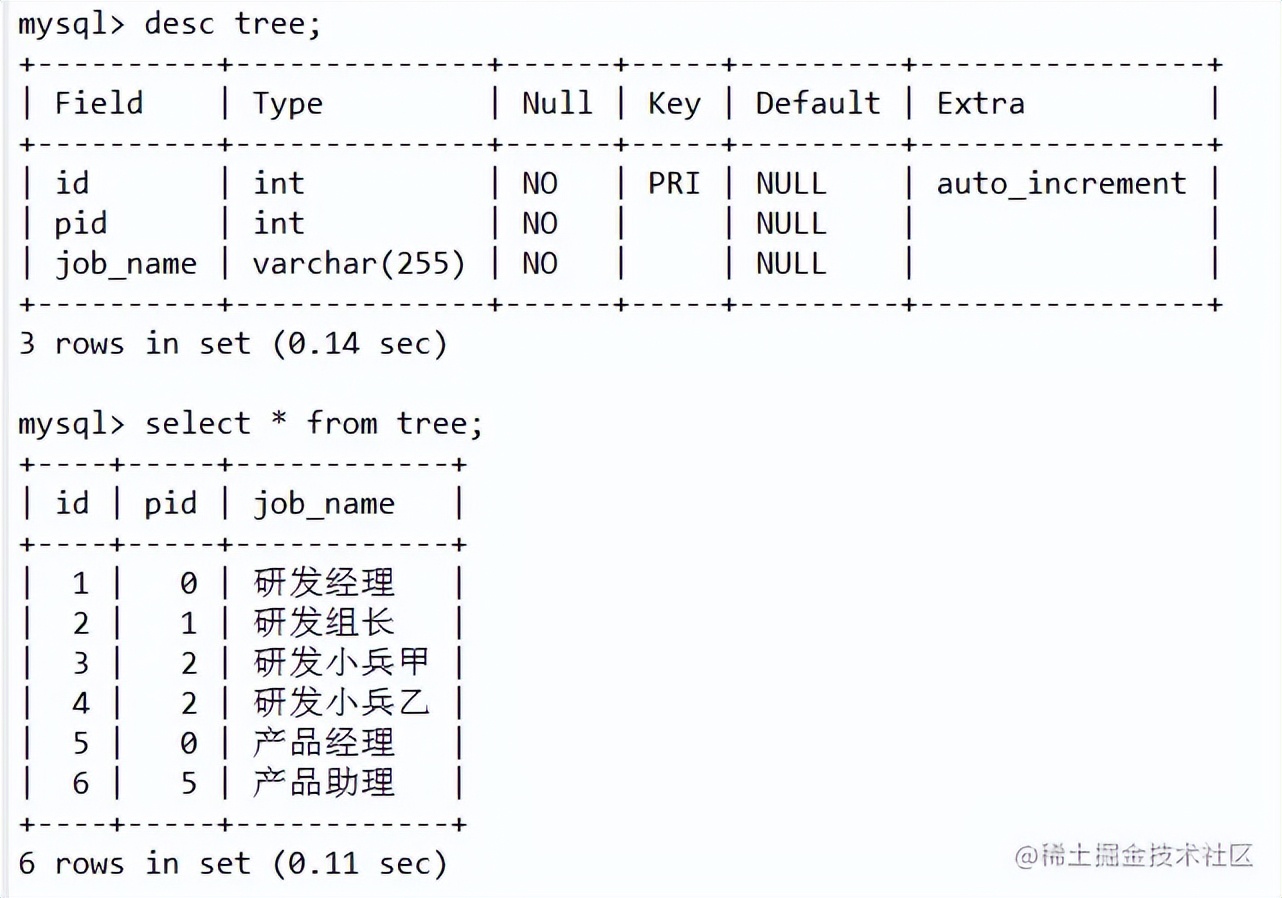
tree 表中通过 pid 字段与 id 字段进行父子关联,假如现在有一个需求,我们想按照父子层级将 tree 表数据转换成 一级职位 二级职位 三级职位 三个列名进行展示,sql 如下:
sql复制代码SELECT t1.job_name '一级职位', t2.job_name '二级职位', t3.job_name '三级职位'
from tree t1 join tree t2 on t1.id = t2.pid left join tree t3 on t2.id = t3.pid
where t1.pid = 0;
结果如下:
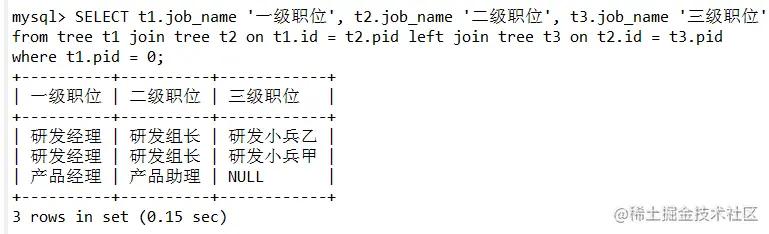
我们通过 tree t1 join tree t2 on t1.id = t2.pid 自连接展示 一级职位 二级职位,再用 left join tree t3 on t2.id = t3.pid 自连接展示 二级职位 三级职位,最后通过where 条件 t1.pid = 0过滤掉非一级职位的展示,完成这个需求。
六、更新 emp 表和 dept 表关联数据
这里继续使用上文提到的 emp 表和 dept 表,数据如下:
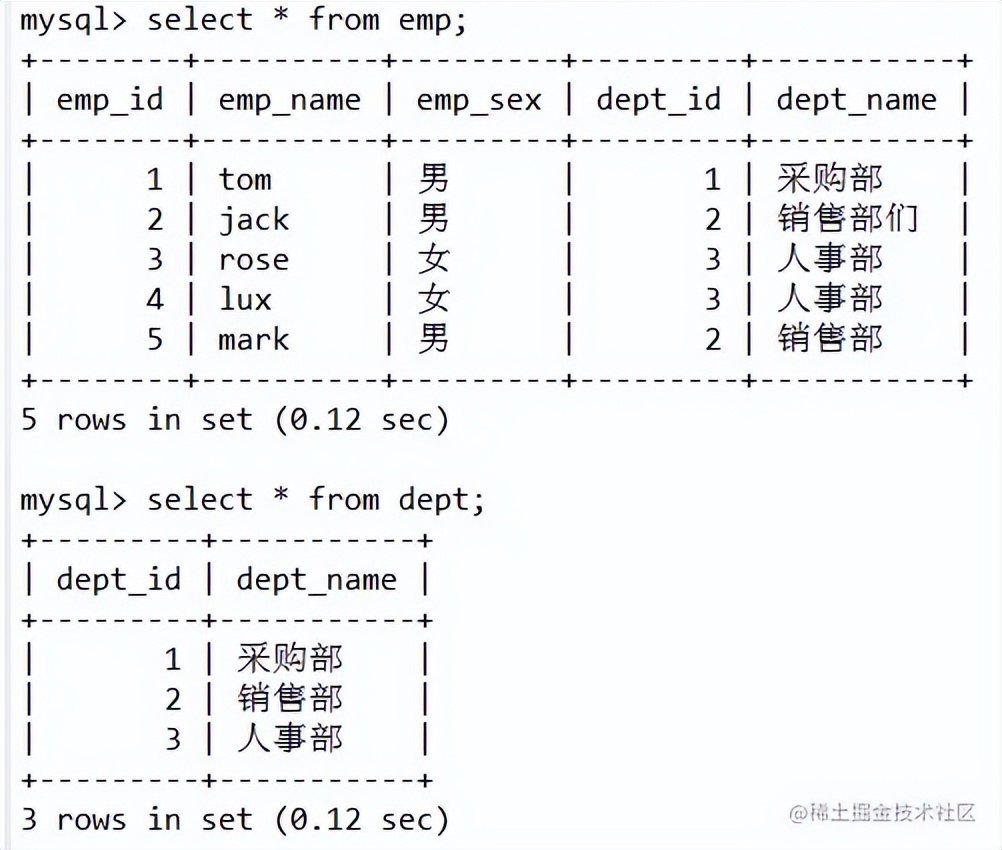
可以看到上述 emp 表中 jack 的部门名称与 dept 表实际不符合,现在我们想将 jack 的部门名称更新成 dept 表的正确数据,sql 如下:
sql复制代码update emp, dept set emp.dept_name = dept.dept_name
where emp.dept_id = dept.dept_id;
查询结果:
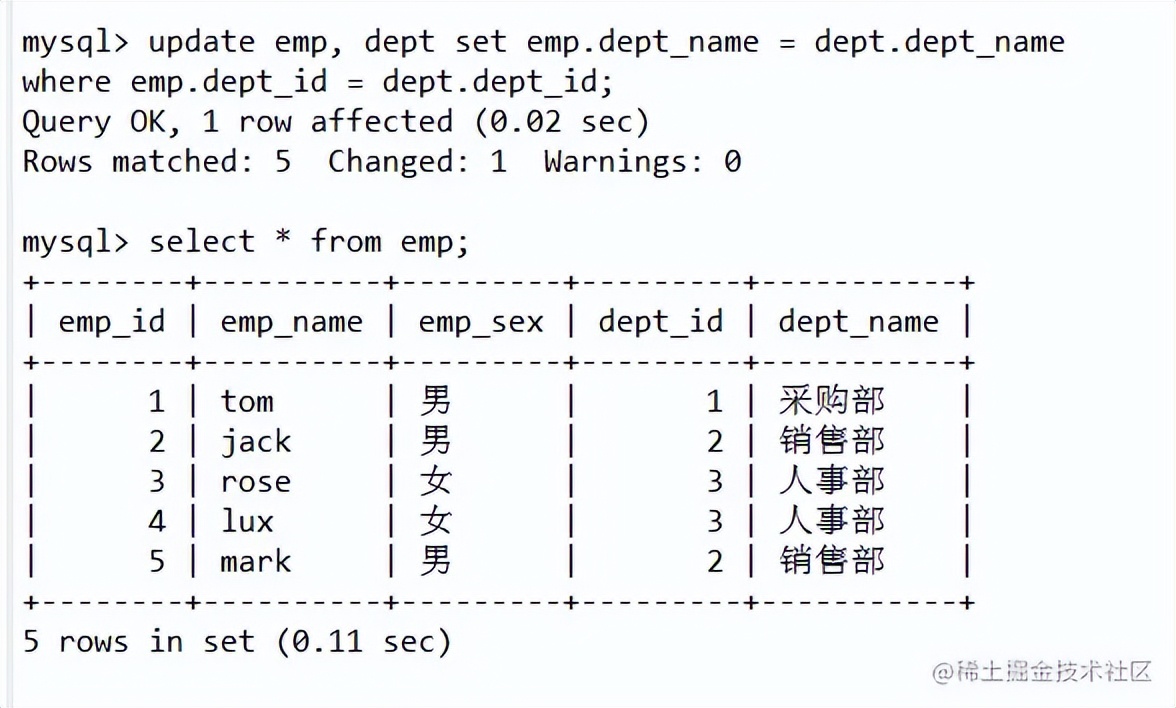
我们可以直接关联 emp 表和 dept 表并设置关联条件,然后更新 emp 表的 为 dept 表的 。
七、ORDER BY 空值 NULL 排序
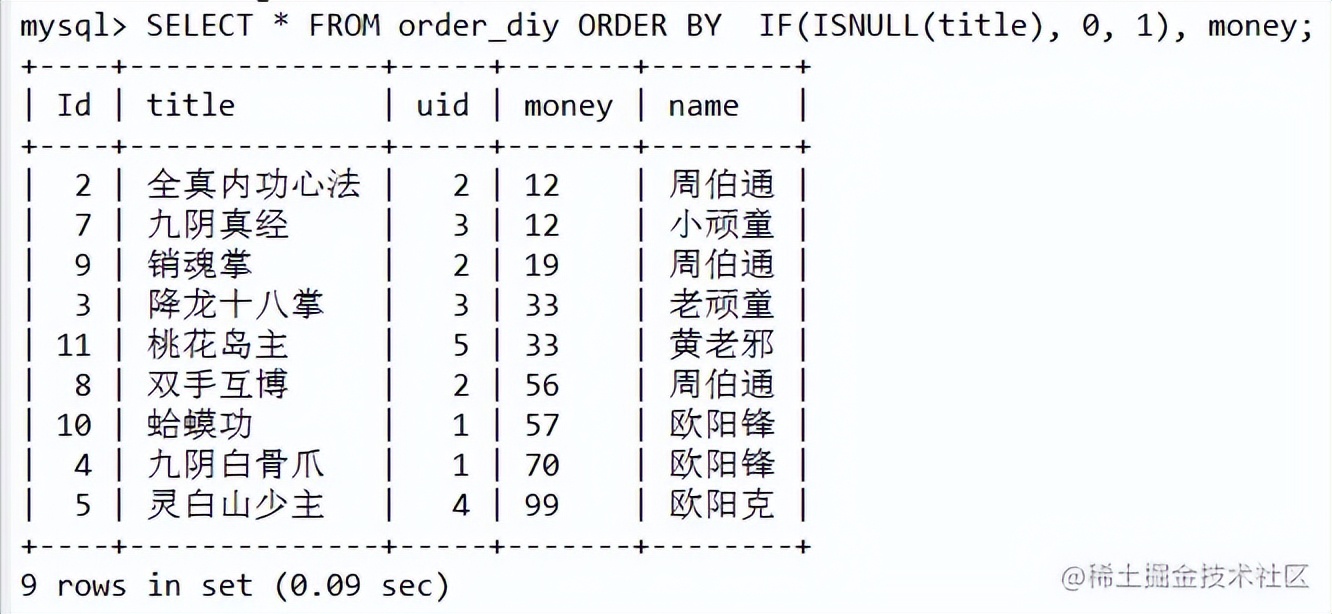
ORDER BY 字句中可以跟我们要排序的字段名称,但是当字段中存在 null 值时,会对我们的排序结果造成影响。我们可以通过 ORDER BY IF((title), 1, 0) 语法将 null 值转换成0或1,来达到将 null 值放到前面还是后面进行排序的效果。这里继续用 表举例,sql 如下:
sql复制代码SELECT * FROM order_diy ORDER BY IF(ISNULL(title), 0, 1), money;
查询结果:
八、with 分组统计数据的基础上再进行统计汇总
MySql 中可以使用 with 在分组统计数据的基础上再进行统计汇总,即用来得到 group by 的汇总信息。这里继续用 表举例,sql 如下:
sql复制代码SELECT name, SUM(money) as money
FROM order_diy GROUP BY name WITH ROLLUP;
查询结果:
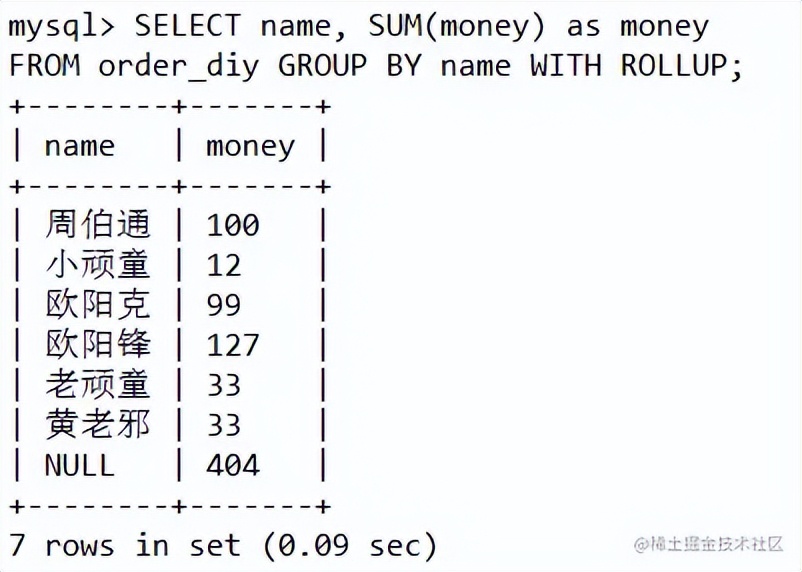
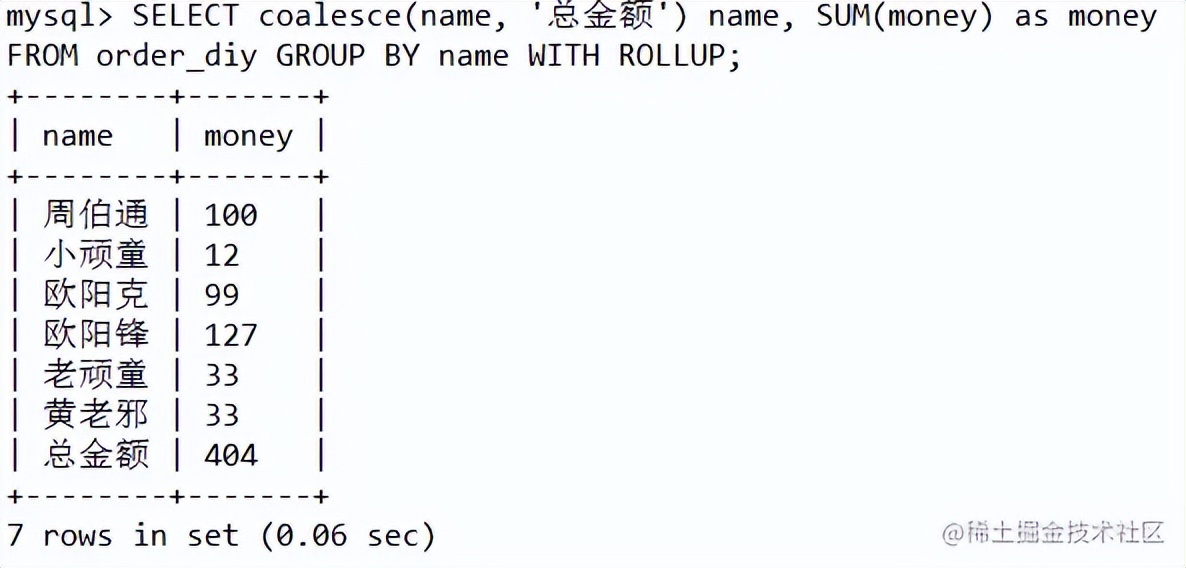
可以看到通过 GROUP BY name WITH 语句,查询结果最后一列显示了分组统计的汇总结果。但是 name 字段最后显示为 null,我们可以通过 (val1, val2, …) 函数,这个函数会返回参数列表中的第一个非空参数。
sql复制代码SELECT coalesce(name, '总金额') name, SUM(money) as money
FROM order_diy GROUP BY name WITH ROLLUP;
查询结果:
九、with as 提取临时表别名
with as 语法需要 MySql 8.0以上版本,它有一个别名叫做 CTE,官方对它的说明如下
公用表表达式 (CTE) 是一个命名的临时结果集,它存在于单个语句的范围内,稍后可以在该语句中引用,可以多次引用。
它的作用主要是提取子查询,方便后续共用,更多情况下会用在数据分析的场景上。
如果一整句查询中多个子查询都需要使用同一个子查询的结果,那么就可以用 with as,将共用的子查询提取出来,加个别名。后面查询语句可以直接用,对于大量复杂的SQL语句起到了很好的优化作用。这里继续用 表举例,这里使用 with as 给出 sql 如下:
sql复制代码-- 使用 with as
with t1 as (SELECT * from order_diy where money > 30),
t2 as (SELECT * from order_diy where money > 60)
SELECT * from t1
where t1.id not in (SELECT id from  t2) and t1.name = '周伯通';
查询结果:
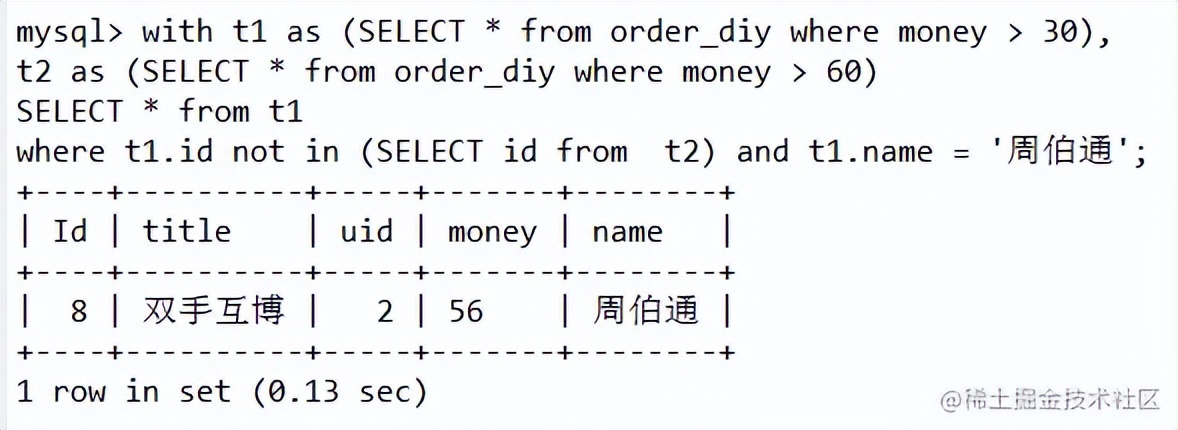
这个 sql 查询了 表中 money 大于30且小于等于60之间并且 name 是周伯通的记录。可以看到使用 CTE 语法后,sql写起来会简洁很多。
10、存在就更新,不存在就插入
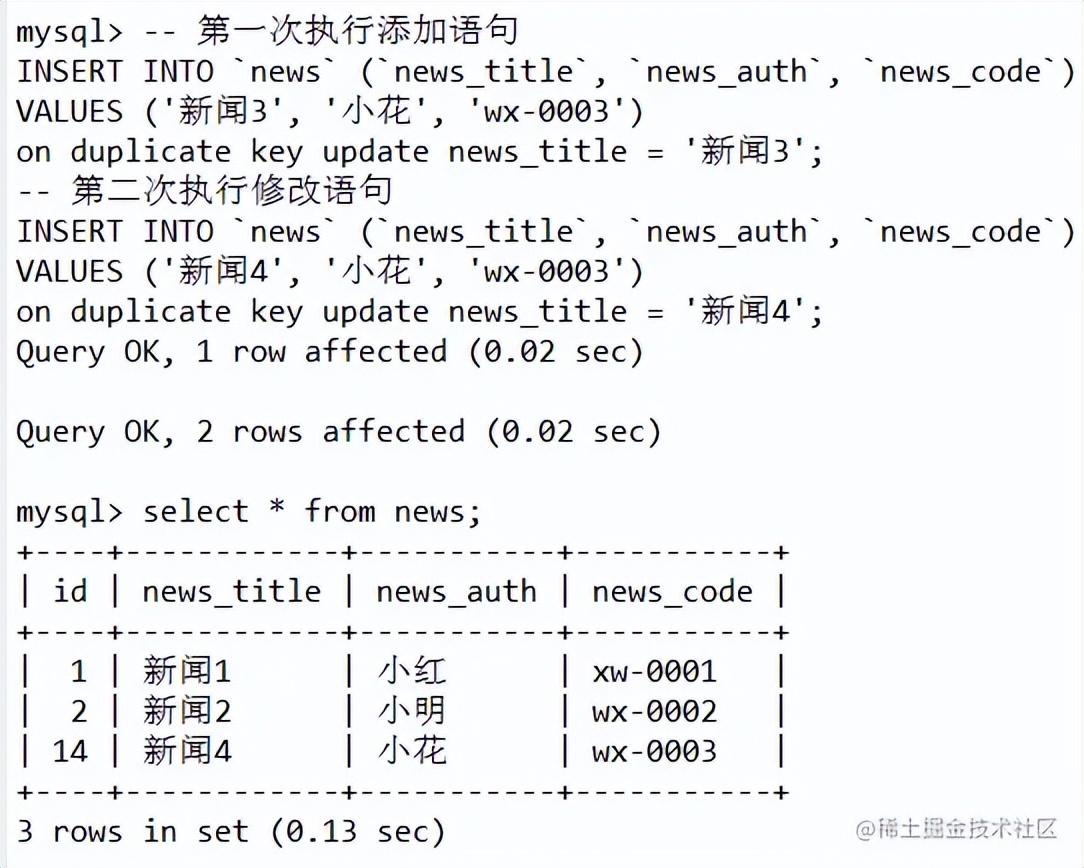
MySql 中通过on key 语法来实现存在就更新,不存在就插入的逻辑。插入或者更新时,它会根据表中主键索引或者唯一索引进行判断,如果主键索引或者唯一索引有冲突,就会执行on key 后面的赋值语句。 这里通过 news 表举例,表结构和说数据展示,其中 字段有唯一索引:
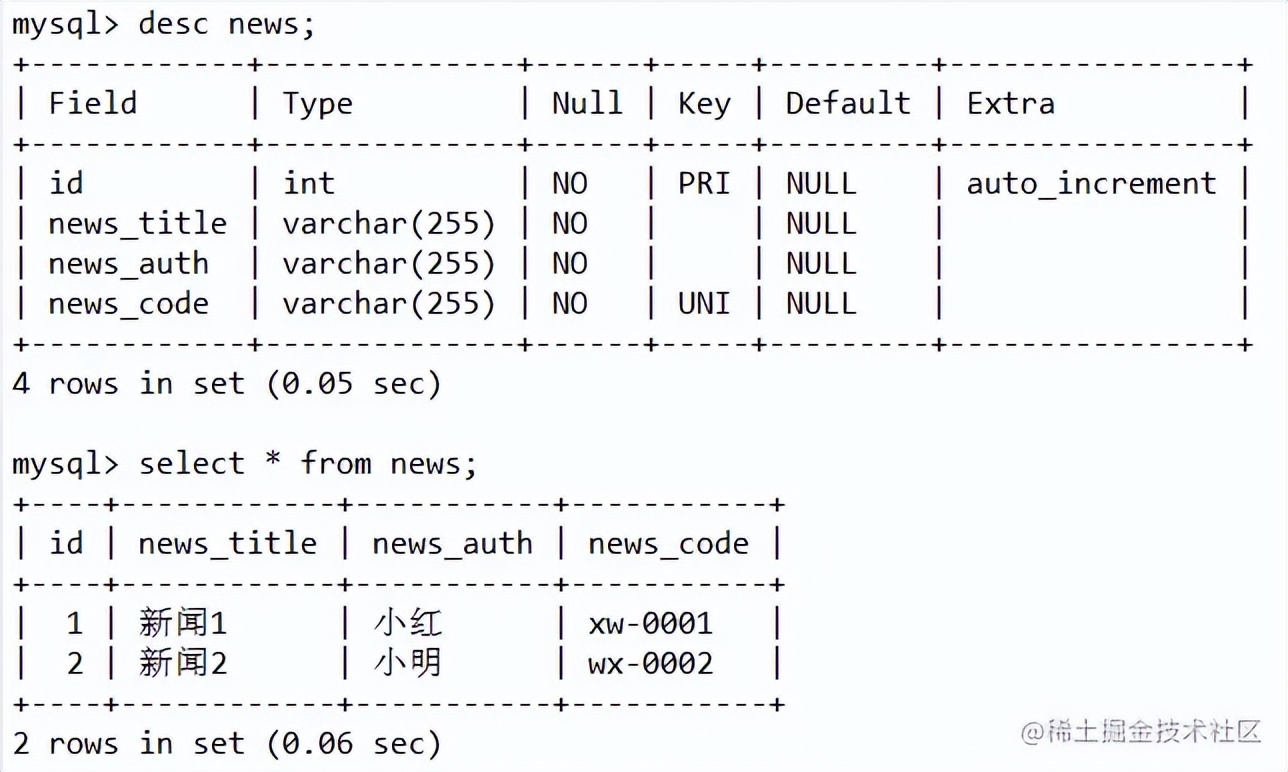
添加sql:
sql复制代码-- 第一次执行添加语句
INSERT INTO `news` (`news_title`, `news_auth`, `news_code`)
VALUES ('新闻3', '小花', 'wx-0003')
on duplicate key update news_title = '新闻3';
-- 第二次执行修改语句
INSERT INTO `news` (`news_title`, `news_auth`, `news_code`)
VALUES ('新闻4', '小花', 'wx-0003')
on duplicate key update news_title = '新闻4';
结果如下:
让你的SQL语句更加优雅高效:1️⃣ 优化
提到插入数据,我们自然是通过语句插入数据,而我们在往数据库中插入数据的时候,通常就是一条一条语句去执行,而插入多条数据呢,我们可以有哪些实现方式呢?
批量插入
因为每一次都需要与数据库建立连接和网络传输,因此对于多条数据,批量插入的效率优于普通的一条插入。
同时,批量插入的数据也不要太多,最好维持在500-1000条,如果有超过这么多条的,最好是分多次批量插入。
手动提交事务
在MySQL中,事务提交方式默认为自动提交,也就是说一条语句后,就会自动提交事务分享10个高级sql写法,再次执行一条就会再次开启事务,然后又提交,这样就会有事务频繁的开启与提交,因此最好是在插入之前开启事务,然后所有插入结束后提交事务。
mysql复制代码	start transaction; 开始事务
	insert ……; 插入数据1
	insert ……; 插入数据2
	insert ……; 插入数据3
	commit; 提交事务
主键顺序插入
主键插入,要么乱序插入,要么顺序插入,实际上顺序插入的性能更高,这取决于MySQL数据组织结构的,我们在后面的主键优化中会详细讲解。
顺序插入是指ID以升序的方式进行插入,比如1,2,3,4,5,6……
如果现在我们要导入百万级的数据,此时我们使用语句的性能就不高了,我们应该怎么做呢?
大批量插入数据
如果需要一次性插入大批量数据,使用语句插入的性能很低,此时我们可以使用MySQL数据库提供给我们的指令load进行插入,例如:
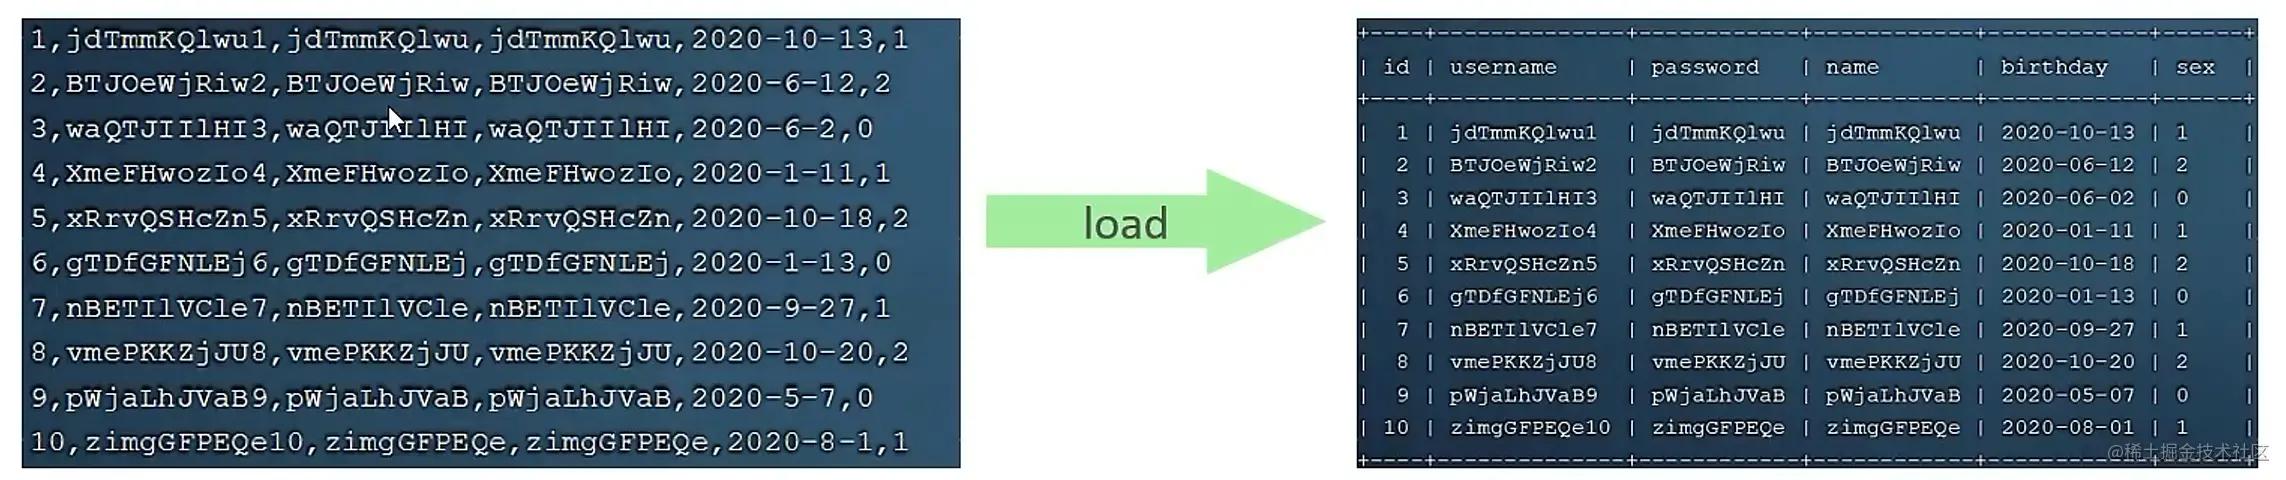
而我们如何使用这个功能呢,它有三部曲:
客户端连接服务端的时候,加上参数–local-
shell复制代码mysql --local-infile -u root -proot
设置全局参数 = 1,开启从本机加载文件导入数据的开关
mysql复制代码set global local_infile = 1
执行load指令,把准备好的数据加载到表结构中
mysql复制代码load data local infile `/root/sql1.log` into table `tb_user` fields terminated by ',' lines terminated by 'n';
2️⃣ 主键优化
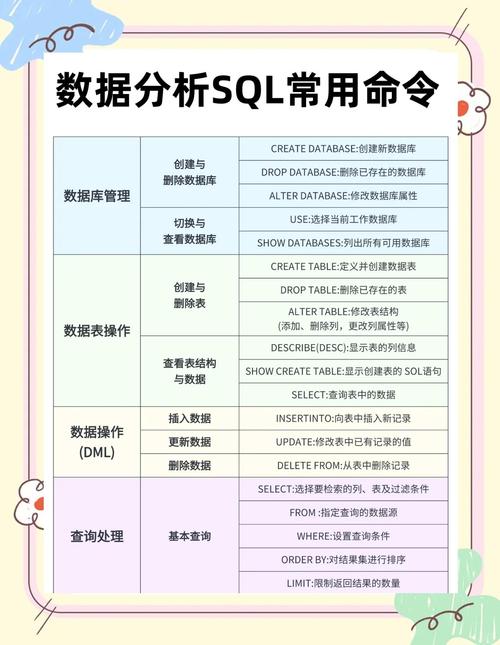
在讲解插入数据时的优化的时候,我们有提到主键插入的时候顺序插入的性能高于乱序插入的性能,至于为什么呢,我们将在这一小节详细讲解它的底层原理:
在此之前,我们首先需要了解存储引擎的数据组织方式:在存储引擎中,表数据是根据主键顺序组织存放的,这种存储方式的表称为索引组织表
在前文讲索引的时候我们有讲解过聚集索引,它的选取规则是在有主键的情况下,默认选择主键为聚集索引,也就是说,行数据存储在主键构成的索引的B+Tree中,如下图所示:
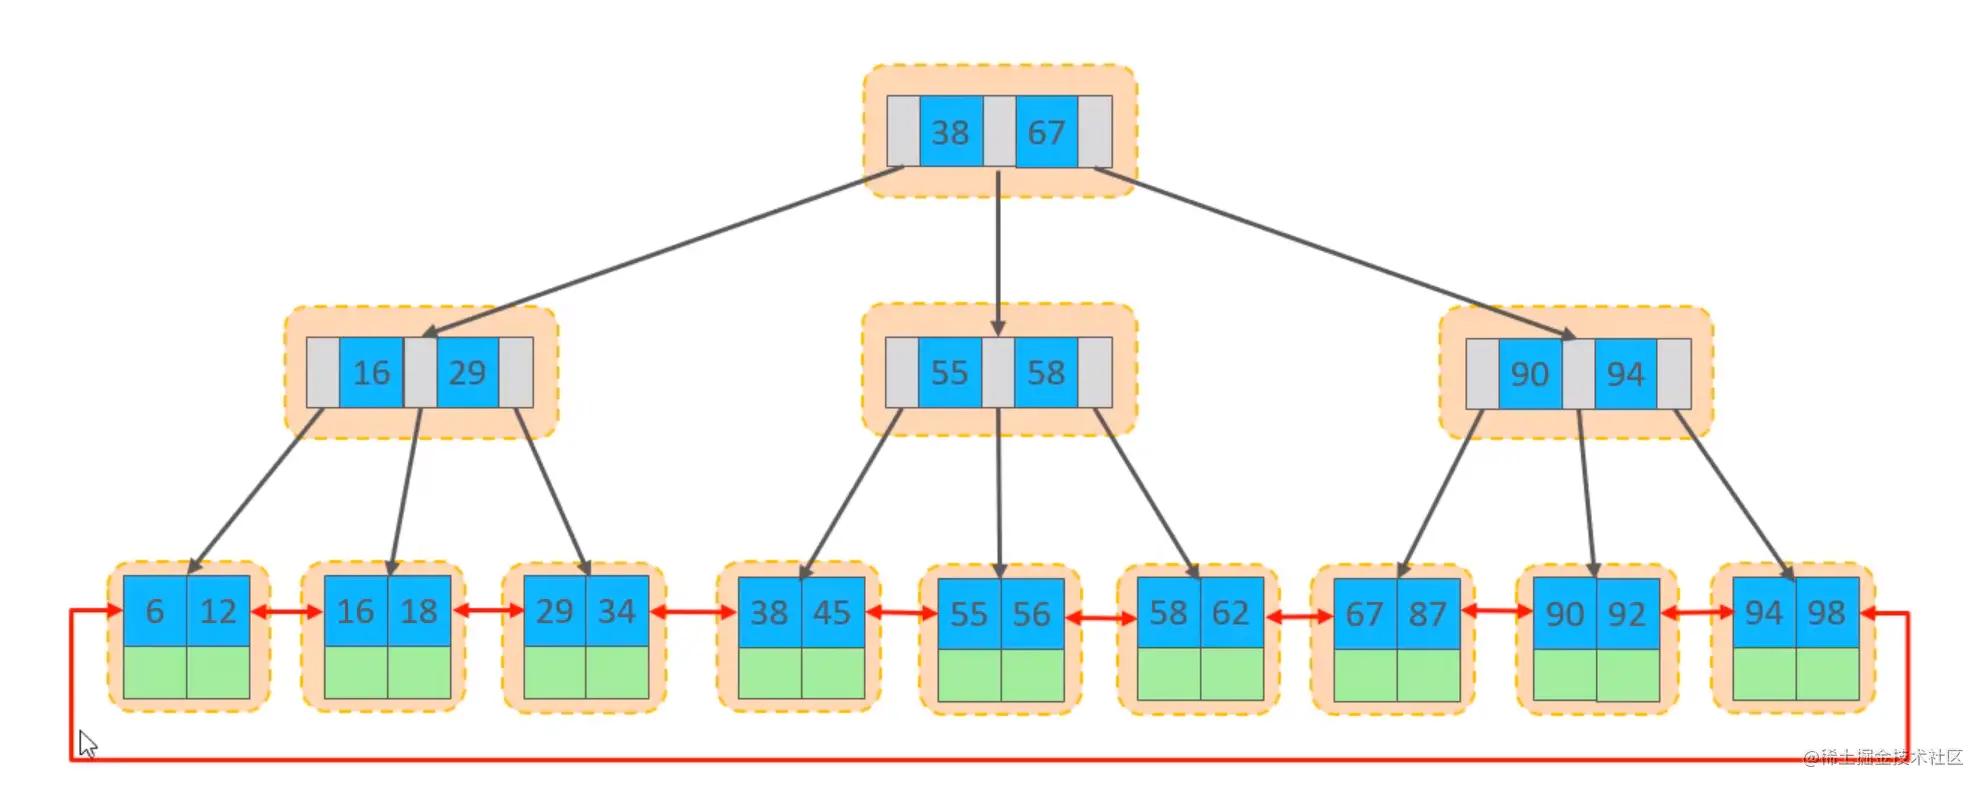
而索引构成的B+Tree在叶子结点顺序存放,也就是说:表数据是根据主键顺序组织存放的
此处,每一个结点,不管是分支结点还是叶子结点都是存储在一个页中,也就是我们之前提到的逻辑存储结构:
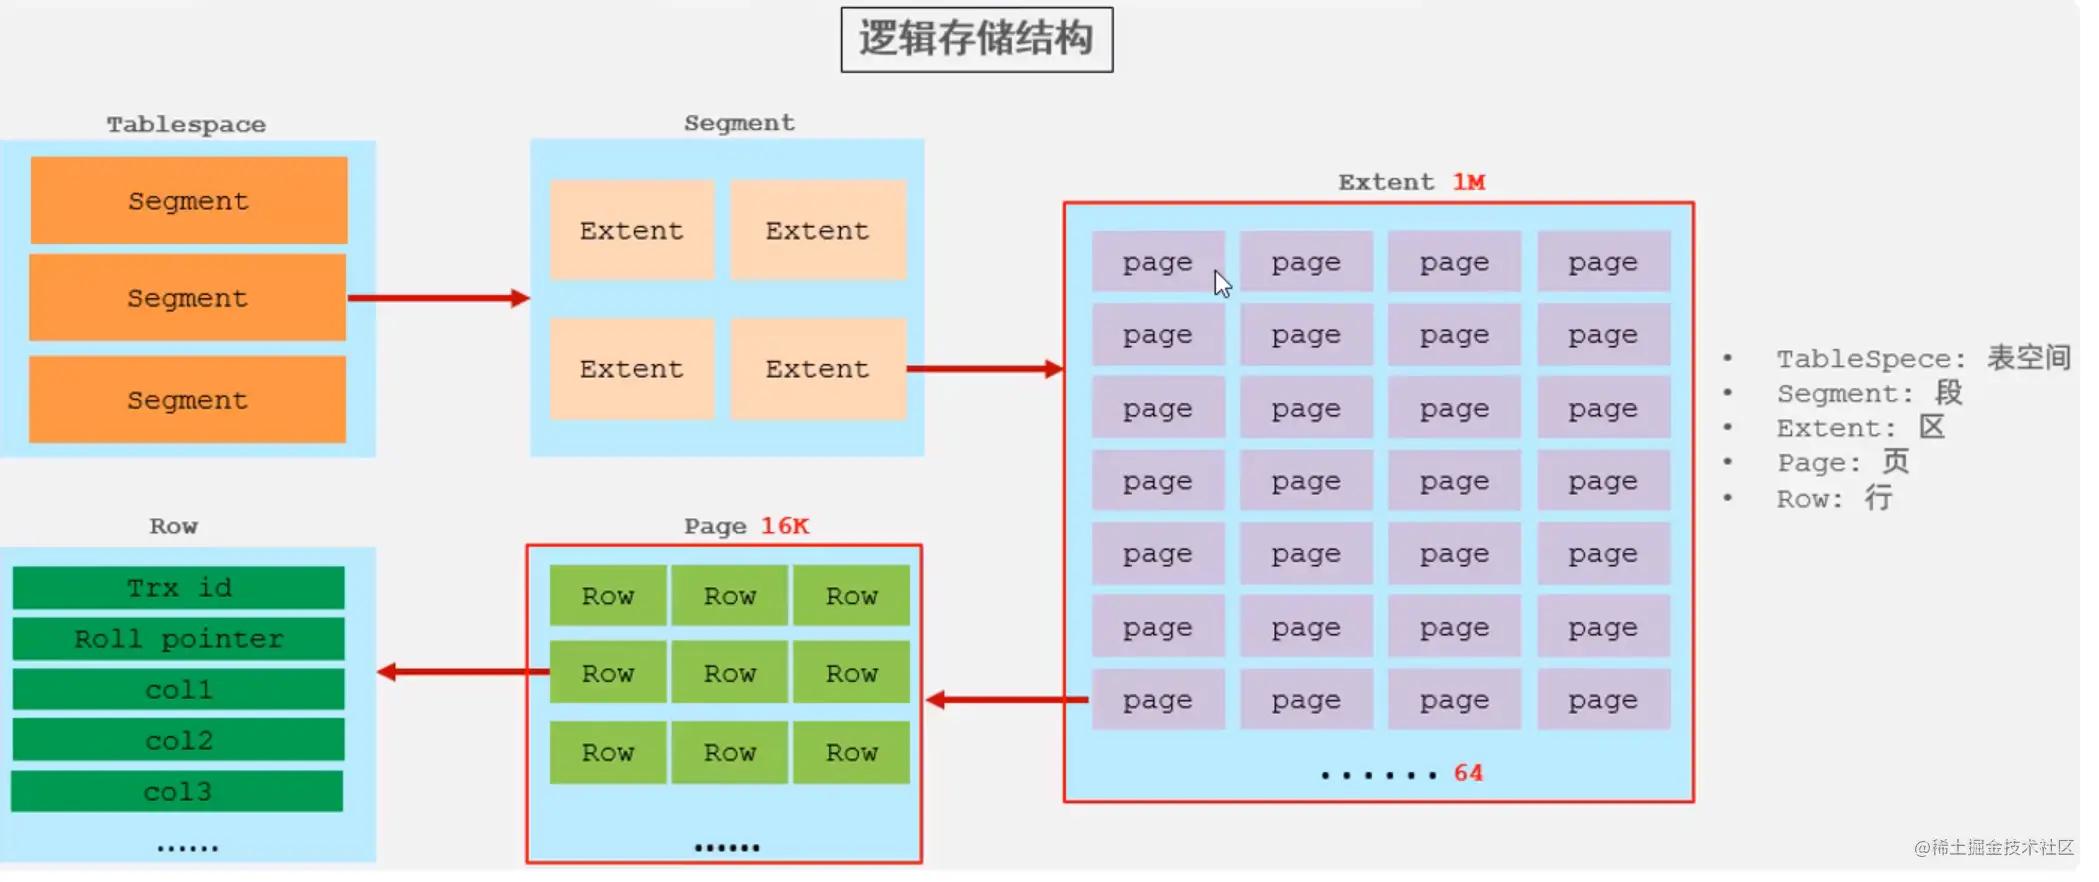
那么插入一条数据,在逻辑存储结构中是什么样的流程呢:
页分裂顺序插入
对于顺序插入,依次去写数据即可,如果一页的空间不足就去申请下一页的空间,并用双向指针连接,这就是主键顺序插入
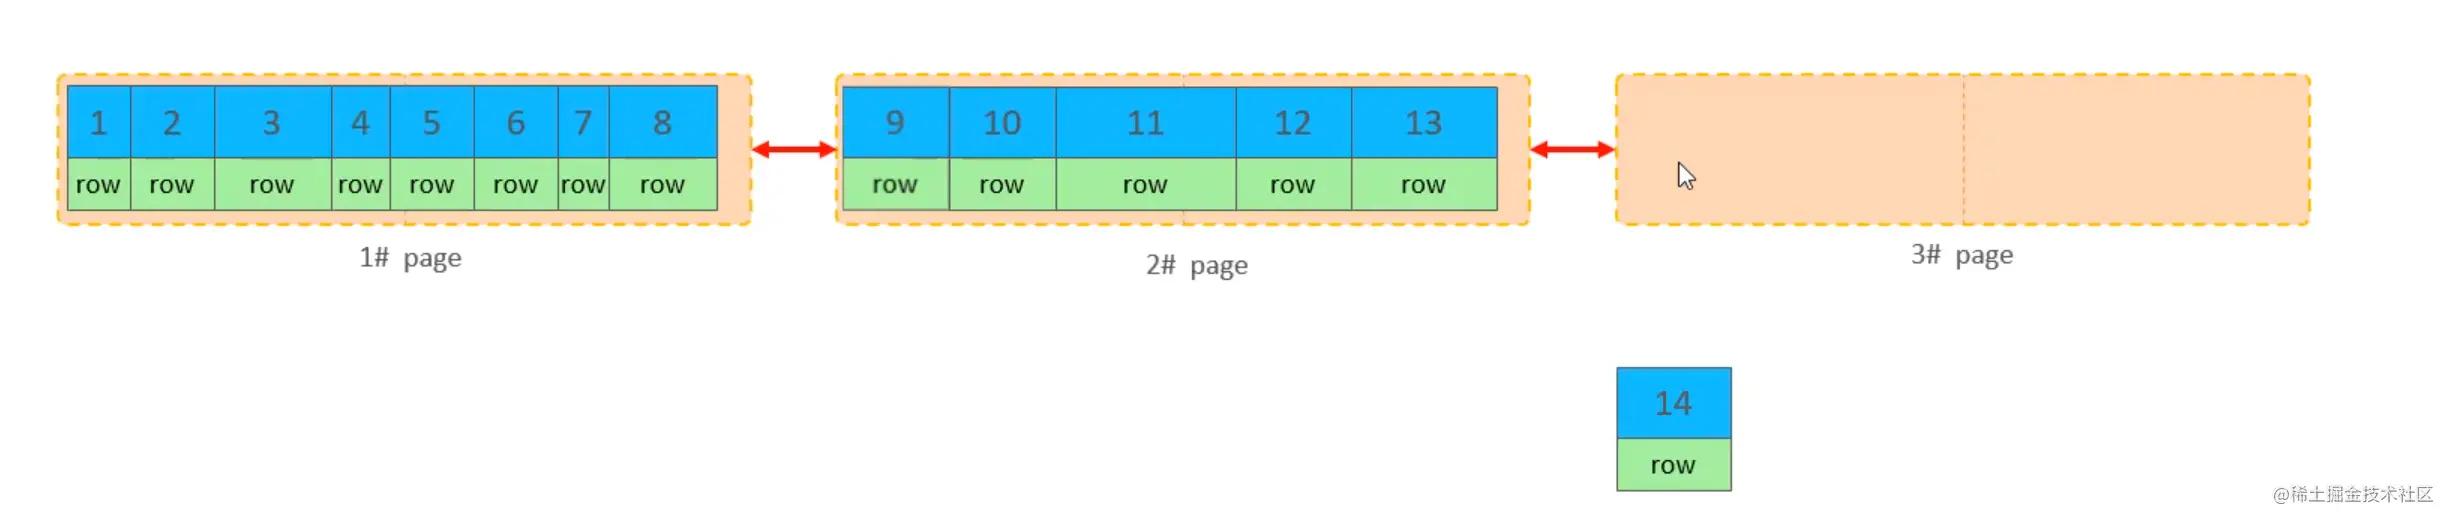
主键顺序插入基本上就是如果当前的最后一页有空间则填入,如果空间不足就放在下一页的空间使用双向链表连接保证它的有序
乱序插入
现在有两页写满了的数据:
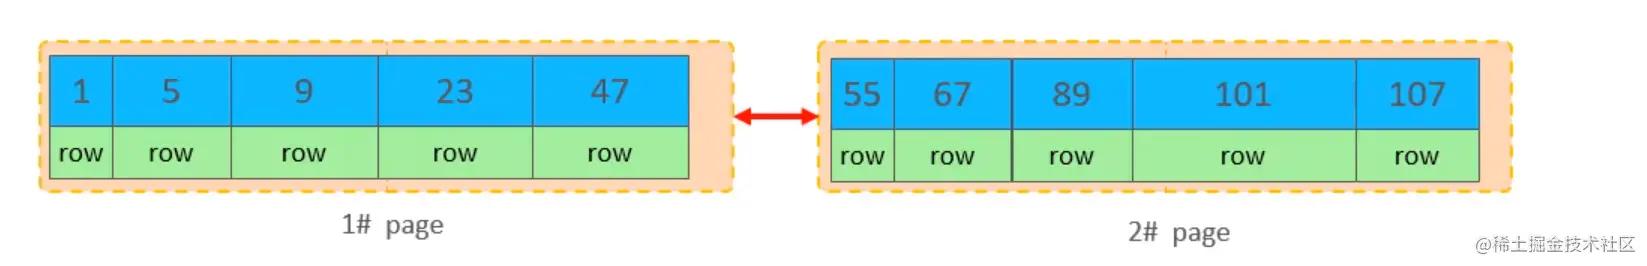
如果我们不是顺序插入,此时插入了一条主键为50的数据,此时就会出现页分裂:找到第一页的后半部分23,47申请新的一页放进去,然后把50放在新的一页的最后:
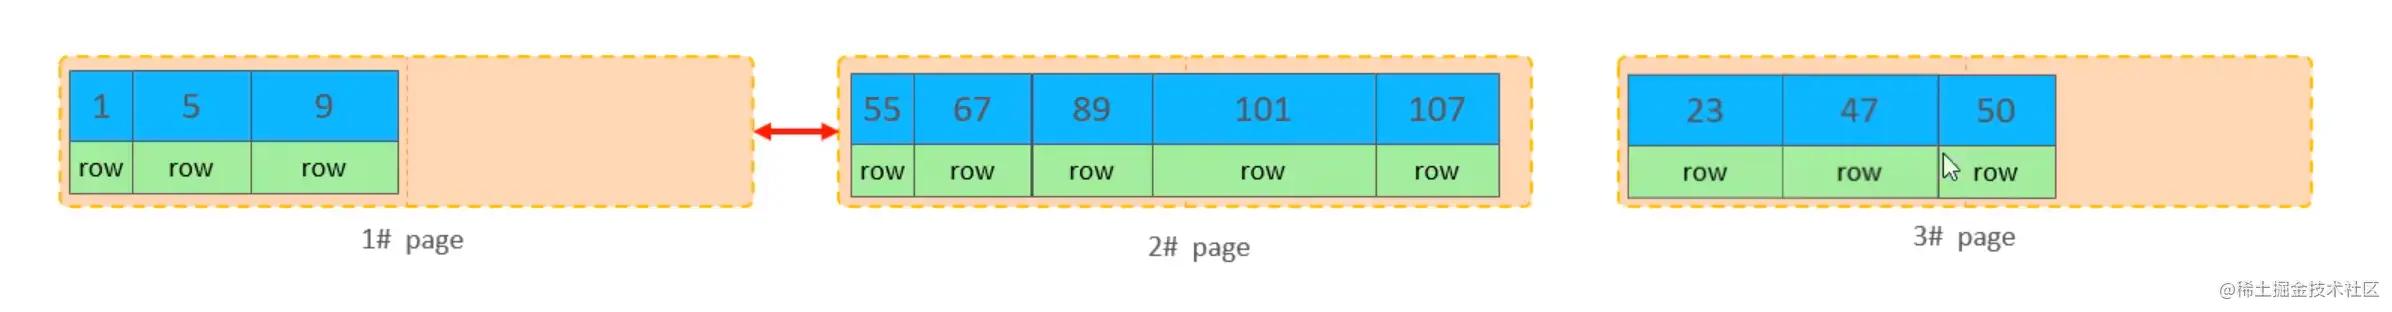
然后重新排列三页的位置:1#page 3#page 2#page
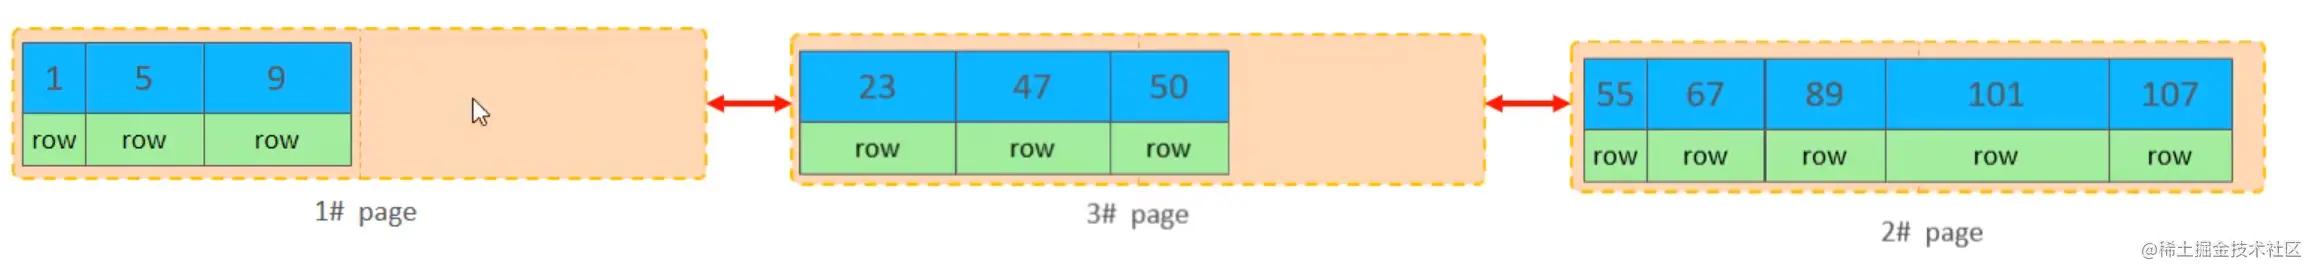
所以,其实我们可以发现,相较于顺序插入,乱序插入的过程更加复杂、繁琐,这种现象我们称之为页分裂,因此在插入的时候最好是按照主键顺序插入
页合并
有页分裂,自然也有页合并,否则,对于固定大小的一页来说,如果一页的空间利用率不高,将会造成冗余的内存占用,那么什么时候会出现业合并呢?
首先谈谈删除记录时,页中数据的变化,其实它有点类似于逻辑删除,在删除一条记录的时候,在实际上没有被物理删除,只是记录了被标记为删除,并且它的空间被允许其他记录声明使用,但是什么时候会被真正物理删除了,那就是业合并的时候:
当页中的记录达到(默认为50%) 的时候,存储引擎会开始寻找两边的页,是否能够达到合并的条件,如果能就会产生业合并,以达到优化空间的目的:
对于这种情况:
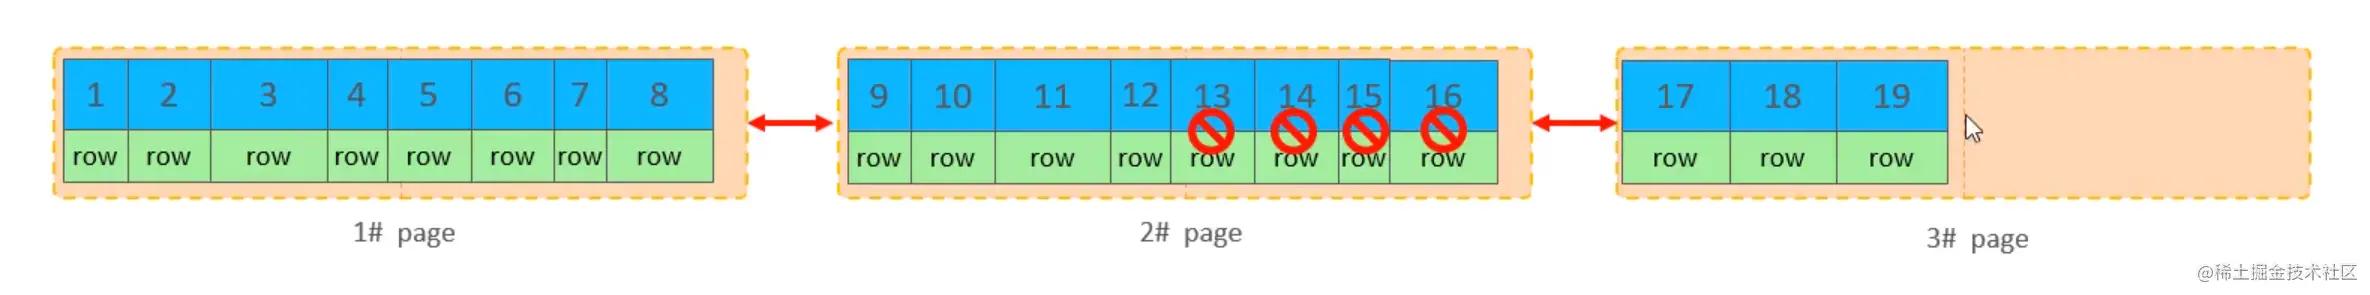
第二页的数据删除超过了一半,而在比对的时候,与前一页无法合并,但是能和第二页合并,于是就合并了两页的数据:
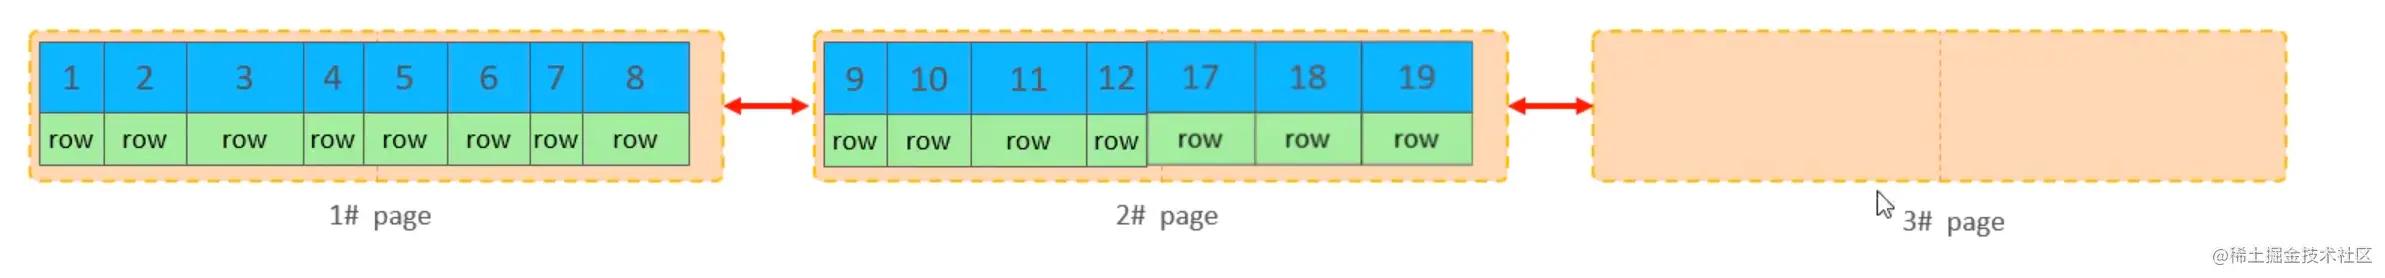
其中(默认为50%) 是可以自行设置的
主键设计原则
有了上面的前置知识,我们能总结出四点主键设计的原则,帮助我们在设计主键时避坑
尽量降低主键的长度
对于一张表来说,主键索引只有一个,但是会有很多个二级索引,如果说索引的长度比较长,二级索引比较多,那么在二级索引的叶子结点处会占用大量的磁盘空间sql 命令大全,而且在搜索的时候会耗费更多的磁盘IO
尽量顺序插入
插入数据的时候尽量选择顺序插入,并选用这种自增主键,这个我们在页分裂中有详细讲解
尽量不要使用自然主键
尽量不要使用UUID做主键或者其他自然主键,比如身份证号这种,我们每次生成的UUID都是无序的,那么就会导致在插入的时候产生乱序的插入,同样,UUID也比较长
尽量不要修改主键
业务操作的时候,尽量少修改主键,因为会伴随着索引结构的修改,不过在一般的业务里面,也没人改主键吧
3️⃣ Order by 优化
对于MySQL中的排序有两种方式sql 命令大全,那可能有朋友就疑惑了,那排序不就Order by嘛,哪来的两种方式,实际上这里的两种方式指的是底层实现的两种方式:
Using
通过表的索引或者全表扫描,读取满足条件的数据行,然后在排序缓冲区sort 完成排序操作,所有不是通过索引直接返回排序结果的排序都叫排序
Using index
通过有序索引顺序扫描直接返回有序数据,这种情况即为using indexsql 命令大全,不需要额外排序,操作效率高。
我们不妨来猜一猜一下几组情况的索引使用情况,已知存在联合索引age,phone,问下面哪些SQL查询使用到了索引,哪些没有使用到:
id,age,phone from order by id,age,phone from order by age, id,age,phone from order by age desc ,phone id,age,phone from order by phone, id,age,phone from order by age asc ,phone desc
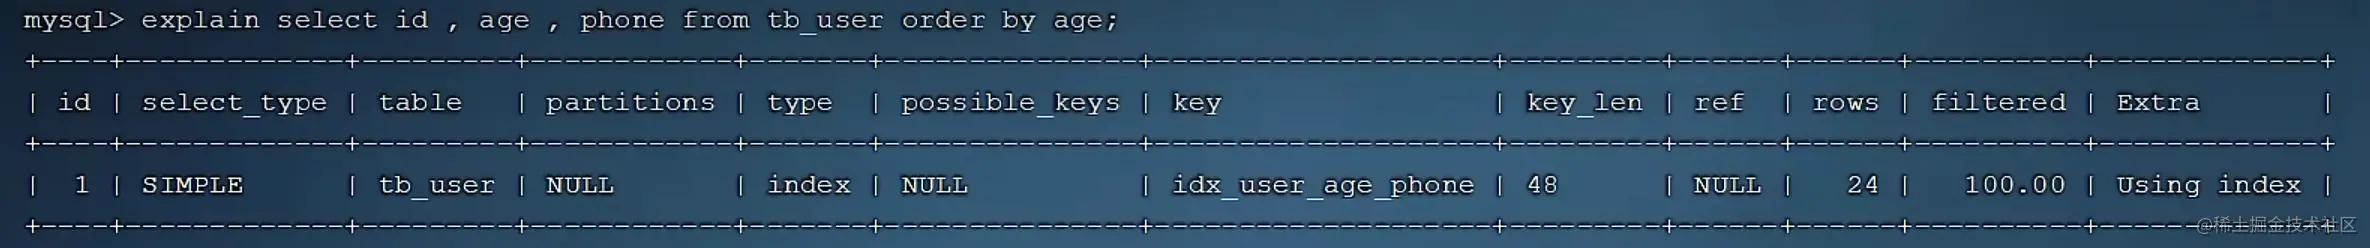
第一个,按照最左前缀法则,联合索引的最左边是age,因此使用了索引排序
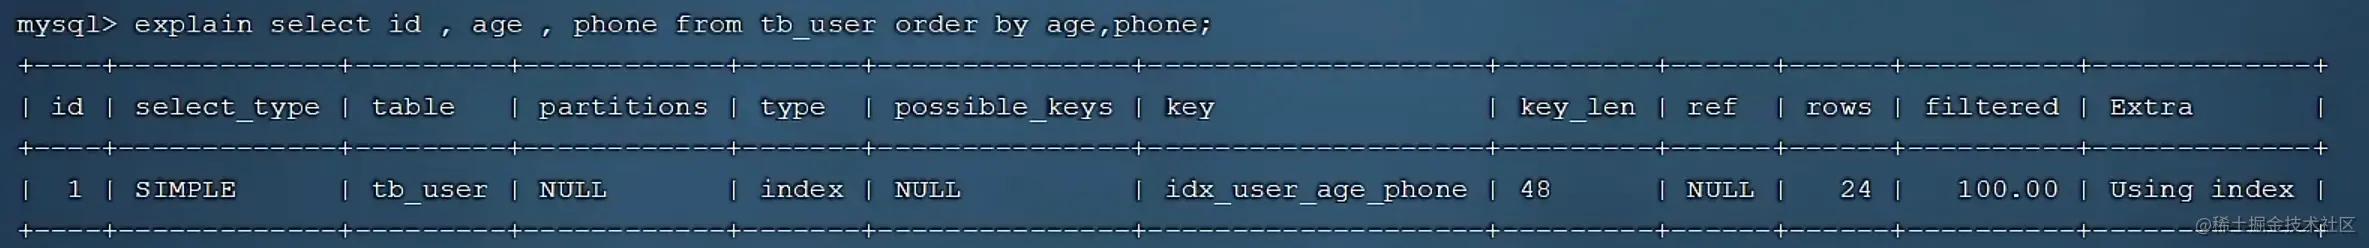
第二个,使用联合索引进行排序分享10个高级sql写法,毋庸置疑

第三个,如果二者都查倒序排序,此时尽管还是使用了索引,但是多了一个 index scan,也就是说从索引的最后面开始扫描

我们只需要从最后那个叶子结点往回扫描即可

第四个,如果说联合索引的顺序反了,我们在讲最左前缀法则的时候,尽管顺序反了,索引也是能够使用了,是因为那个是 where 条件,没有先后顺序,只有书写顺序,但是对于order,书写顺序就代表了先后顺序,先对哪个进行排序。

第五个,在创建索引的时候,默认按照升序往后走,也就是说先按照age进行升序排列,再按照phone进行升序排列,而此处查找的时候,按照age升序排序,按照phone降序排序,因此就会不完全使用索引。

这张图其实能帮助我们很好的理解为什么不能一个升序一个降序,索引无法按照这个去排列
这里也说了,在创建索引的时候我们默认按照升序排序,那我们按照降序排序创建索引应该怎么创建呢? 其实只需要在字段的后面加上asc / desc即可:
INDEX d on (age asc, phone desc)

在创建结束后,我们再次去查询,得到的就是使用索引排序了:

总结根据排序字段建立合适的索引,多字段排序的时候,也遵循最左前缀法则。尽量使用覆盖索引,减少回表查询多字段排序的时候,注意联合索引在创建时的规则如果不可避免出现,我们可以适当增加排序缓冲区的大小,因为如果缓冲区满了,它就会去磁盘空间进行排序,效率很低4️⃣ Group by 优化
与Order by相比,其实二者很像,因为二者都是需要排序,但是Group by多了一个分组
它使用索引的条件是,也就是按照索引进行分组的时候,但是有一个情况是和联合索引有一些出入的:

对于这种情况,我们通过分析可以发现,这个居然使用到了索引,原因是这里有使用到作为查询条件,然后根据年龄进行分组
总结
到这里,本文所分享的10个高级sql写法就全部介绍完了,希望对大家日常开发 sql 编写有所帮助,喜欢的朋友们可以点赞加关注。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » 分享10个高级sql写法

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码