双旋网络
java queue length Java 集合 知识整理 和 面试

java queue length Java 集合 知识整理 和 面试
一、Java 集合体系结构
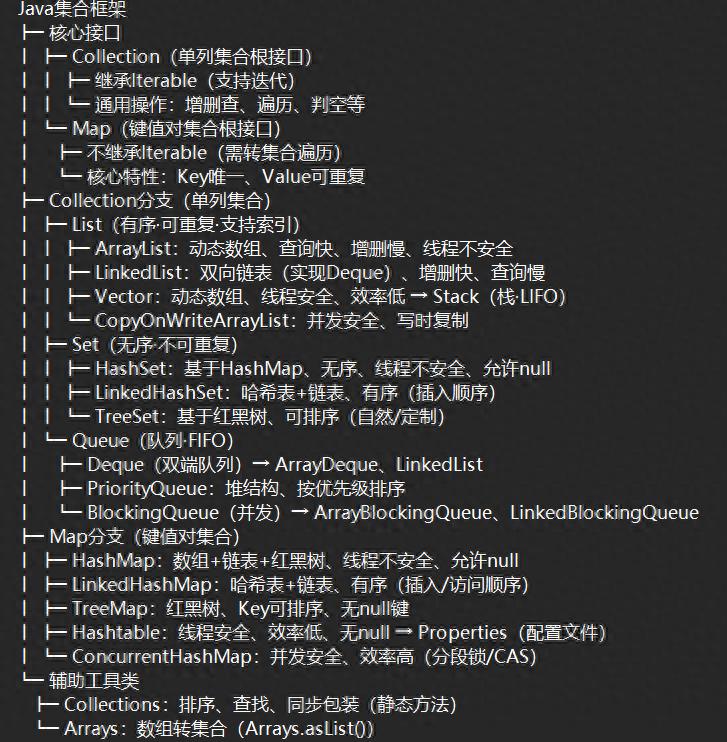
核心分为 (单值集合) 和 Map(键值对集合) 两大分支,顶层接口 提供遍历能力,整体结构如下(标注核心特性):
Java 集合框架
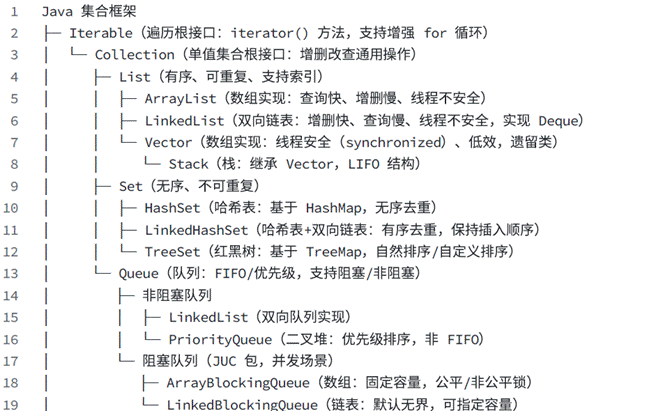
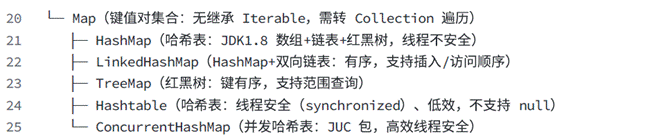
核心说明:
1. 与 Map 分离:Map 不实现 ,需通过 ()/()/() 转换为 后遍历。
2. 线程安全划分:
○ 非并发集合:、、 等(效率高,多线程易出问题);
○ 并发集合:、、 等(JUC 包,高效安全);
○ 遗留同步集合:、(全局锁,效率低,仅兼容旧代码)。
二、核心接口与实现类详解(补充细节+避坑点)
(一) 接口通用方法
所有单值集合的基础操作,无需记忆,重点关注 遍历相关 和 批量操作:
• 增:add(E e)(成功返回 true,Set 重复时返回 false)、();
• 删:( o)、()、clear();
• 查:size()、()、( o)、();
• 批量判断:()、()(交集)。
(二)List 接口:有序可重复(面试重点)
1. (高频考点)
• 底层:动态扩容的 (JDK1.8 延迟初始化)。
• 核心特性:
○ 查询 O(1)(索引直接访问),增删 O(n)(需移动元素),尾部增删接近 O(1)(无扩容时);
○ 线程不安全:多线程修改会触发
(快速失败)。
• 扩容机制(JDK1.8 重点):
○ 初始容量:默认 10(首次 add() 时初始化数组,避免空集合占用内存);
○ 扩容阈值: * (默认负载因子 0.75,平衡空间与冲突);
○ 扩容逻辑:旧容量 > 1));
○ 避坑点:指定初始容量时(如 new (20)),仍延迟初始化,仅在首次 add 时创建 20 容量数组。
2. (高频考点)
• 底层:双向链表(Node 节点含 prev/item/next 指针),实现 Deque 接口。
• 核心特性:
○ 增删 O(1)(仅改指针,需找到目标节点),查询 O(n)(遍历链表);
○ 可作为 双向队列(()/())、栈(push()=,pop()=);
○ 避坑点:get(int index) 效率极低(遍历链表),切勿用普通 for 循环遍历 。
3. vs (对比强化)
特性
线程安全
是(方法加 ,全局锁)
扩容机制
默认 2 倍,支持指定扩容增量(new (10, 5))
固定 1.5 倍,不支持增量
初始化时机
构造时立即初始化(默认容量 10)
延迟初始化(首次 add 时)
核心缺点
效率低、内存浪费(扩容倍数大)
线程不安全,扩容时复制开销
适用场景
遗留系统、无并发集合可用的场景
单线程/线程安全可控的场景
(三)Set 接口:无序不可重复(去重逻辑是核心)
1. (高频考点)
• 底层:基于 (元素作为 key,value 是固定常量 )。
• 核心特性:
○ 无序(存储顺序 ≠ 插入顺序),允许 1 个 null(key 不可重复);
○ 去重原理(面试必问):
i. 计算元素的 (),得到数组索引;
ii. 若索引位置无元素,直接存入;
iii. 若索引位置有元素(哈希冲突),通过 () 比较:
• () 为 true → 重复,不存入;
• () 为 false → 存入链表/红黑树。
○ 避坑点:自定义类作为 元素时,必须同时重写 () 和 (),否则无法正确去重(默认用 类的地址比较)。
2.
• 底层: + 逻辑(哈希表保证去重,双向链表保证有序)。
• 特性:保持插入顺序,遍历效率比 略低(维护链表开销),适合需有序去重的场景。
3.
• 底层:基于 (元素作为 key,红黑树排序)。
• 核心特性:
○ 有序(自然排序/自定义排序),不允许 null(排序时抛 );
○ 排序方式:
自然排序:元素实现 接口,重写 (T o);
自定义排序:创建时传入 接口实现类(如 new ((::)));
○ 去重逻辑:通过排序接口判断,()/() 返回 0 则视为重复。
(四)Map 接口:键值对集合(面试核心)
1. (重中之重)
• 底层结构(JDK1.7 vs 1.8):
○ JDK1.7:数组 + 链表(拉链法),哈希冲突严重时查询退化至 O(n);
○ JDK1.8:数组 + 链表 + 红黑树(链表长度 ≥8 且数组容量 ≥64 时树化,节点数 ≤6 时退化为链表),查询优化至 O(log n)。
• 核心特性:
○ 无序,key 不可重复(重复覆盖 value),允许 1 个 null key、多个 null value;
○ 线程不安全(多线程 put 可能数据覆盖、JDK1.7 扩容链表死循环)。
• 关键流程(JDK1.8):
a. put 流程:
计算 key 哈希值:hash(key)(对 扰动,减少冲突:(key == null) ? 0 : (h = key.()) ^ (h >>> 16));
计算索引:(n – 1) & hash(n 为数组容量,必须是 2 的幂,保证索引合法);
处理冲突:
• 索引为空 → 新建 Node 存入;
• 索引非空 → key 相同则覆盖 value;
• 红黑树节点 → 红黑树插入;
• 链表节点 → 尾插,插入后判断是否树化;
扩容判断:size > 阈值( * 0.75)→ 扩容为 2 倍。
b. get 流程:索引定位 → 节点匹配(hash + )→ 返回 value,无则返回 null。
2.
• 底层: + 双向链表(维护节点顺序)。
• 核心特性:
○ 有序:默认插入顺序,可指定访问顺序(new (16, 0.75f, true));
○ 访问顺序应用:LRU 缓存(最近访问的节点移到链表尾部,最久未访问的在头部)。
3. vs vs (对比优化)
特性
(JDK1.8)
线程安全
是(全局 锁)
是(节点级 + CAS)
null 支持
key/value 均可为 null
均不可为 null
key/value 均可为 null
底层结构
数组+链表+红黑树
数组+链表
数组+链表+红黑树
扩容机制
1.5 倍(≥16)
2 倍
1.5 倍
并发效率
高(单线程)
低(全局锁)
高(锁粒度细,支持多线程扩容)
快速失败
支持( 校验)
支持
不支持(弱一致性)
适用场景
单线程键值对存储
遗留代码兼容
并发场景键值对存储
4.
• 底层:红黑树(自平衡二叉搜索树)。
• 特性:键有序(自然排序/自定义排序),支持范围查询(()/()),不允许 null key。
(五)Queue 接口:队列(重点在并发场景)
1.
• 底层:二叉小顶堆(默认自然排序)。
• 特性:非 FIFO,队首是最小/最大值,不支持 null,线程不安全;
• 扩容:容量
2. (并发核心)
• 核心能力:阻塞插入(队列满时等待)、阻塞获取(队列空时等待),无需手动处理线程同步;
• 常用实现:
○ :数组实现,固定容量,公平锁(按线程等待顺序)可选;
○ :链表实现,默认无界(实际 .),建议指定容量避免 OOM;
• 适用场景:生产者-消费者模型(如日志收集、任务分发)。
三、核心知识点补充(强化理解+避坑)
(一)遍历方式对比(表格更清晰)
遍历方式
适用场景
优点
缺点
迭代器()
所有 集合
支持遍历中安全删除(())
语法略繁琐
增强 for 循环
所有 集合
语法简洁
不支持遍历中删除(抛快速失败)
普通 for 循环
仅 List(支持索引)
可手动控制索引
中效率极低(O(n))
Map 专属遍历
Map 集合( 最优)
() 直接获取键值对
() 需二次 get(低效)
(二)快速失败(fast-fail)vs 安全失败(fail-safe)
1. 快速失败(fast-fail)
• 触发条件:遍历非并发集合(/)时,其他线程修改集合,或当前线程调用集合 ()(非迭代器 ());
• 原理:集合维护 (修改次数),迭代器创建时记录 = ,遍历中若两者不等,抛
;
• 注意:快速失败是「检测机制」,不是「线程安全保证」,仅用于调试。
2. 安全失败(fail-safe)
• 触发条件:遍历并发集合(
/);
• 原理:迭代器遍历的是集合「副本」( 写时复制原数组java queue length Java 集合 知识整理 和 面试, 分段锁无锁遍历);
• 缺点:弱一致性(副本与原集合可能不同步)、内存开销大(复制数组)。
(三)集合工具类(重点用法+避坑)
1. (操作集合的静态工具类)
• 核心方法:
○ 排序:sort(List)/sort(List, )(需元素实现 或传入 );
○ 线程安全包装:(List)(给非线程安全集合加锁,效率低于 JUC 并发集合);
○ 不可变集合:()/(List)(不可增删改,避免外部修改);
○ 查找:(List, key)(需先排序,否则结果无效)。
2. (操作数组的工具类)
• 核心方法:
○ 数组转集合:(T… a)(返回内部类 ,固定长度,不可增删,修改会同步原数组);
○ 避坑:(new int{1,2,3}) 返回 List(基本类型数组视为一个对象),需用包装类数组()。
(四)并发集合补充(JUC 包)
并发集合
底层原理
适用场景
写时复制数组(读无锁,写加锁)
读多写少(如配置缓存)
基于
读多写少的去重场景
e
无锁 CAS 实现
高并发非阻塞队列
链表+阻塞锁
生产者-消费者模型
(五)自定义 key 规范(面试必问)
当自定义类作为 / 的 key 时,必须重写 () 和 ()java queue length,遵循以下原则:
1. () 相等 → () 必须相等(保证相同元素哈希值一致,不重复存储);
2. () 相等 → () 不一定相等(哈希冲突允许,通过 () 进一步判断);
3. 未重写时,默认使用 类的方法(基于对象地址,无法正确去重)。
四、高频面试题及解析(分难度+抓考点)
(一)基础题(理解核心区别)
1. 和 的区别?
• :单值集合的根接口,定义通用操作(add/),子类有 List/Set/Queue;
• :操作集合的静态工具类,提供排序、查找、线程安全包装等方法,不可实例化。
2. List 和 Set 的核心区别?
维度
List
Set
有序性
插入顺序 = 存储顺序(有序)
无序()/有序(/)
重复性
可重复
不可重复
索引访问
支持(get(int index))
不支持(需迭代器)
去重机制
+()/排序接口()
3. 数组和 的区别?
• 数组:固定长度java queue length,支持基本类型+引用类型,无内置操作方法;
• :动态扩容,仅支持引用类型(基本类型自动装箱),提供丰富操作(add//sort);
• 联系: 是数组的「动态包装」,底层依赖数组实现。
(二)进阶题(底层原理+流程)
1. 的底层实现(JDK1.7 vs 1.8)?
• JDK1.7:数组 + 链表(拉链法),存在问题:哈希冲突严重时查询 O(n),多线程扩容易形成链表死循环;
• JDK1.8 优化:
a. 结构升级:数组 + 链表 + 红黑树(链表长度 ≥8 且数组 ≥64 时树化);
b. 哈希函数优化:扰动更充分(高 16 位异或低 16 位),减少冲突;
c. 扩容优化:无需重新计算哈希值,仅判断高位是否为 1(因容量是 2 的幂);
d. 插入优化:链表尾插(JDK1.7 头插,易导致死循环)。
2. 的哈希冲突解决方式?
• 哈希冲突:不同 key 计算出相同哈希值,导致数组同一位置存储多个元素;
• 解决方式:拉链法( 核心):数组每个位置挂载链表/红黑树,冲突元素依次存储;
• 其他方式(未采用):
○ 开放地址法:冲突后探测下一个空闲位置(线性探测/二次探测),适合数据量小、冲突少的场景;
○ 再哈希法:多次哈希计算不同索引,效率低。
3. 和 的适用场景?
• :读多写少、频繁索引访问(如列表展示、数据查询);
• :写多读少、频繁增删首尾(如队列/栈操作、消息队列);
• 避坑:切勿用 做随机访问(get(index)),效率极低。
4. 的排序原理?
• 底层依赖 的红黑树结构java queue length,排序核心是「比较接口」:
a. 自然排序:元素实现 接口java queue length Java 集合 知识整理 和 面试,重写 (T o)(返回负数/0/正数表示小于/等于/大于);
b. 自定义排序:创建 时传入 接口(重写 (T o1, T o2));
• 去重逻辑:比较结果为 0 则视为重复元素,不存入。
(三)高阶题(并发+实战)
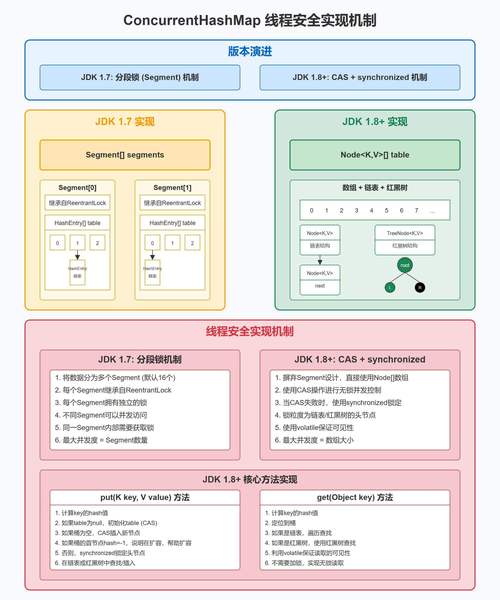
1. 的底层实现(JDK1.7 vs 1.8)?
维度
JDK1.7
JDK1.8
底层结构
数组 + 链表
数组 + 链表 + 红黑树
锁机制
分段锁( 是 )
节点级锁()+ CAS
扩容方式
每个 独立扩容
多线程协同扩容(CAS 标记转移节点)
并发效率
中等(锁粒度:)
高(锁粒度:节点)
2. 的实现原理及优缺点?
• 原理:读写分离,写时复制(Copy-On-Write):
○ 读操作:无锁,直接访问原数组;
○ 写操作:加锁 → 复制原数组 → 新数组修改 → 替换原数组引用 → 解锁;
• 优点:读操作高效(无锁),遍历安全(不抛快速失败);
• 缺点:写操作开销大(复制数组),弱一致性(迭代器遍历副本);
• 适用场景:读多写少(如配置中心、字典表)。
3. 如何实现 LRU 缓存?(面试实战)
LRU(最近最少使用):淘汰最久未使用的元素,核心用 实现(访问顺序模式):
Java
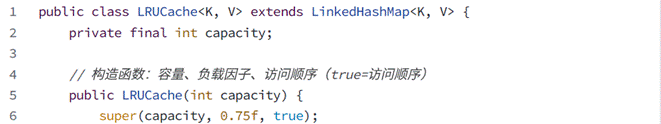
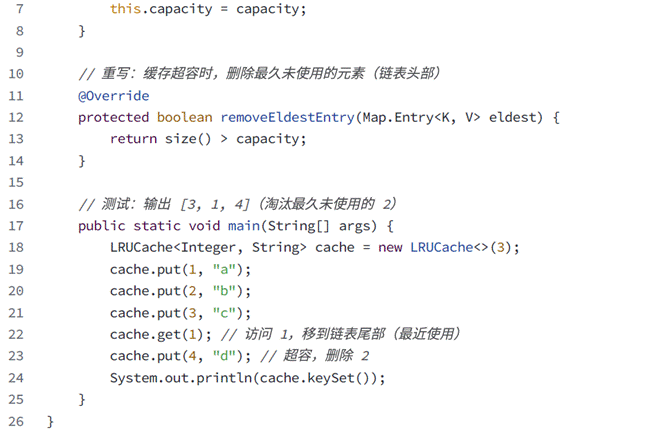
• 其他实现: + 双向链表(手动维护节点顺序, 已封装该逻辑,优先使用)。
4. 集合的线程安全实现方式有哪些?
• 方式 1:遗留同步集合(低效):、(全局锁);
• 方式 2:工具类包装(低效):
.(List)(给集合加锁包装);
• 方式 3:JUC 并发集合(推荐):、、(锁粒度细/无锁,高效);
• 方式 4:手动加锁(灵活但易出错): 或 包裹非线程安全集合。
5. 为什么线程不安全?如何解决?
• 不安全表现:
○ JDK1.7:多线程扩容导致链表死循环(CPU 100%);
○ JDK1.8:多线程 put 导致数据覆盖(同一索引位置同时插入);
• 解决方案:
a. 单线程场景:直接用 ;
b. 并发场景:用 (首选);
c. 简单场景:
.(new ())(低效,不推荐)。
五、集合选型建议(实战导向)
业务场景
推荐集合
原因
单线程、键值对、无序
效率高,支持 null
单线程、键值对、有序
保持插入/访问顺序,支持 LRU
单线程、键值对、排序
自然排序/自定义排序,支持范围查询
并发、键值对
高效线程安全,支持高并发
单线程、有序可重复、查询多
索引访问 O(1),效率高
单线程、有序可重复、增删多
首尾增删 O(1),实现 Deque
去重、无序
高效去重,基于
去重、有序
去重+插入顺序,开销略高于
去重、排序
去重+排序,基于
生产者-消费者模型
/
阻塞插入/获取,无需手动同步
读多写少、并发安全
读无锁高效,遍历安全
总结
Java 集合的核心是「结构决定特性」:数组(查询快)、链表(增删快)、红黑树(排序+高效查询)、哈希表(去重+高效读写),面试重点围绕底层结构、扩容机制、线程安全、去重排序展开。建议结合源码(如 的put()、 的grow())深入理解,同时通过实战(如 LRU 缓存、生产者-消费者)巩固应用,才能在面试中灵活应对
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » java queue length Java 集合 知识整理 和 面试

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码