双旋网络
Java 开发必看!多线程创建 3 种核心方式 + 2 种进阶方案讲透

Java 开发必看!多线程创建 3 种核心方式 + 2 种进阶方案讲透
作为 Java 开发,你是不是也遇到过这种情况?明明代码本地跑起来没问题,一上线就出现奇怪的线程安全问题 —— 要么数据计算错乱,要么接口响应突然变慢,排查半天发现,竟然是最开始创建多线程的方式选错了!
我之前帮同事排查过一个订单处理的 bug,明明单测时订单状态更新都正常,线上高峰期却总有几笔订单状态 “卡住”。最后定位到代码里java多线程程序,他用继承 类的方式创建线程,还在子类里加了共享变量,结果多线程并发时变量被反复覆盖,导致状态同步出了问题。其实如果最开始选实现 接口的方式,这类问题完全可以避免。
所以今天咱们就好好聊聊 Java 里创建多线程的那些事儿,从基础到进阶一次讲透,以后不管是做业务开发还是应对面试,都能少踩坑。
为啥多线程创建方式不能随便选?
在 Java 开发里,多线程几乎是绕不开的 —— 从处理异步任务(比如发送短信、生成报表),到应对高并发(比如秒杀接口、订单处理),都得靠多线程提高效率。但很多人刚开始学的时候,觉得 “能创建线程就行”,随便选一种写法就上手,却忽略了不同创建方式背后的设计逻辑和适用场景。
举个例子:如果你的需求是 “简单执行一个无返回值的异步任务”,用继承 类的方式确实快;但如果需要 “多个线程共享同一个任务逻辑”,比如多线程处理同一份文件的不同片段java多线程程序,那实现 接口才是更合理的选择 —— 要是这时候还硬用 类,不仅要重复写任务逻辑,还容易出现共享资源竞争的问题。
更关键的是,Java 里不同的多线程创建方式,还会影响后续的扩展性:比如继承 类后,就没法再继承其他类了(Java 单继承限制);而用接口实现的方式,后续还能灵活扩展其他功能。所以选对创建方式,不只是 “能不能跑通” 的问题,更是 “代码好不好维护、能不能应对复杂场景” 的关键。
从基础到进阶:5 种多线程创建方式,附代码示例和适用场景
接下来咱们逐个拆解 Java 里常用的 5 种多线程创建方式,每种都给上代码示例和明确的适用场景,你可以根据自己的需求直接套用。
1. 基础方式 1:继承 类
这是最直观的创建方式,只要新建一个类继承 ,重写 run () 方法,把要执行的任务写在 run () 里,然后调用 start () 方法就能启动线程。
代码示例:
// 1. 继承Thread类
class MyThread extends Thread {
    // 2. 重写run()方法,定义线程要执行的任务
    @Override
    public void run() {
        // 这里写具体的任务逻辑,比如打印线程名称和执行内容
        System.out.println("当前线程:" + Thread.currentThread().getName() + ",执行任务:处理简单异步逻辑");
    }
}
// 3. 调用start()启动线程
public class ThreadDemo {
    public static void main(String[] args) {
        MyThread thread1 = new MyThread();
        thread1.setName("任务线程1");
        thread1.start(); // 启动线程,会自动调用run()方法

        MyThread thread2 = new MyThread();
        thread2.setName("任务线程2");
        thread2.start();
    }
}
适用场景:适合简单的、无共享逻辑的单任务场景,比如单个异步通知、简单的日志打印。
注意点:因为 Java 是单继承,所以如果你的类已经继承了其他类(比如 类),就不能再用这种方式了;而且多个线程之间无法共享任务逻辑,每个线程都要新建一个子类实例。
2. 基础方式 2:实现 接口
这种方式是新建一个类实现 接口,同样重写 run () 方法,然后把这个 实例传给 类的构造方法,再调用 start () 启动。
代码示例:
// 1. 实现Runnable接口
class MyRunnable implements Runnable {
    // 2. 重写run()方法,定义共享任务逻辑
    @Override
    public void run() {
        // 多个线程会共享这个run()里的逻辑
        System.out.println("当前线程:" + Thread.currentThread().getName() + ",执行共享任务:处理文件片段");
    }
}
// 3. 把Runnable实例传给Thread,启动线程
public class RunnableDemo {
    public static void main(String[] args) {
        // 创建一个共享的Runnable实例
        MyRunnable sharedRunnable = new MyRunnable();

        // 多个线程共用同一个Runnable实例,共享任务逻辑
        Thread threadA = new Thread(sharedRunnable, "文件处理线程A");
        Thread threadB = new Thread(sharedRunnable, "文件处理线程B");

        threadA.start();
        threadB.start();
    }
}
适用场景:适合多个线程需要共享任务逻辑的场景,比如多线程处理同一份数据、分布式任务拆分;而且因为是实现接口,不影响类的继承关系,扩展性更强。
注意点:如果 实例里有共享变量,要注意线程安全(比如加 锁),避免数据错乱。
3. 基础方式 3:实现 接口(带返回值)
前面两种方式的 run () 方法都没有返回值java多线程程序,也没法抛出受检异常 —— 如果你的任务需要 “执行完返回结果”(比如计算一个复杂的数值、获取远程接口的返回值)Java 开发必看!多线程创建 3 种核心方式 + 2 种进阶方案讲透,那实现 接口就最合适了。
需要重写 call () 方法,这个方法可以返回泛型结果,还能抛出异常;不过 不能直接传给 ,得借助 类(它实现了 接口)来包装,最后再传给 启动。
代码示例:
import java.util.concurrent.Callable;
import java.util.concurrent.FutureTask;
// 1. 实现Callable接口,指定返回值类型(这里是Integer)
class MyCallable implements Callable {
private int taskId;
// 可以通过构造方法传参,比如任务ID
public MyCallable(int taskId) {
this.taskId = taskId;
}
// 2. 重写call()方法,带返回值和异常抛出
@Override
public Integer call() throws Exception {
System.out.println("当前线程:" + Thread.currentThread().getName() + ",执行计算任务" + taskId);
// 模拟任务执行耗时(比如复杂计算)
Thread.sleep(1000);
// 返回计算结果(比如任务ID*10)
return taskId * 10;
}
}
// 3. 用FutureTask包装Callable,启动线程并获取结果
public class CallableDemo {
public static void main(String[] args) throws Exception {
// 创建Callable实例
MyCallable callable1 = new MyCallable(1);
MyCallable callable2 = new MyCallable(2);
// 用FutureTask包装Callable,FutureTask兼具Runnable和Future的功能
FutureTask futureTask1 = new FutureTask(callable1);
FutureTask futureTask2 = new FutureTask(callable2);
// 启动线程
new Thread(futureTask1, "计算线程1").start();
new Thread(futureTask2, "计算线程2").start();
// 调用get()方法获取返回值(会阻塞,直到任务执行完成)
Integer result1 = futureTask1.get();
Integer result2 = futureTask2.get();
System.out.println("计算任务1结果:" + result1); // 输出10
System.out.println("计算任务2结果:" + result2); // 输出20
}
}适用场景:需要获取线程执行结果的场景,比如异步计算、远程接口调用、多任务结果汇总(比如统计多个数据源的数据后合并)。
注意点: 的 get () 方法会阻塞当前线程,直到任务完成,所以如果不需要立即获取结果,可以先做其他逻辑,最后再调用 get ();另外如果任务可能耗时很久,建议设置超时时间(get (long , unit)),避免一直阻塞。
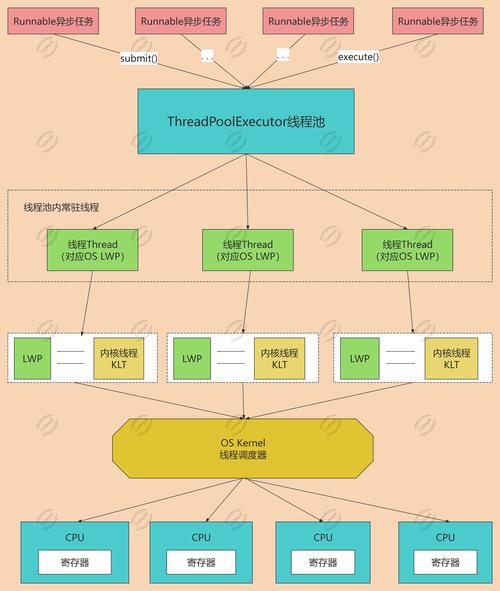
4. 进阶方式 1:线程池()
前面三种基础方式,每次创建线程都要 new (),但线程的创建和销毁是有开销的 —— 如果频繁创建线程(比如秒杀场景每秒几百个请求),会浪费大量资源,甚至导致线程数过多引发 OOM。
这时候就需要线程池了:线程池会预先创建一批线程,任务来了直接用空闲线程执行,任务结束后线程不销毁,放回池里复用。Java 里通过 框架实现线程池,常用的创建方式是 工具类,或者自定义 。
代码示例(用 创建固定大小线程池):
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
public class ThreadPoolDemo {
    public static void main(String[] args) {
        // 1. 创建固定大小的线程池(比如3个核心线程)
        ExecutorService threadPool = Executors.newFixedThreadPool(3);

        // 2. 提交任务(可以提交Runnable或Callable)
        for (int i = 1; i  {
                System.out.println("线程池线程:" + Thread.currentThread().getName() + ",执行任务" + taskId);
                try {
                    Thread.sleep(500);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            });
        }

        // 3. 关闭线程池(先停止接收新任务,等已提交任务执行完再关闭)
        threadPool.shutdown();
    }
}
适用场景:高并发、频繁创建线程的场景,比如接口请求处理、批量任务执行(比如定时同步数据)、秒杀系统;几乎所有生产环境的多线程场景,都推荐用线程池Java 开发必看!多线程创建 3 种核心方式 + 2 种进阶方案讲透,而不是手动 new 。
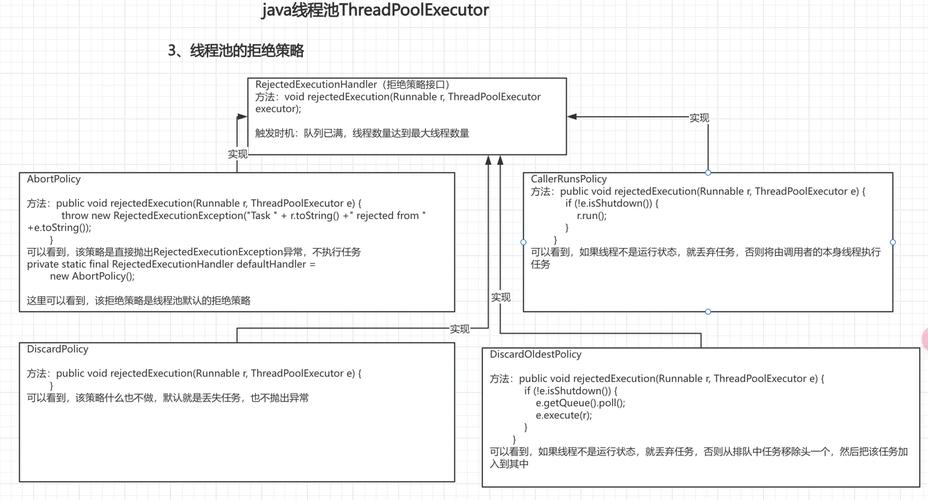
注意点: 工具类创建的线程池有默认参数,比如 可能创建过多线程导致 OOM,所以生产环境建议自定义 ,根据业务需求设置核心线程数、最大线程数、队列容量等参数;另外线程池一定要记得关闭,避免资源泄漏。
5. 进阶方式 2:Fork/Join 框架(并行计算)
如果你的任务可以拆分成多个 “子任务”,子任务执行完后再合并结果(比如计算 1 到 10000 的总和,可以拆成 10 个线程分别计算 1-1000、1001-2000…… 最后把结果加起来),那 Fork/Join 框架就很适合 —— 它是 Java 7 引入的,专门用于 “分而治之” 的并行计算场景。
Fork/Join 的核心是 类,通常我们会继承它的子类 (有返回值)或 (无返回值),重写 () 方法实现任务拆分和合并。
代码示例(用 Fork/Join 计算 1 到 n 的总和):
import java.util.concurrent.ForkJoinPool;
import java.util.concurrent.RecursiveTask;
// 1. 继承RecursiveTask(有返回值),指定返回值类型为Long
class SumTask extends RecursiveTask {
// 拆分阈值:当任务规模小于等于这个值时,直接计算,不拆分
private static final int THRESHOLD = 1000;
private long start;
private long end;
public SumTask(long start, long end) {
this.start = start;
this.end = end;
}
// 2. 重写compute()方法,实现任务拆分和合并
@Override
protected Long compute() {
long sum = 0;
// 判断任务是否需要拆分:如果规模小于阈值,直接计算
if (end - start <= THRESHOLD) {
for (long i = start; i <= end; i++) {
sum += i;
}
} else {
// 任务拆分:分成两个子任务
long mid = (start + end) / 2;
SumTask leftTask = new SumTask(start, mid);
SumTask rightTask = new SumTask(mid + 1, end);
// 执行子任务(fork()方法会异步执行子任务)
leftTask.fork();
rightTask.fork();
// 获取子任务结果并合并(join()方法会阻塞直到子任务完成)
long leftResult = leftTask.join();
long rightResult = rightTask.join();
sum = leftResult + rightResult;
}
return sum;
}
}
// 3. 用ForkJoinPool执行任务
public class ForkJoinDemo {
public static void main(String[] args) {
// 创建ForkJoinPool
ForkJoinPool forkJoinPool = new ForkJoinPool();
// 创建任务:计算1到10000的总和
SumTask sumTask = new SumTask(1, 10000);
// 提交任务并获取结果
Long totalSum = forkJoinPool.invoke(sumTask);
System.out.println("1到10000的总和:" + totalSum); // 输出50005000
// 关闭线程池
forkJoinPool.shutdown();
}
}适用场景:大规模并行计算场景,比如大数据量的统计分析(比如计算海量日志的指标)、复杂算法的并行实现(比如归并排序)、文件批量处理(比如遍历文件夹下所有文件并统计大小)。
注意点:任务拆分的阈值很关键 —— 阈值太大可能导致并行度不够,阈值太小会增加任务拆分和合并的开销,需要根据业务场景测试调整;另外 Fork/Join 框架会利用 CPU 的多核特性,适合 CPU 密集型任务,不适合 IO 密集型任务(IO 密集型用线程池更合适)。
总结:3 分钟快速选对多线程创建方式
最后咱们用一张表把 5 种方式的核心区别和适用场景汇总一下,以后遇到需求就能直接对号入座:
创建方式
核心特点
适用场景
注意事项
继承 类
单继承、无共享逻辑
简单异步任务、无返回值
不能继承其他类,避免共享变量
实现 接口
多实现、可共享逻辑
多线程共享任务、无返回值
共享变量需保证线程安全
实现 接口
带返回值、可抛异常
需获取任务结果(如异步计算)
.get () 会阻塞,建议设超时
线程池()
线程复用、高并发支持
频繁创建线程、IO 密集型任务(如接口处理)
生产环境建议自定义线程池参数
Fork/Join 框架
分而治之、并行计算
大规模 CPU 密集型任务(如大数据统计)
合理设置任务拆分阈值,避免过度拆分
其实 Java 多线程创建方式没有 “最好”,只有 “最合适”—— 比如做一个简单的日志异步打印,用 或 就够了;但如果是秒杀系统的订单处理,必须用线程池;如果是计算海量数据的指标,Fork/Join 才是最优解。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » Java 开发必看!多线程创建 3 种核心方式 + 2 种进阶方案讲透

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码