双旋网络
汇编语言:从“01代码”到“英语指令”人类如何“教会机器说话”

汇编语言:从“01代码”到“英语指令”人类如何“教会机器说话”
小邢哥 | 13年编程老炮,拆解技术脉络,记录程序员的进化史
汇编语言:从 “01 代码” 到 “英语指令”,人类如何第一次 “教会机器说话”
1947 年的某个清晨,美国阿伯丁试验场的计算机机房里,一名女程序员盯着桌上散落的打孔卡,突然蹲下身捂住了脸 —— 为了计算导弹的弹道轨迹,她已经连续三天在打孔卡上 “写” 代码:每一个 0 对应一张卡上的 “无孔”,每一个 1 对应 “有孔”,而刚刚她发现,第 37 张卡的一个小孔打错了位置,这意味着之前 36 张卡的工作全白费,整个程序要从头再来。
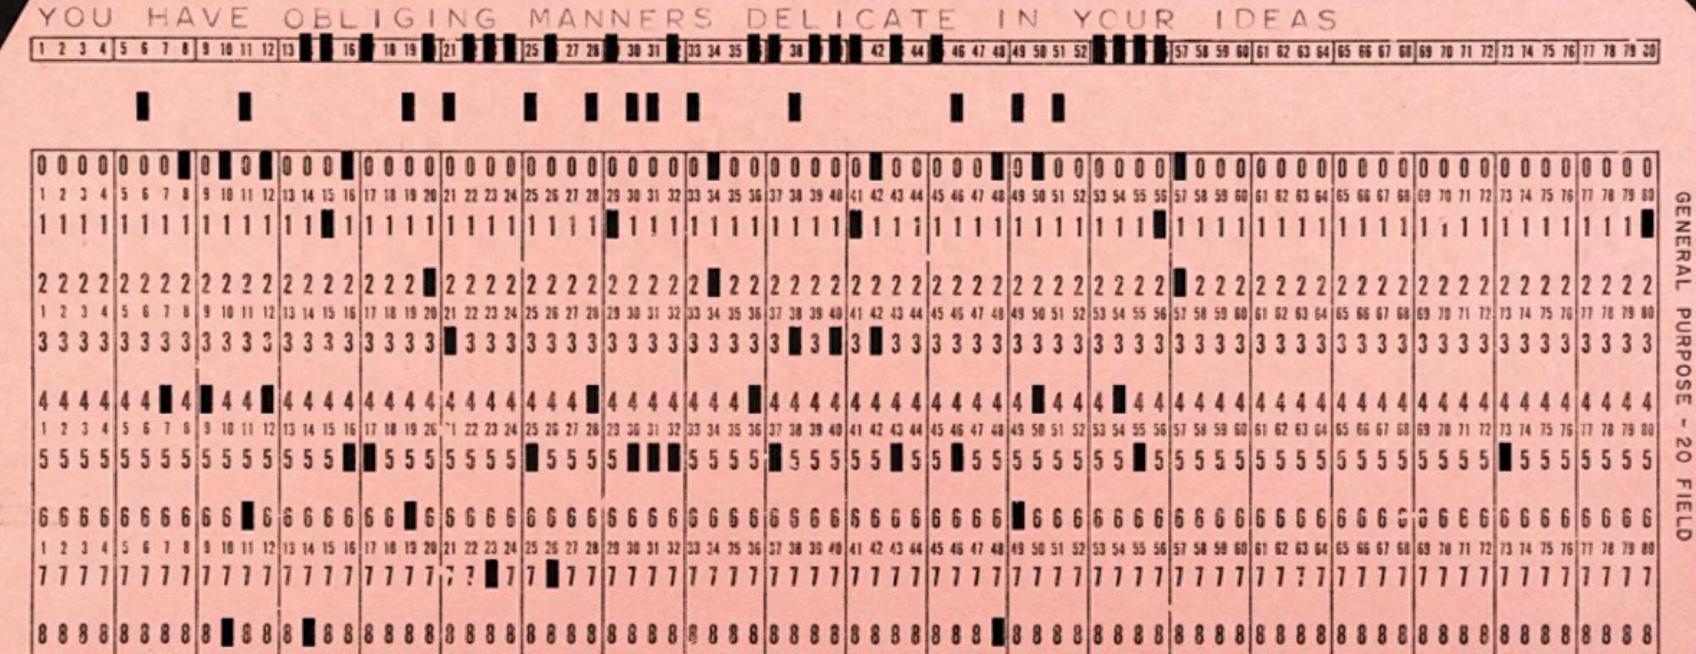
这位无名程序员的困境,是当时行业的缩影。二战结束后,计算机从战场走向科学计算(导弹轨迹、天气预报)与商业统计,但当时的 “编程”,本质上是和机器 “说二进制方言”—— 而汇编语言的诞生论文 程序设计语言历史与发展汇编语言:从“01代码”到“英语指令”人类如何“教会机器说话”,正是人类第一次尝试给机器 “编一本通用词典”,让编程从 “打孔卡灾难” 走向 “符号化表达”。
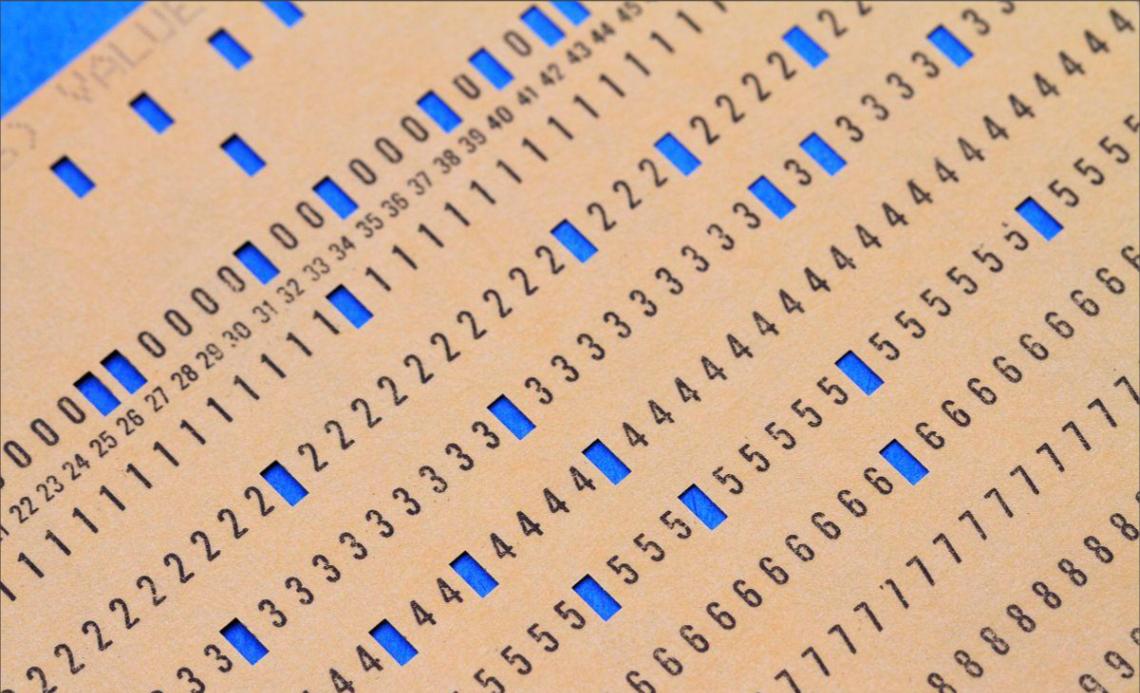
一、问题:机器语言的 “三座大山”汇编语言:从“01代码”到“英语指令”人类如何“教会机器说话”,逼得程序员 “用手算 01”
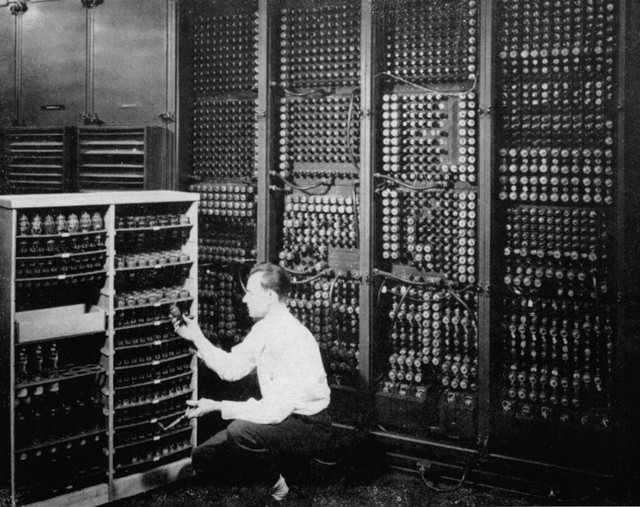
要理解汇编语言的价值,得先搞懂它解决了什么 “要命的问题”。二战后主流的计算机(如 ENIAC、),只能识别 “0” 和 “1” 组成的机器语言,这种语言对人类而言,相当于 “用摩斯电码写一篇博士论文”,有三座绕不开的大山:
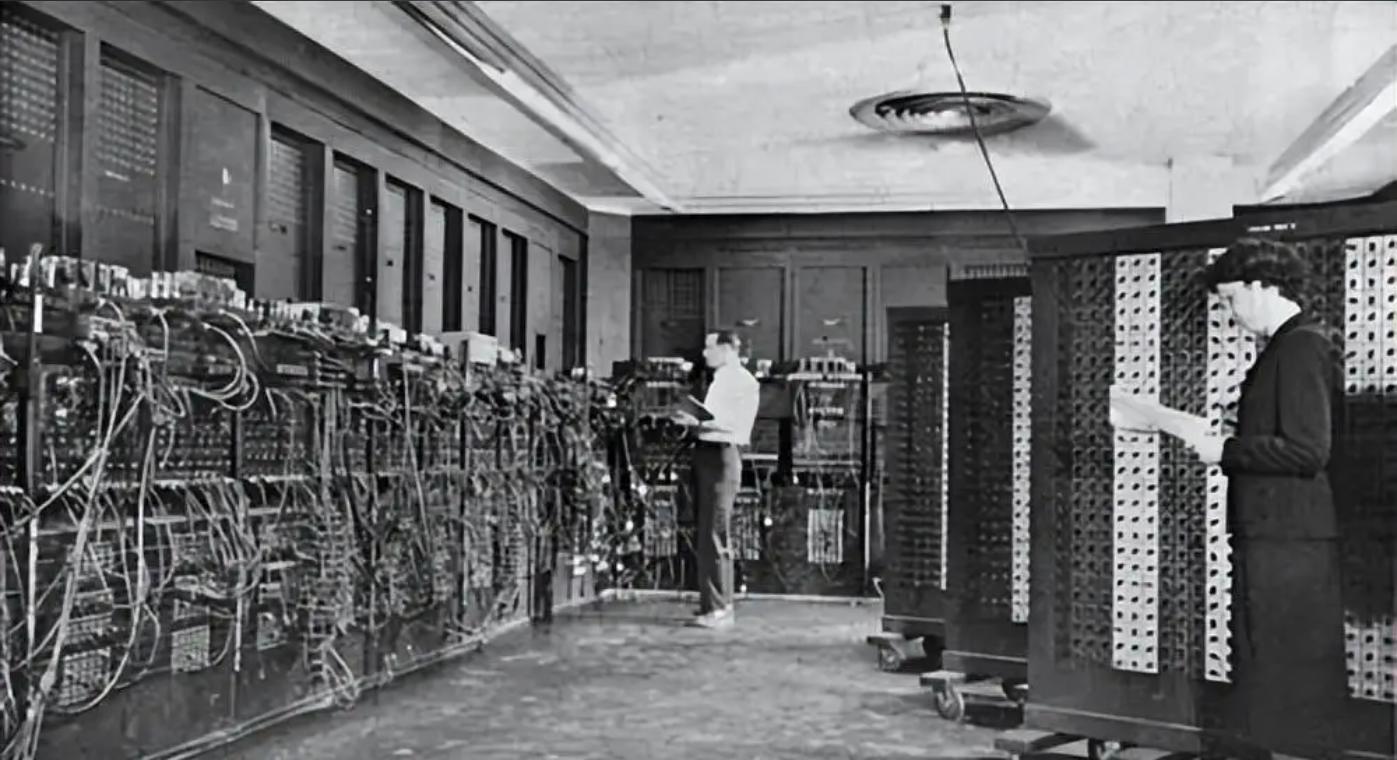
ENIAC
1. 记忆成本:要背下 “1001” 是 “加”,“1010” 是 “减”
机器语言里,每一条指令都是一串二进制数字:比如在 ENIAC 上,“1001 0011” 代表 “把寄存器 A 的数加到寄存器 B”,“1010 0100” 代表 “把寄存器 C 的数减去寄存器 D”。
程序员要先背下成百上千组 “数字 – 指令” 对应表,就像记一本没有规律的 “密码本”—— 有记载显示,1946 年 ENIAC 的首批程序员团队(包括凯瑟琳・麦克纳蒂、露丝・李希特曼等 6 名女性),平均每天要花 2 小时复习这些二进制指令,生怕写混。
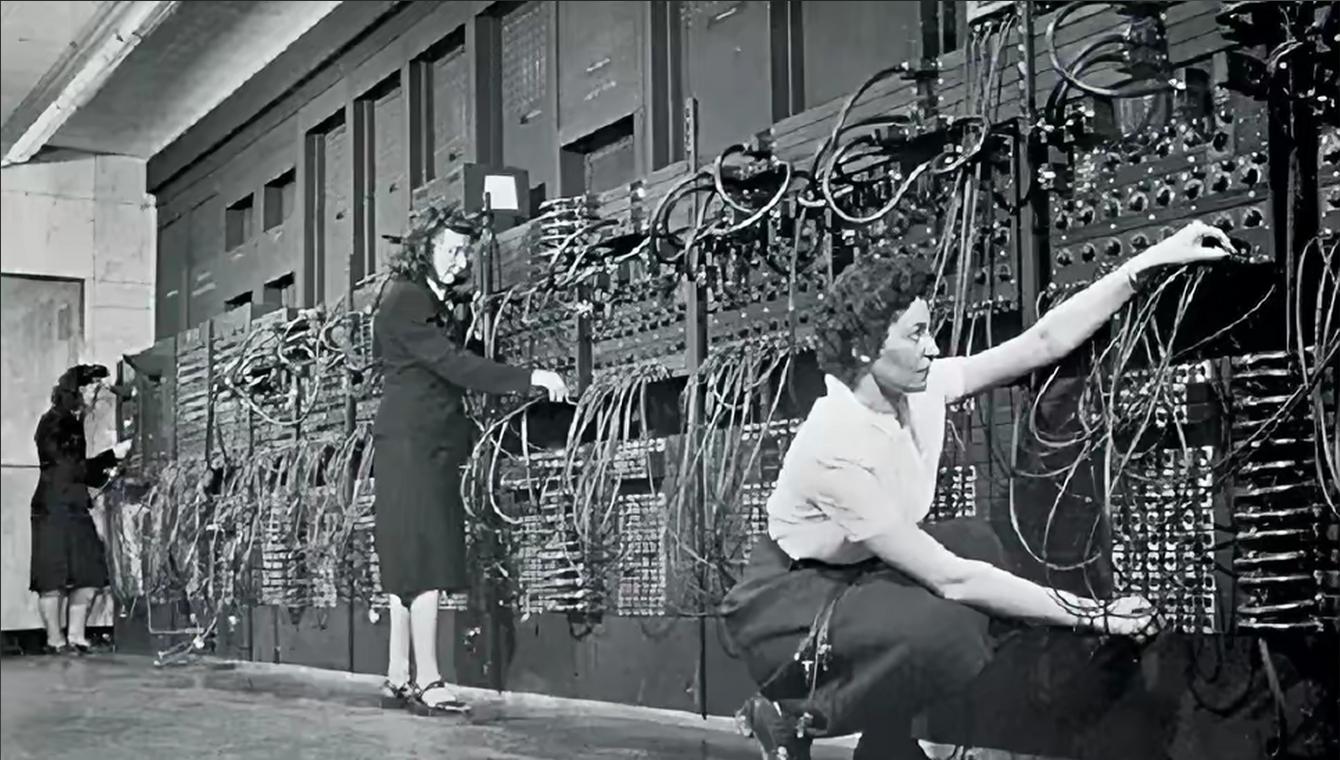
这里可以用一个生活类比:如果把计算机比作一台咖啡机,机器语言就是 “按第 1 个按钮 3 秒,再按第 5 个按钮 1 秒,再按第 2 个按钮 2 秒”(对应二进制指令),你必须精确记住每个按钮的时长和顺序,错一步就做出一杯难喝的咖啡;而我们想要的,是直接说 “我要一杯拿铁”(对应自然语言指令)。
2. 纠错地狱:错一个孔,整批卡全报废
当时的编程载体是 “打孔卡”:一张卡能存 80 位二进制(10 个字节),一个中等规模的弹道计算程序,需要几千张打孔卡。程序员用打孔机在卡上打小孔(代表 1)或留空白(代表 0),然后把卡按顺序塞进计算机读取。
但问题来了:只要有一张卡的一个孔打错(比如该打 1 的地方没打),计算机就会从这张卡开始报错,后面所有卡的指令都会 “错位”。
1948 年,美国陆军在计算 “红石导弹” 轨迹时,因为一张打孔卡多打了一个孔,导致程序运行了 8 小时后报错,程序员花了整整一天才找到这个错误 —— 相当于你写了一本 500 页的书,因为一个标点符号错了,要从头逐页检查。
3. 硬件绑定:换一台计算机,代码全作废
机器语言是 “跟硬件绑定的方言”:比如 IBM 701 的 “加法指令” 是 “0011”,而 I 的 “加法指令” 是 “1100”。
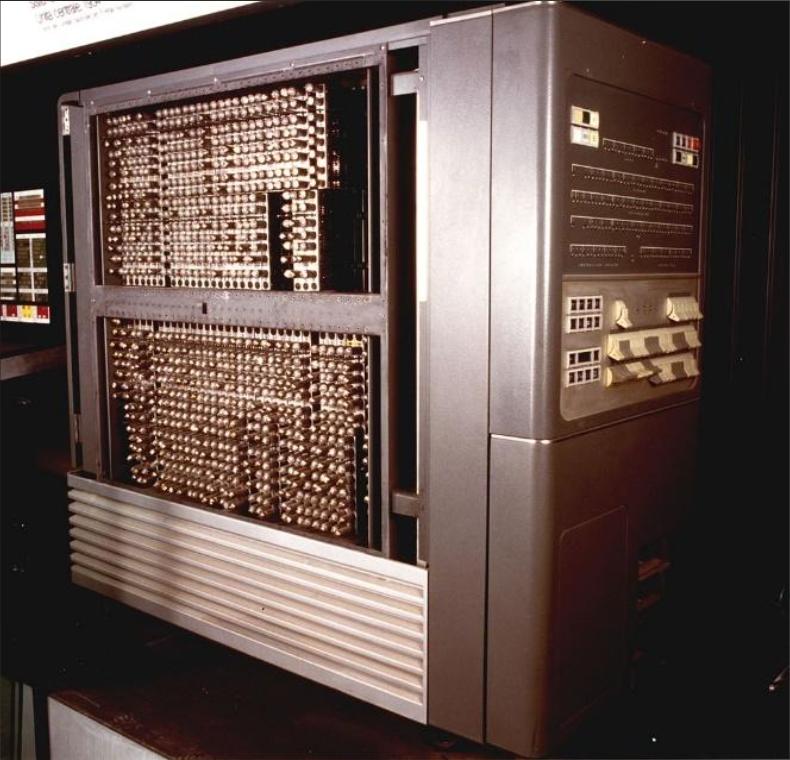
1949 年,麻省理工学院(MIT)的团队为 I 写了一个天气预报程序,当他们想把程序搬到 IBM 701 上时,发现所有二进制指令都要重写 —— 就像你用普通话写的剧本,要改成粤语版,不仅是换词,连句子结构都要重新调整。
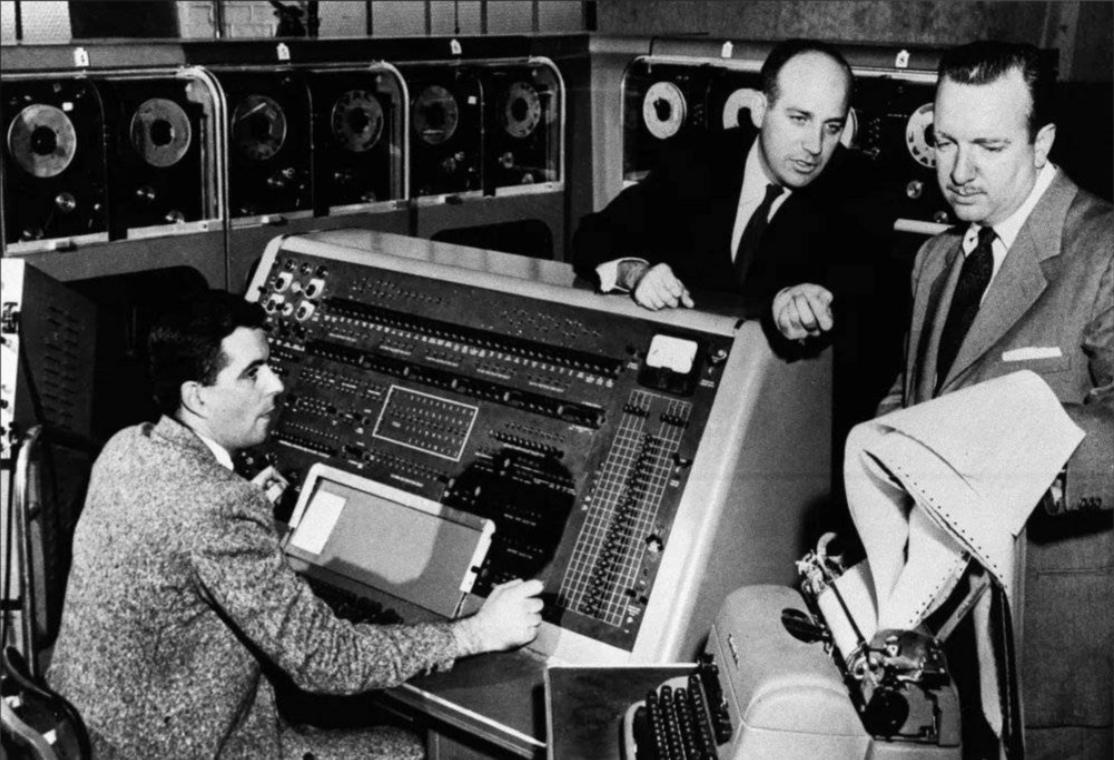
这三大问题导致:当时的程序员必须是 “硬件专家 + 记忆大师 + 耐心超人”,全美国能熟练编程的人不超过 200 个,远远满足不了科学计算和商业发展的需求 —— 计算机就像一台强大但 “难伺候” 的机器,急需一种 “更友好的沟通方式”。
二、解决方案:汇编语言的 “两大创新”论文 程序设计语言历史与发展,给机器 “编一本符号字典”
1947-1949 年,三个独立团队几乎同时想到了 “用符号代替二进制” 的思路,最终催生出汇编语言。
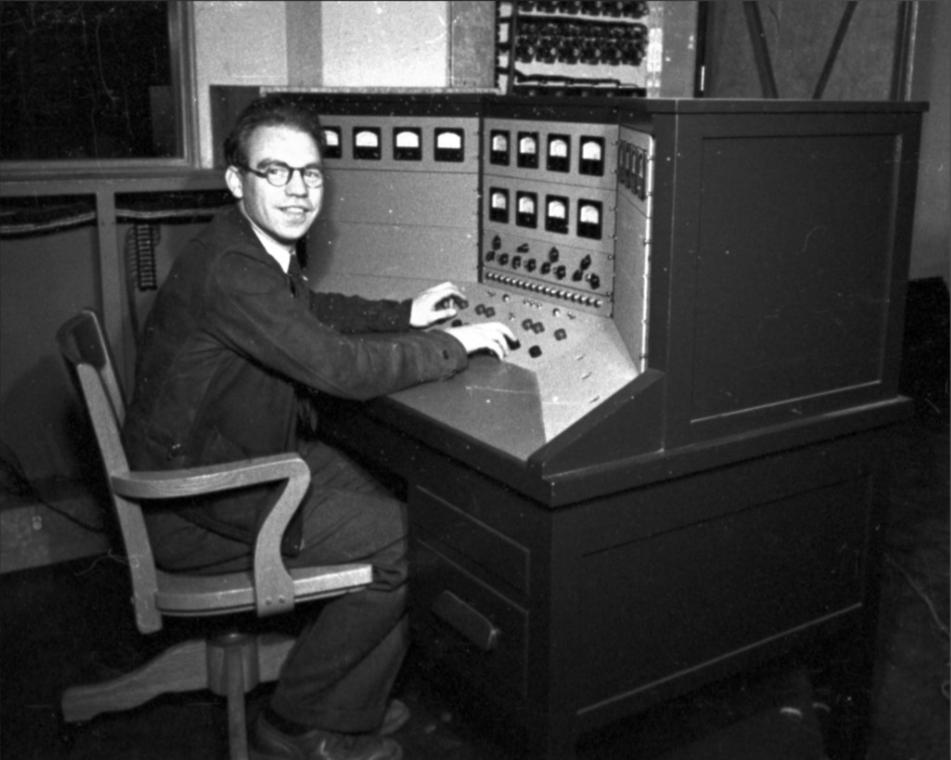
IBM 工程师约翰・巴克斯
其中最具代表性的,是 IBM 工程师约翰・巴克斯(John ,后来发明 )领导的 SSEC 项目团队,以及 MIT 的大卫・惠勒(David ,早期计算机科学先驱)等人组成的团队 —— 他们的核心创新是 “符号指令” 和 “汇编器”,相当于给机器语言 “加了一层翻译”。
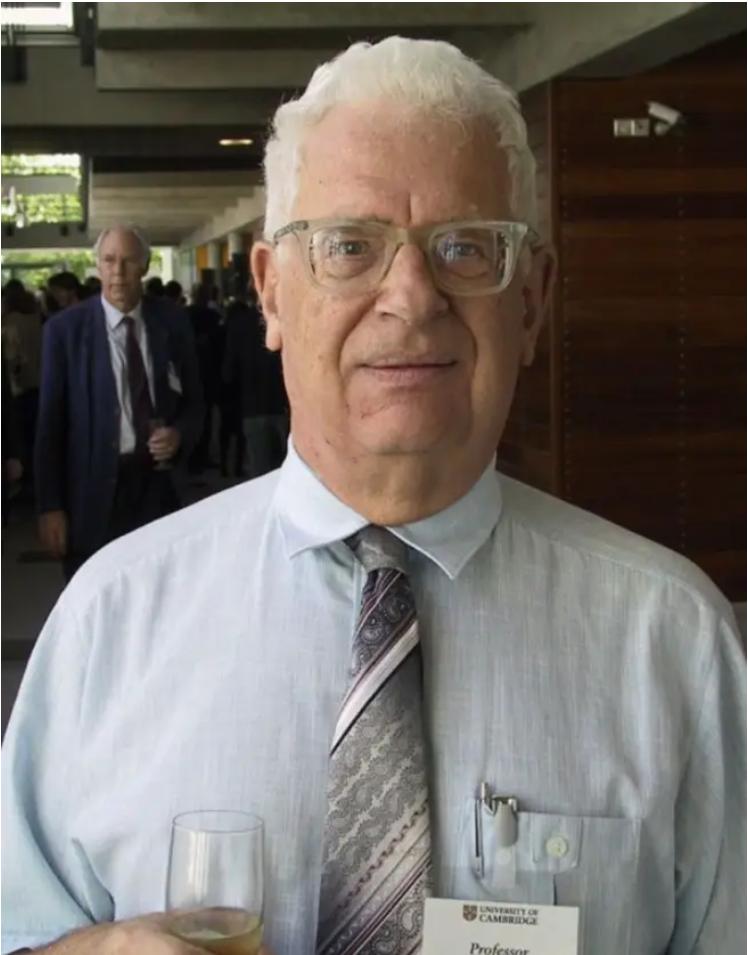
大卫・惠勒
1. 创新 1:用 “ADD” 代替 “1001”,给指令 “起英文名”
汇编语言的第一个突破,是把 “二进制指令” 换成 “英文缩写符号”:比如用 “ADD”( 的缩写)代替 “1001”(加法),用 “SUB”()代替 “1010”(减法),用 “MOV”(Move)代替 “1101”(数据移动)。同时,给寄存器、内存地址也起 “代号”,比如用 “A” 代表 “寄存器 A”,用 “VAR1” 代表 “第一个变量的内存地址”。
这样一来,原来的机器指令 “1001 0011”(把 A 加到 B),就变成了汇编指令 “ADD B, A”—— 是不是像从 “密码” 变成了 “简单英语句子”?这个类比更精准:如果机器语言是 “@#¥%&*”,汇编语言就是 “把 A 放进 B 里,再加上 C”,虽然还是 “机器的语法”,但人类终于能 “看懂” 了。
大卫・惠勒在 1949 年的技术文档中写道:“当我们第一次在纸上写下‘ADD A, B’,而不是‘1’时,突然觉得计算机不再是一台冷冰冰的机器 —— 它开始能‘听懂’我们简化后的指令了。” 这份文档现藏于 MIT 计算机科学与人工智能实验室(CSAIL),是早期汇编语言发展的关键史料。
2. 创新 2:发明 “汇编器”,让机器自己 “翻译符号”
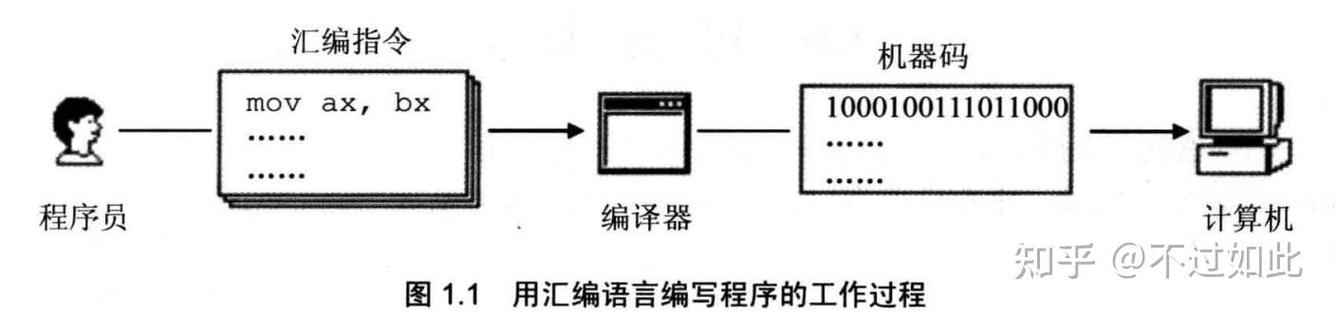
光有符号还不够 —— 计算机只认 0 和 1,所以需要一个 “翻译官”,把汇编指令转换成机器语言,这个 “翻译官” 就是 “汇编器”()。
第一个实用的汇编器,是 1949 年 IBM 为 SSEC 计算机开发的 “自动编码系统”( ):程序员在纸上写汇编代码(比如 “MOV A, 5”“ADD A, 3”),然后把代码输入到汇编器里,汇编器会做两件事:
这个过程就像你用翻译软件:你输入 “请给我一杯咖啡”(汇编指令),软件先查字典(符号表),把 “请”“给”“咖啡” 换成对应的外语单词,再调整语序(处理地址),最后输出完整的外语句子(机器语言)。
1950 年,SSEC 团队用汇编语言重写了之前的弹道计算程序:原来需要 3 个程序员写 2 周的机器语言代码,现在 1 个程序员 1 周就能写完汇编代码,纠错时间从 1 天缩短到 2 小时 —— 约翰・巴克斯在后来的访谈中提到,这次重构让 IBM 管理层第一次意识到 “符号化编程” 的价值,为后续 的研发争取到了资金支持。
三、历史细节:汇编语言的 “早期战场”,从导弹到天气预报
汇编语言的价值,在 1950 年代的 “关键场景” 中被彻底验证,其中两个故事最能体现它的 “革命性”,且涉及的人物均有明确史料记载:
1. 红石导弹项目:汇编让 “导弹轨迹计算” 效率翻 3 倍
1952 年,美国陆军正在研发 “红石导弹”,但早期用机器语言编程时,每次调整导弹的参数(比如燃料量、发射角度),都要重写 30% 的二进制代码,导致一次测试要等 2 周才能出结果。
后来,通用电气的程序员团队(核心成员包括霍华德・艾肯的学生小托马斯・沃森)用汇编语言重构了程序:他们把 “燃料量”“发射角度” 这些可变参数,用汇编的 “变量符号”(比如 “FUEL”“ANGLE”)表示,调整参数时,只需要改 “FUEL = 1500” 这样的句子,不用动其他指令。
结果测试周期从 2 周缩短到 5 天,效率直接翻了 3 倍 —— 项目负责人在 1953 年的《弹道研究报告》中写道:“汇编语言让我们从‘跟机器较劲’,变成了‘专注于导弹本身的问题’。” 这份报告现藏于美国陆军军事历史研究所。
2. 格蕾丝・霍珀的 “COBOL 前奏”:汇编教会机器 “懂商业”
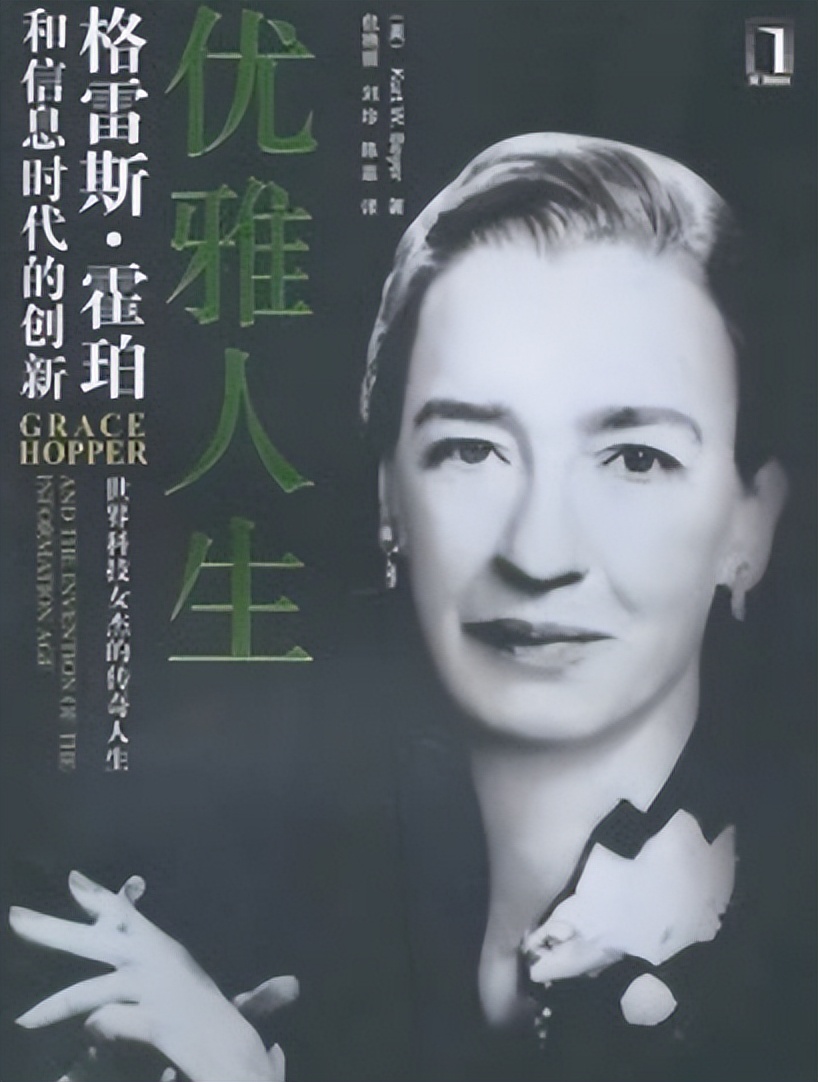
提到汇编语言,不能不提 “计算机科学之母” 格蕾丝・霍珀(Grace ,1906-1992)。1951 年,她在 项目团队工作时,发现商业计算(比如记账、库存统计)需要大量 “重复操作”(比如 “把每个员工的工资加起来”),而汇编语言的 “循环指令”(比如 “LOOP”)正好能解决这个问题。
霍珀团队为 开发了专用的商业汇编器 “FLOW-MATIC”(早期商业编程工具的雏形),用 “LOAD”(加载工资数据)、“ADD”(累加)、“STORE”(保存结果)这些指令,写了第一个商业记账程序。
更关键的是,她在汇编语言里引入了 “宏指令”(Macro )—— 比如把 “LOAD A, B; ADD A, C; STORE A, D” 这三条指令,定义成一个 “MACRO (D)”,下次用的时候直接写 “ (TOTAL)” 就行。
这个创新后来成了高级语言 “函数” 的核心思想,霍珀在 1958 年的《计算机程序设计语言》论文中回忆:“汇编语言让我意识到,机器不仅能算导弹轨迹,还能懂商业逻辑 —— 只要我们用它能理解的‘符号’,把逻辑讲清楚。”
而 FLOW-MATIC 的设计理念,也直接影响了 1959 年 COBOL(首个面向商业的高级语言)的诞生。
四、局限与影响:汇编是 “梯子”,不是 “终点”
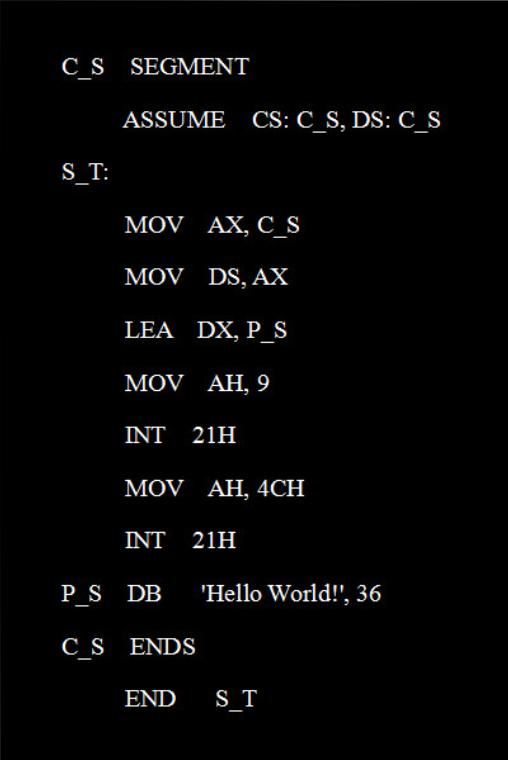
虽然汇编语言解决了机器语言的很多问题,但它有一个致命局限:仍然依赖硬件。比如在 IBM 704 上写的 “ADD A, B”,到了 II 上就变成了 “FAD A, B”(FAD 是 的加法指令缩写),程序员换一台计算机,还是要重新学习指令集 —— 就像你学会了英式英语,到了美国还是要适应美式英语的拼写和发音。
但正是这个 “不完美” 的解决方案,为后来的高级语言(比如 、COBOL)铺了路:汇编语言证明了 “用符号代替二进制” 的可行性,而它的 “硬件依赖” 痛点论文 程序设计语言历史与发展,又倒逼科学家思考:“能不能发明一种‘不跟硬件绑定’的语言,让程序员写的代码,在任何计算机上都能跑?”
1954 年,约翰・巴克斯带着这个问题,向 IBM 提交了 的研发提案 —— 他的团队花了 3 年时间,让 能直接识别 “Y = X*2 + 3” 这样的数学公式,不用再写 “MOV X, A; MUL A, 2; ADD A, 3; MOV A, Y” 这样的汇编指令。
莫里斯・威尔克斯
1957 年 4 月, 首次公开演示时,现场的科学家(包括后来的图灵奖得主莫里斯・威尔克斯)震惊了:有人当场说 “这不可能 —— 机器怎么能直接懂数学公式?”
而这次演示,标志着编程语言从 “面向机器” 正式迈向 “面向人类”。
结语:技术演变的本质,是 “让复杂的事变简单”
回顾汇编语言的历史,我们能看到技术发展的一个核心逻辑:每一次突破,都是为了解决上一个阶段的 “痛点”。
机器语言的痛点是 “难记、难改、难移植”,所以汇编语言用 “符号” 解决了 “难记”,用 “汇编器” 解决了 “难改”;而汇编语言的痛点是 “硬件依赖”,又催生了高级语言的 “跨平台” 需求。
今天的我们,写 时用 “print (“Hello”)”,写 Java 时用 “.out. (“Hello”)”,可能不会想到:这背后是 70 多年前,凯瑟琳・麦克纳蒂们在打孔卡前的反复试错,是约翰・巴克斯、格蕾丝・霍珀、大卫・惠勒们用 “符号” 一点点搭建起的 “人机沟通桥梁”。
汇编语言现在已经不是主流编程工具,但它的思想从未过时 —— 比如 Linux 内核的启动代码、嵌入式设备的驱动程序中,依然会用到汇编来操作硬件;而它 “简化复杂操作” 的思考方式,更是所有编程语言的 “共同基因”。
从 “01 代码” 到 “英语指令”,再到今天的 “自然语言编程”(比如 AI 生成代码),人类始终在做一件事:让机器更懂我们,而不是让我们更懂机器。
这,就是编程技术发展的终极意义。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » 汇编语言:从“01代码”到“英语指令”人类如何“教会机器说话”

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码