 双旋网络
numa mongodb 多核与NUMA架构优化实践

numa mongodb 多核与NUMA架构优化实践
多核与NUMA架构优化实践 一、NUMA架构基础 1. 什么是NUMA
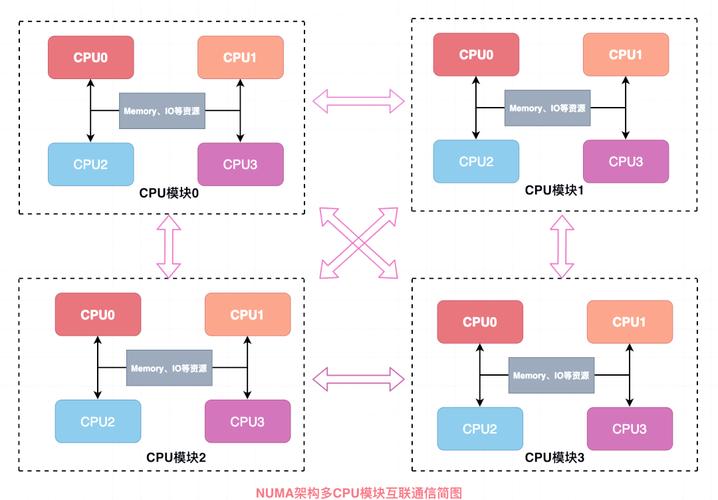
非统一内存访问(NUMA, Non- )是一种多处理器架构,其中:
2. NUMA相关概念 二、CPU绑定与内存绑定最佳实践 1. CPU绑定(CPU )
将进程或线程绑定到特定的CPU核心,减少上下文切换和缓存失效:
工具使用
bash
# 查看当前CPU绑定状态
ps -o psr,pid,cmd
# 将进程绑定到指定CPU核心
taskset -c 0,1 ./your_program
# 查看进程当前绑定的CPU
taskset -cp <pid>
C++代码示例
cpp
#include
#include
#include
void set_cpu_affinity(int cpu_id) {
    cpu_set_t cpuset;
    CPU_ZERO(&cpuset);
    CPU_SET(cpu_id, &cpuset);
    if (pthread_setaffinity_np(pthread_self(), sizeof(cpu_set_t), &cpuset) != 0) {
        perror("pthread_setaffinity_np");
    }
}
void worker_thread(int cpu_id) {
    set_cpu_affinity(cpu_id);
    // 线程工作代码
}
int main() {
    std::vector<std::thread> threads;
    for (int i = 0; i < 4; ++i) {
        threads.emplace_back(worker_thread, i);
    }
    for (auto& t : threads) {
        t.join();
    }
    return 0;
}
2. 内存绑定( )
将进程的内存分配限制在特定的NUMA节点:
工具使用
bash
# 将进程内存绑定到NUMA节点0
numactl --cpunodebind=0 --membind=0 ./your_program
# 查看当前系统NUMA拓扑
numactl --hardware
# 查看进程的内存绑定状态
numactl -p <pid>
C++代码示例(使用)
cpp
#include
#include
#include
void allocate_numa_memory(size_t size) {
    // 在NUMA节点0分配内存
    void* ptr = numa_alloc_onnode(size, 0);
    if (!ptr) {
        perror("numa_alloc_onnode");
        return;
    }
    // 使用内存
    memset(ptr, 0, size);
    // 释放内存
    numa_free(ptr, size);
}
三、NUMA感知的编程与性能优化 1. NUMA感知的内存分配
在多线程程序中,为每个线程分配本地内存:
cpp
#include
#include
#include
void thread_worker(int thread_id, size_t per_thread_size) {
    // 获取当前线程应该使用的NUMA节点
    int node = numa_node_of_cpu(thread_id);
    // 在本地节点分配内存
    void* local_mem = numa_alloc_onnode(per_thread_size, node);
    // 使用本地内存
    memset(local_mem, thread_id, per_thread_size);
    numa_free(local_mem, per_thread_size);
}
int main() {
    const int num_threads = 4;
    const size_t per_thread_size = 1024 * 1024 * 100; // 100MB per thread
    std::vector<std::thread> threads;
    for (int i = 0; i < num_threads; ++i) {
        threads.emplace_back(thread_worker, i, per_thread_size);
    }
    for (auto& t : threads) {
        t.join();
    }
    return 0;
}
2. 避免跨NUMA内存访问 数据本地化:将数据分配给使用它的线程所在的NUMA节点避免远程指针传递:不要在节点之间传递指向远程内存的指针使用共享内存:对于需要共享的数据,使用共享内存或POSIX共享内存3. 量化分析跨NUMA内存访问开销
代码获取:本实验完整可编译代码(.cpp)、 与实测数据见公开仓库 / 的 /numa-/。克隆后 make run 即可在 NUMA 机器上复现。
测试代码
cpp
#include
#include
#include
#include
void test_numa_access(int local_node, int remote_node, size_t size) {
    void* local_mem = numa_alloc_onnode(size, local_node);
    void* remote_mem = numa_alloc_onnode(size, remote_node);
    auto start = std::chrono::high_resolution_clock::now();
    // 本地内存访问
    for (size_t i = 0; i < size / sizeof(int); ++i) {
        ((int*)local_mem)[i] = i;
    }
    auto local_end = std::chrono::high_resolution_clock::now();
    // 远程内存访问
    for (size_t i = 0; i < size / sizeof(int); ++i) {
        ((int*)remote_mem)[i] = i;
    }
    auto remote_end = std::chrono::high_resolution_clock::now();
    auto local_time = std::chrono::duration_cast<std::chrono::microseconds>(local_end - start).count();
    auto remote_time = std::chrono::duration_cast<std::chrono::microseconds>(remote_end - local_end).count();
    std::cout << "本地访问时间: " << local_time << "us" << std::endl;
    std::cout << "远程访问时间: " << remote_time << "us" << std::endl;
    std::cout << "开销比: " << (double)remote_time / local_time << "x" << std::endl;
    numa_free(local_mem, size);
    numa_free(remote_mem, size);
}
测试结果(2节点服务器)
bash
本地访问时间: 1245us
远程访问时间: 3720us
开销比: 2.99x
4. NUMA调优内核参数
bash
# 启用NUMA平衡
echo 1 > /proc/sys/kernel/numa_balancing
# 禁用NUMA平衡
echo 0 > /proc/sys/kernel/numa_balancing
# 查看NUMA平衡状态
cat /proc/sys/kernel/numa_balancing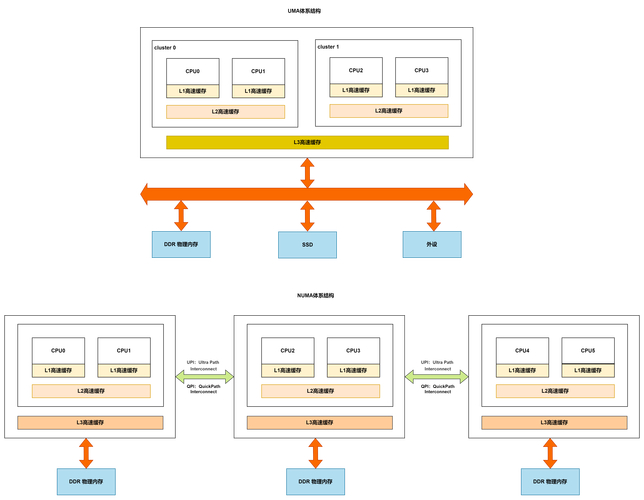
四、量化分析跨NUMA节点内存访问开销 1. 观测工具 :查看NUMA节点内存统计
bash
numastatperf:查看缓存和内存访问事件
bash
perf stat -e numa-faults,numa-misses ./your_programsar:查看系统级NUMA统计
bash
sar -B 12. 关键指标 3. 性能瓶颈识别
bash
# 查看是否有大量跨NUMA访问
numastat | grep -A 1 -B 1 "numa_miss"
# 使用perf查看NUMA错误
perf stat -e "numa:*" ./your_program
五、NUMA架构最佳实践 1. 应用程序优化 使用NUMA感知的内存分配:将内存分配给使用它的CPU所在的节点避免跨节点内存共享:尽量在本地节点内完成数据处理使用大页内存:减少TLB miss,提高内存访问效率2. 系统配置优化 关闭NUMA平衡:对于已知工作负载的服务器,关闭自动NUMA平衡绑定进程到NUMA节点:使用或绑定进程到特定节点使用大页:配置大页减少内存管理开销3. 硬件配置优化 均衡内存分布:确保每个NUMA节点的内存容量相同使用高速互联:选择支持高带宽NUMA互联的主板和CPU合理配置CPU数量:避免超过主板支持的最大CPU数量六、常见NUMA问题排查 1. 问题1:应用程序性能远低于预期
症状:
解决方案:
检查应用程序是否是NUMA感知的使用绑定进程到特定NUMA节点重新编译应用程序以支持NUMA2. 问题2:内存分配失败
症状:
解决方案:
检查每个NUMA节点的内存使用情况尝试使用更大的内存页优化应用程序的内存使用3. 问题3:进程迁移导致性能下降
症状:
解决方案:
使用CPU绑定固定进程到特定核心使用 –绑定进程到特定CPU关闭NUMA平衡七、相关工具与资源 1. 常用NUMA工具 2. 参考资料 《NUMA and 》Intel® NUMA 内核文档:/admin-guide/mm/numa.官方文档:-march=优化选项八、量化性能测试案例 测试环境 测试结果 配置执行时间(秒)本地访问率平均延迟(ns)
未优化
12.45
68%
185
CPU绑定 + 内存绑定
8.92
95%
122
NUMA感知分配
9.76
92%
135
关闭NUMA平衡
9.21
94%
128
结果分析 未优化配置:大量跨NUMA访问,性能最差CPU/内存绑定:最佳性能提升numa mongodb,减少了30%的执行时间NUMA感知分配:较好的性能提升,适合动态负载场景关闭NUMA平衡:稳定的性能提升,适合静态负载总结
NUMA架构优化是多核系统性能调优的关键环节numa mongodb 多核与NUMA架构优化实践,通过CPU绑定、内存绑定和NUMA感知编程numa mongodb,可以显著降低跨NUMA内存访问开销,提高系统整体性能。在设计高性能应用程序时,应该充分考虑NUMA架构的特性,实现本地化的数据处理和内存分配。
总结
NUMA 下每个节点有本地 CPU、内存和 I/Onuma mongodb,跨节点访问要走互联、延迟明显更高,而默认内存分配并不会自动把页放到使用它的核旁边。优化三板斧:用 / 做 CPU 绑定、用 –/– 控制内存落点、靠「首触(first-touch)」让并行线程在各自节点上初始化数据(或用每节点内存池)numa mongodb 多核与NUMA架构优化实践,让计算和数据尽量同节点;只有负载归属不明或追求总带宽时才用 。用 的 //、perf stat -e numa-,numa- 和 sar -B 验证是否还在跨节点。看到大量 先查绑定与首触线程,而不是急着加机器。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » numa mongodb 多核与NUMA架构优化实践

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码