双旋网络
JAVA解析XML文件

JAVA解析XML文件
XML文档解析的方式4种
1.SAX解析XML文件
2.DOM解析XML文件
3.JDOM解析XML文件
4.DOM4J解析XML文件
注意:XML文件的解析格式有两种:SAX解析和DOM解析(DOM , JDOM , DOM4J )
下面就介绍一下JDOM解析XML文件
步骤:
1.创建一个DOM解析器(文档生成器)工厂对象
2.通过工厂对象创建一个DOM解析器对象
3.解析文档
4.从内存中读取数据生成对象
特点:
1.基于树型结构,
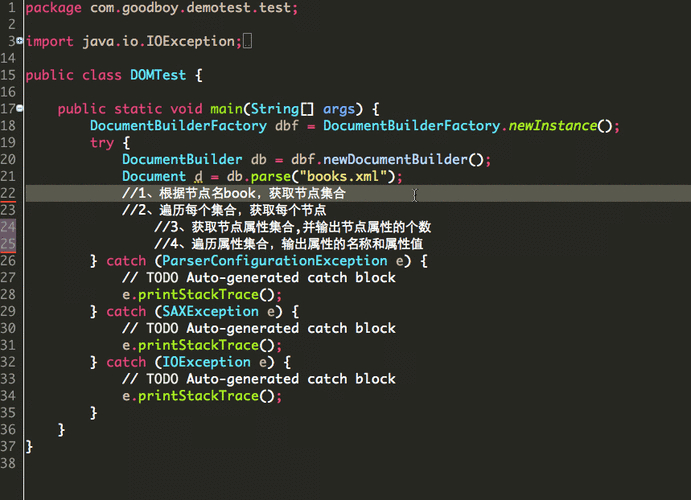
2.通过解析器一次性把文档加载到内存中,所以会比较占用内存,
3.可以随机访问,更加灵活,适合web端开发.
public void SSSXML() throws IOException, SAXException, ParserConfigurationException {
        //创建一个DOM解析器(文档生成器)工厂对象
        DocumentBuilderFactory documentBuilderFactory = DocumentBuilderFactory.newInstance();
        //通过工厂对象创建一个DOM解析器对象
        DocumentBuilder documentBuilder = documentBuilderFactory.newDocumentBuilder();
        InputStream resourceAsStream = Thread.currentThread().getContextClassLoader().getResourceAsStream("com\xml\person.xml");
        //此代码完成后,整个XML文档已经被加载到内存中,以树状形式存储;
        Document parse = documentBuilder.parse(resourceAsStream);
        //4.从内存中读取数据生成对象
        //获取节点名称为person的所有节点,返回节点集合.
        NodeList personNodeList = parse.getElementsByTagName("person");
        ArrayList persons = new ArrayList();
        Person person = null;
        //循环读取
        for (int i = 0; i < personNodeList.getLength(); i++) {
            Node personNode = personNodeList.item(i);
            person = new Person();
            //获取节点属性值;
            String personid = personNode.getAttributes().getNamedItem("personid").getNodeValue();
            person.setPersonid(personid);
            //获取当前节点的所有子节点
            NodeList childNodes = personNode.getChildNodes();
            for (int j = 0; j <childNodes.getLength() ; j++) {
                Node item = childNodes.item(j);
                String nodeName = item.getNodeName();
                if("name".equals(nodeName)){
                    person.setName(item.getFirstChild().getNodeValue());
                }else if("address".equals(nodeName)){
                    person.setTel(item.getFirstChild().getNodeValue());
                }
                else if("tel".equals(nodeName)){
                    person.setTel(item.getFirstChild().getNodeValue());
                }
                else if("fax".equals(nodeName)){
                    person.setFax(item.getFirstChild().getNodeValue());
                }
                else if("email".equals(nodeName)){
                    person.setEmail(item.getFirstChild().getNodeValue());
                }
            }
            persons.add(person);
        }
        System.out.println("结果:");
        for (Person person1 : persons) {
            System.out.println(person1);
        }
    }
DOM4J解析XML文件
步骤:
1.创建DOM4J解析器
2.解析文档
3.从内存中读取数据生成对象
特点:
1.基于树型结构
2.第三方组件
3.解析速度快,效率更高,使用JAVA中的迭代器进行数据读取,在web框架中使用较多,比如(框架)
首先创建一个XML配置文件(解析这个文件需要导入dom4j-1.6.1.jar包,具体版本可能有新旧之分)
2019-07-222019-07-22
下面就用这个XML文件实现增删改查
1.查询
package cn.kgc.dom4jtest;
import org.dom4j.Document;
import org.dom4j.DocumentException;
import org.dom4j.Element;
import org.dom4j.io.SAXReader;
import java.util.Iterator;
public class Test {
    public static void main(String[] args) {
           //创建DOM4J解析器对象
        SAXReader saxReader = new SAXReader();
        try {
            //读取xml文件,并生成document对象 现可通过document来操作文档
            Document document = saxReader.read("src/info.xml");
            //获取到文档的根节点
            Element rootElement = document.getRootElement();
            System.out.println("根节点的名字是:" + rootElement.getName());
            //获取子节点列表
            Iterator it = rootElement.elementIterator();
            while (it.hasNext()) {
                Element fistChild = (Element) it.next();
                //System.out.println(fistChild.getName());
                //获取节点的属性值
                System.out.println(fistChild.attribute("name").getValue());
                //获取子节点的下一级节点
                Iterator iterator = fistChild.elementIterator();
                while (iterator.hasNext()) {
                    Element element = (Element) iterator.next();
                    System.out.println("t" + element.attributeValue("name"));
                }
            }
        } catch (DocumentException e) {
            e.printStackTrace();
        }
    }
}
2.添加
package cn.kgc.dom4jtest;
import org.dom4j.Document;
import org.dom4j.Element;
import org.dom4j.io.SAXReader;
import org.dom4j.io.XMLWriter;
import java.io.File;
import java.io.FileOutputStream;
import java.io.OutputStream;
public class AddTest1 {
    /**
     * 添加节点操作
     * @param args
     */
    public static void main(String[] args) {
        //创建DOM4J解析器对象
        SAXReader saxReader = new SAXReader();
        try {
            Document document = saxReader.read("src/info.xml");
            //获取到根节点
            Element rootElement = document.getRootElement();
            //添加一个子节点
            Element brand = rootElement.addElement("brand");
            //给当前节点添加属性
            brand.addAttribute("name", "魅族");
            Element type = brand.addElement("type");
            type.addAttribute("name", "s16");
            OutputStream os = new FileOutputStream(new File("src/info.xml"));
            XMLWriter xmlWriter = new XMLWriter(os);
            xmlWriter.write(rootElement);
            xmlWriter.flush();
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
3.修改
package cn.kgc.dom4jtest;
import org.dom4j.Document;
import org.dom4j.Element;
import org.dom4j.io.SAXReader;
import org.dom4j.io.XMLWriter;
import java.io.File;
import java.io.FileOutputStream;
import java.util.Iterator;
/**
 * 节点修改测试
 */
public class UpdateTest {
    public static void main(String[] args) {
        //创建DOM4J解析器对象
        SAXReader saxReader = new SAXReader();
        try {
            Document document = saxReader.read("src/info.xml");
            //获取根节点
            Element rootElement = document.getRootElement();
            Iterator it = rootElement.elementIterator();
            while (it.hasNext()) {
                Element element = (Element) it.next();
                System.out.println(element.attributeValue("name"));
                if (element.attributeValue("name").equals("魅族")) {
                    Iterator iterator = element.elementIterator();
                    while (iterator.hasNext()) {
                        Element type = (Element) iterator.next();
                        if (type.attributeValue("name").equals("s16")) {
                            type.addAttribute("name", "16 pro");
                        }
                    }
                }
            }
            XMLWriter xmlWriter = new XMLWriter(new FileOutputStream(new File("src/info.xml")));
            xmlWriter.write(document);
            xmlWriter.flush();
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
4.删除
package cn.kgc.dom4jtest;
import org.dom4j.Document;
import org.dom4j.Element;
import org.dom4j.io.SAXReader;
import org.dom4j.io.XMLWriter;
import java.io.File;
import java.io.FileOutputStream;
import java.util.Iterator;
/**
 * 删除节点测试
 */
public class DeleteTest {
    public static void main(String[] args) {
        SAXReader saxReader = new SAXReader();
        try {
            Document document = saxReader.read("src/info.xml");
            Element rootElement = document.getRootElement();
            Iterator iterator = rootElement.elementIterator();
            while (iterator.hasNext()) {
                Element brand = (Element) iterator.next();
                if ("魅族".equals(brand.attributeValue("name"))) {
                    //通过父节点来删除子节点
                    brand.getParent().remove(brand);
                }
            }
            XMLWriter xmlwriter = new XMLWriter(new FileOutputStream(new File("src/info.xml")));
            xmlwriter.write(document);
            xmlwriter.flush();
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
公告:
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » JAVA解析XML文件
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » JAVA解析XML文件

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码