双旋网络
java xml处理技术一(解析xml和生存xml的技术)

java xml处理技术一
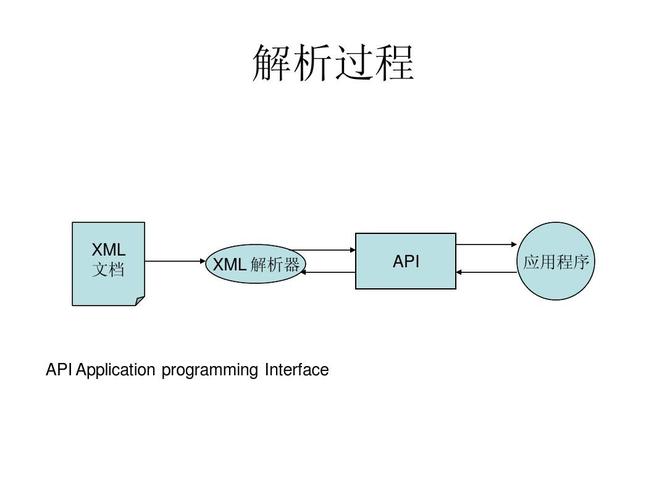
XML 技术是随着 Java 的发展而发展起来的。在 XML 出现之前对于简单的数据格式通常是存储在 ini 配置文件等文本文件中,复杂的格式则采用自定义的文件格式,因此对于每种文件格式都要有专门的解析程序。 XML 出现以后解决了这个问题,程序面对的是有固定格式的 XML 文件,只要通过标准 API 就可以进行 XML 文件的处理。
XML 文件在案例系统中应用是很广泛的,比如 .xml 、 .xml 文件就是使用 XML 文件来做配置文件的,元数据文件以及元数据加载器更是离不开 XML 。因此本章将系统讲解一下 XML 文件的处理技术。
1.1 XML处理技术比较
在 Java 领域 XML 文件的技术大致分为两类: XML API 和 。 XML API 是 XML 处理的基础,可选技术包括 JDOM 、 Dom4j 等; 是 -XML 的简称,这种技术隐藏了 XML 底层操作的细节,可以将 XML 文件映射成一个 对象,也可以把一个 对象保存成一个 XML 文件,可选技术 、 、 等。 XML API 和 的关系类似于 JDBC 和 的关系, 内部实现使用 XML API 来完成,两种实现技术从不同的层面实现了 XML 的处理。
XML API
此类 XML 处理技术中最流行的莫过于 JDOM 和 Dom4j 了,二者的使用方式非常相似。不过 Dom4j 的优势比JDOM 更明显一些:
Dom4j 大量的使用接口,这使得 Dom4j 比 Dom4j 更加灵活和具有可扩展性;
Dom4j 的性能表现比 JDOM 好;
Dom4j 支持 XPath 等高级特性;
正是由于这些优点,很多开源项目都开始使用 Dom4j 做 XML 解析技术,本书也将使用 Dom4j 做为 XML 处理的首选。
使用 XML API 解析是略显烦琐的,受 技术的启发,人们发明了 技术,使用 技术,我们可以将 XML 文件映射成一个 对象,也可以把一个 对象保存成一个 XML 文件,这大大简化了我们的开发工作量,使得开发人员能更多的关注应用层面的东西。
开源世界中涌现出很多 框架,包括 、 、 等。 和 把映射的过程在代码中完成,而 则需要写一个和 中 cfg.xml 类似的映射配置文件。与 比起来, 的主要优点就是更加小巧,使用也更加方便,不过目前使用 是“开源名牌” 下的子项目,网上可以参考的资料也比 多,好在 比较简洁,所以并不会对 造成太大影响。
1.2 Dom4j的使用
Dom4j 是一个易用的、开源的库,用于 XML , XPath 和 XSLT 。它应用于 Java 平台,采用了 Java 集合框架并完全支持 DOM , SAX 和 JAXP 。 Dom4j 是 上的一个开源项目,地址为 。
Dom4j 里基于接口编程是一个非常显著的优点,下面是其主要的接口的继承体系结构图:
图 5 . 1
这些接口大部分都是定义在包 org.dom4j 中,下面简单介绍各个接口的意义:
表 5 . 1 Dom4j 主要接口
Node
Node 为是 dom4j 中所有的 XML 节点的基类型接口
定义了 XML 的属性
为能够包含子节点的节点如 XML 元素 () 和文档 () 定义了一个公共的行为
定义了 XML 文档
定义 XML 元素
定义 XML 声明
定义 XML
是一个标识借口,标识基于字符的节点。如CDATA , , Text
CDATA
CDATA 定义了 XML CDATA 区域
定义了 XML 注释的行为
Text
Text 定义 XML 文本节点
n 定义 XML 处理指令
读取 XML 文件
在 XML 应用中,最常用的莫过于 XML 文件的解析读取了, Dom4j 提供了多种读取 XML 文档的方式,包括 Dom树遍历、 方式和 XPath 方式。
无论哪种方式,我们首先都要根据 xml 文件构造一个 对象:
= new ();
= .read(new File());
这里我们选用了 做为 XML 读取器,我们同样也可以选择 做为 XML 读取器:
= new ();
= .read(new File());
其中 的 read 方法有多个重载方法,可以从 , File, URL 等多种不同的源来读取 XML 文档。
( 1 ) Dom 树遍历
这种读取方式中把 Dom 看成一个普通的树,要读取 XML 中某个节点的值,只要采用数据结构中的树遍历算法定位到需要读取的节点即可。
要便利 Dom 树,首先要取得树的根节点:
root = .();
取得根节点以后就可以一级一级的向下读了:
// 遍历所有子节点
for ( i = root.(); i.(); )
= () i.next();
// do
// 遍历名称为“ foo ”的节点
for ( i = root.( “ foo ” ); i.();)
foo = () i.next();
// do
// 遍历属性
for ( i = root.(); i.(); )
= () i.next();
// do
( 2 ) 方式
Dom 树遍历是最普通,也是最常用的 XML 读取方式,其他的 XML 解析引擎,比如 JDom 等,也是使用这种方式进行 XML 的读取。不过 Dom4j 提供了另外一种读取方式,那就是 方式。这种方式实现了 模式,调用者只要编写一个 就可以了。 模式使得访问者易于增加新的操作,同时使访问者集中相关的操作而分离无关的操作。
编写的 必须实现 org.dom4j. 接口, Dom4j 还提供了一个 模式的默认适配器org.dom4j. 。
class
void visit( )
.out.(.());
void visit( attr)
.out.(attr.());
然后在要开始遍历的节点调用此 即可:
root.(new ())
此方式需要遍历所有的节点和元素,因此速度会稍慢一些。
( 3 ) XPath 方式
Dom4j 最吸引人的特性莫过于对 XPath 的集成支持了,这个特性并不是所有的 XML 解析引擎都支持的,但是确实一个非常有用的特性。
XPath 是寻址、搜索和匹配文档的各个部分的语言。它使用路径标记法来指定和匹配文档的各个部分java获取xml解析器,该标记法与文件系统和 URL 中使用的类似。例如, XPath:/x/y/z 搜索文档的根节点 x ,其下存在节点 y ,其下存在节点 z。该语句返回与指定路径结构匹配的所有节点。 /x/y/* 返回父节点为 x 的 y 节点下的任何节点。 /x/y匹配所有父节点为 x 的 y 节点,其属性称为 name ,属性值为 a 。
XPath 大大简化了 XML 的寻址操作,使用者只要通过匹配表达式告诉引擎要匹配文档的哪些部分即可,具体的匹配工作由 XPath 引擎来完成。这种方式更加接近于人类的自然思维方式。我们来看一个实际的例子:
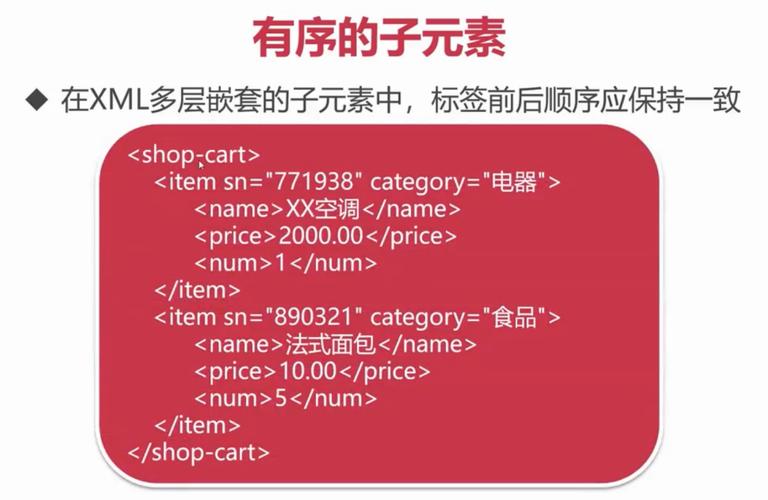
有一个 XML 文件记录了一个部门的基本情况:
开发部
name 代表部门名称, level 为部门的级别java获取xml解析器, 下是部门所有的员工列表。下面编写一个程序读取此文件并打印出部门的信息。
代码 5 . 1 XPath 演示
= null;
try
= .class.(
“/com///.xml”);
= new ();
doc = .read(new ());
Node = doc.(“///name”);
.out.(” 部门名称 :” + .());
Node = doc.(“///level”);
.out.(” 部门级别 :” + .());
List = doc
.(“////”);
.out.(” 部门下属雇员 :“);
for (int i = 0, n = .size(); i < n; i++)
= ()
.get(i);
name = .(“name”);
= .(“”);
.out.(name + ” ,工号 :” + );
}
.close();
运行结果 :
部门名称 : 开发部
部门级别 :2
部门下属雇员 :
Tom ,工号 :001
Jim java xml处理技术一(解析xml和生存xml的技术),工号 :002
Lily java获取xml解析器,工号 :003
使用 XPath 以后,我们只要使用“ ///name ”这种非常清晰的方式就可以直接定位到具体的节点。XPath 方式中定位单个节点使用 方法,而定位多节点则使用 方法。
案例系统中所有的 XML 文件都是使用 XPath 方式进行解析的,包括 .java 、 .java 、.java 等。
XML 文件的创建
Dom4j 中 XML 文件的创建和其他的 XML 引擎类似,首先以 的根节点为基础构造出一棵节点树,然后调用相应的 IO 类库就可以将 XML 文件保存到适当的介质中了。
下面演示一下生成上文提到的那个部门信息 XML 文件的过程 :
代码 5 . 2 XML 创建演示
java.io.;
java.io.;
org.dom4j.;
org.dom4j.;
org.dom4j.;
org.dom4j.io.;
org.dom4j.io.;
class
void main( args)
// 创建文档对象
= .();
// 添加根节点 “”
= .(“”);
// 添加 “name” 节点
= .(“name”);
.(” 开发部 “);
.add();
// 添加 “level” 节点
= .(“level”);
.(“2”);
.add();
// 添加员工列表 “” 节点
=
.(“”);
.add();
// 添加员工节点 “”
= .(“”);
.(“”, “001”);
.(“name”, “Tom”);
.add();
= .(“”);
.(“”, “002”);
.(“name”, “Jim”);
.add();
= .(“”);
// 添加属性
.(“”, “003”);
.(“name”, “Lily”);
.add();
try
(, “c:/.xml”);
} catch ( e)
e.();
void ( , file)
// 美化格式
= .();
.(“”);
= null;
try
= new (new (file), );
.write();
}
if ( != null)
.close();
运行以后就可以在 c:/ 下发现生成了和 5.2.1 的文件内容一样的 .xml 了。
这里有两点需要注意的:
( 1 ) = .()
XML 通常是需要人阅读的, Dom4j 默认的生成格式是紧缩格式的,这样可以减少空间占用,但是带来的缺点就是文件格式非常难看,因此我们采用锁紧格式进行输出。
( 2 ) .(“”)
将夜
Dom4j 默认的编码格式是“ UTF-8 ”,这在输出中文字符的时候会有问题java xml处理技术一(解析xml和生存xml的技术),因此我们改成“ ”格式。
这里使用了 Dom4j 提供的工具类 提供的 方法来创建一个节点,这个工具类还有 CDATA ( text) 、 ( text) 、 ( name, text) 等方法可以帮助我们更快的创建节点。 还提供了 方法,可以直接将字符串解析成 对象。
1. 本站所有资源来源于用户上传和网络,如有侵权请联系站长!
2. 分享目的仅供大家学习和交流,您必须在下载后24小时内删除!
3. 不得使用于非法商业用途,不得违反国家法律。否则后果自负!
4. 本站提供的源码、模板、插件等等其他资源,都不包含技术服务请大家谅解!
5. 如有链接无法下载、失效或广告,请联系站长处理!
6. 本站不售卖代码,资源标价只是站长收集整理的辛苦费!如果您喜欢该程序,请支持正版软件,购买注册,得到更好的正版服务。
7. 站长QQ号码 2205675299
资源库 - 资源分享下载网 » java xml处理技术一(解析xml和生存xml的技术)

常见问题FAQ
- 关于资源售价和售后服务的说明?
- 代码有没有售后服务和技术支持?
- 有没有搭建服务?
- 链接地址失效了怎么办?
- 关于解压密码